Ein gutes YouTube-Voiceover erledigt einen stillen, aber wichtigen Job: Es hält die Zuschauer im Video. Kaum jemand lobt eine Erzählstimme, aber die Leute klicken weg, sobald sie gehetzt, flach oder anders als im Video von letzter Woche klingt. Für die meisten Kanäle ist diese Stimme zugleich das Teuerste an der ganzen Produktion, denn jede Skriptänderung bedeutet eine weitere Aufnahmesession.
KI-Voiceover verändert diese Rechnung. Mit einem Text-zu-Sprache-Modell, das Anweisungen folgt, schreibst du das Skript, wählst einen Sprecher, beschreibst, wie die Zeile vorgetragen werden soll, und generierst das Audio in Minuten. Ein Satz muss korrigiert werden? Dann generierst du genau diesen Satz neu. So veröffentlichst du zweimal pro Woche, ohne ein Tonstudio zu buchen.
Dieser Leitfaden führt durch den kompletten Workflow: was ein Voiceover professionell klingen lässt, wie du eine Stimme für deinen Kanal auswählst, wie du Ton und Tempo in ganz normaler Sprache führst, wie du über jeden Upload hinweg eine wiedererkennbare Stimme behältst und wo die Regeln von YouTube ins Spiel kommen. Die Beispiele nutzen BreezeBlue Text-zu-Sprache, die Prinzipien gelten aber für jedes moderne KI-Sprecher-Tool.
Warum YouTube-Creator auf KI-Voiceovers umsteigen
Klassische Sprachaufnahmen sind eine Kette kleiner Kosten. Du brauchst einen ruhigen Raum, ein anständiges Mikrofon, ein paar Takes pro Absatz und anschließend den Schnitt, um Atmer, Klicks und den Satz zu entfernen, über den du gestolpert bist. Ändert sich das Skript nach dem Schnitt, nimmst du erneut auf und versuchst, Energie und Mikrofonabstand von gestern zu treffen. Multipliziere das mit jedem Video im Kalender, und die Vertonung wird zum Flaschenhals des ganzen Kanals.
Frühe Text-to-Speech-Tools haben die Aufnahme abgeschafft, nicht aber das Problem: Die Stimmen klangen roboterhaft, das Tempo mechanisch, und jede Zeile kam mit derselben flachen Betonung heraus. Genau deshalb zucken manche Creator bei „KI-Stimme“ bis heute zusammen.
Moderne Modelle unterscheiden sich in einem entscheidenden Punkt: Sie folgen Regieanweisungen. Statt aus einer Handvoll fester Presets zu wählen, beschreibst du die gewünschte Performance, so wie du einen Sprecher briefen würdest, und dieselbe Stimme klingt ruhig in einer Doku, munter in einem Produkt-Review und gedämpft in einer Gutenachtgeschichte. Diese eine Fähigkeit macht aus der KI-Vertonung keine Abkürzung mehr, sondern ein echtes Produktionswerkzeug.
Tempo: Ein zehnminütiges Skript wird in Minuten zur fertigen Vertonung, nicht in einem Nachmittag.
Änderungen: Ändere einen Satz und generiere nur diesen Satz neu. Der Rest des Takes bleibt identisch.
Konsistenz: Dieselbe Stimme, dieselbe Energie, dasselbe Tempo in jedem Video, egal wie du am Aufnahmetag drauf bist.
Bandbreite: Ein Kanal kann mehrere Formate fahren, oder mehrere Kanäle teilen sich eine Pipeline, ohne neue Sprecher zu engagieren.
Was ein YouTube-Voiceover professionell klingen lässt
Bevor du dich für Tools entscheidest, hilft es zu benennen, worauf du hinauswillst. Professionelle Vertonung hat selten mit einer schönen Stimme zu tun. Es geht um eine Handvoll Qualitäten, die Zuschauer sofort registrieren, auch wenn sie sie nicht beschreiben könnten.
Verständlichkeit zuerst. Jedes Wort ist auch über den Handylautsprecher klar. Lange, verschachtelte Sätze sind der Feind; das Ohr kann nicht zurückspulen.
Ein Tempo, das zum Format passt. Tutorials atmen zwischen den Schritten. Story-Kanäle bauen Spannung auf und lösen sie wieder. Ein flottes Gesprächstempo passt zu Reviews; Erklärvideos brauchen kurze Pausen nach jedem Gedanken.
Ein Vortrag, der zur Szene passt. Eine Enthüllung soll wie eine Enthüllung klingen. Eine Warnung wie eine Warnung. Flache, gleichförmige Lesarten sind das, was die meisten meinen, wenn sie sagen, eine Stimme klinge „nach KI“.
Eine konsistente Identität. Der Sprecher in Video vierzig soll klingen wie der Sprecher in Video eins. Vertrautheit ist ein Grund, warum Abonnenten wiederkommen.
Sauberes Audio. Kein Raumhall, kein Grundrauschen, keine Plosive und ein Pegel, der bequem über deinem Musikbett sitzt.
Die gute Nachricht: Die letzten beiden Punkte sind bei generiertem Audio von Haus aus gelöst. Es gibt keinen Raum, der hallen könnte, und keinen schlechten Tag, an dem die Stimme anders klingt. Die ersten drei sind Handwerk, und der Rest dieses Leitfadens dreht sich darum, sie richtig hinzubekommen.
In sechs Schritten vom Skript zum veröffentlichten Video
Diesen Workflow empfehlen wir Creatorn, die von aufgenommener zu generierter Vertonung wechseln. Er ist bewusst unspektakulär, denn ein wiederholbarer Prozess ist genau das, was dich planmäßig veröffentlichen lässt.
Schreib fürs Ohr, nicht fürs Auge. Lies das Skript einmal laut. Kürze jeden Satz, bei dem du mittendrin Luft holen musstest. Schreib so, wie du sprichst, nicht wie du schreibst. Schreib Zahlen und Abkürzungen so aus, wie sie gesprochen werden sollen.
Wähl den Sprecher. Stöbere in der Stimmbibliothek nach Kategorie oder bring deine eigene Identität mit, per Stimmklonen oder mit einer gestalteten Stimme. Lass zwei oder drei Kandidaten denselben Absatz sprechen, damit du Stimmen vergleichst und nicht Skripte.
Führe den Vortrag. Füge eine Anweisung hinzu, die Ton, Energie, Tempo und Persona beschreibt. Ein bis zwei Sätze reichen. Diese Anweisung wird Teil des Styleguides deines Kanals.
Generiere und hör kritisch zu. Spiel das Ergebnis in der Lautstärke ab, die deine Zuschauer nutzen. Prüfe Namen, Zahlen und den Satz, bei dem du dir am wenigsten sicher warst. Passe erst die Anweisung oder den Regler Instruction Commitment an, bevor du am Skript etwas änderst.
Schneide es ins Video. Exportiere den Take, zieh ihn auf die Timeline und schneide die Bilder auf die Vertonung, nicht umgekehrt. Senke die Musik unter der Stimme ab und lass vor jedem neuen Abschnitt einen Moment Stille.
Überarbeite durch Neugenerieren, nicht durch Neuaufnahme. Wenn sich ein Fakt ändert oder eine Zeile nicht sitzt, bearbeite den Text, generiere dieses Segment neu und tausche es aus. Stimme, Energie und Pegel bleiben identisch mit dem Rest des Takes.
So findest du die richtige KI-Stimme für deinen Kanal
Die Stimme ist ein Versprechen über den Kanal. Ein Finanzkanal mit einer aufgekratzten, atemlosen Stimme wirkt unglaubwürdig, egal wie gut die Recherche ist; ein True-Crime-Kanal mit einer fröhlichen Tutorial-Stimme fühlt sich in den ersten zehn Sekunden falsch an. Bring die Stimme mit dem Versprechen in Einklang, bevor du über irgendetwas anderes nachdenkst.
Die folgende Tabelle ist ein Ausgangspunkt. Betrachte die Spalte mit der Regieanweisung als ersten Entwurf der Anweisung, die du im nächsten Abschnitt verfeinerst.
| Kanaltyp | Was die Stimme braucht | Regieanweisung zum Ausprobieren |
|---|---|---|
| Tutorials und How-tos | Klar, geduldig, ohne Eile; freundlich, aber nicht aufgesetzt | Erkläre wie ein hilfsbereiter Kollege, in gleichmäßigem Tempo, mit einer kurzen Pause nach jedem Schritt. |
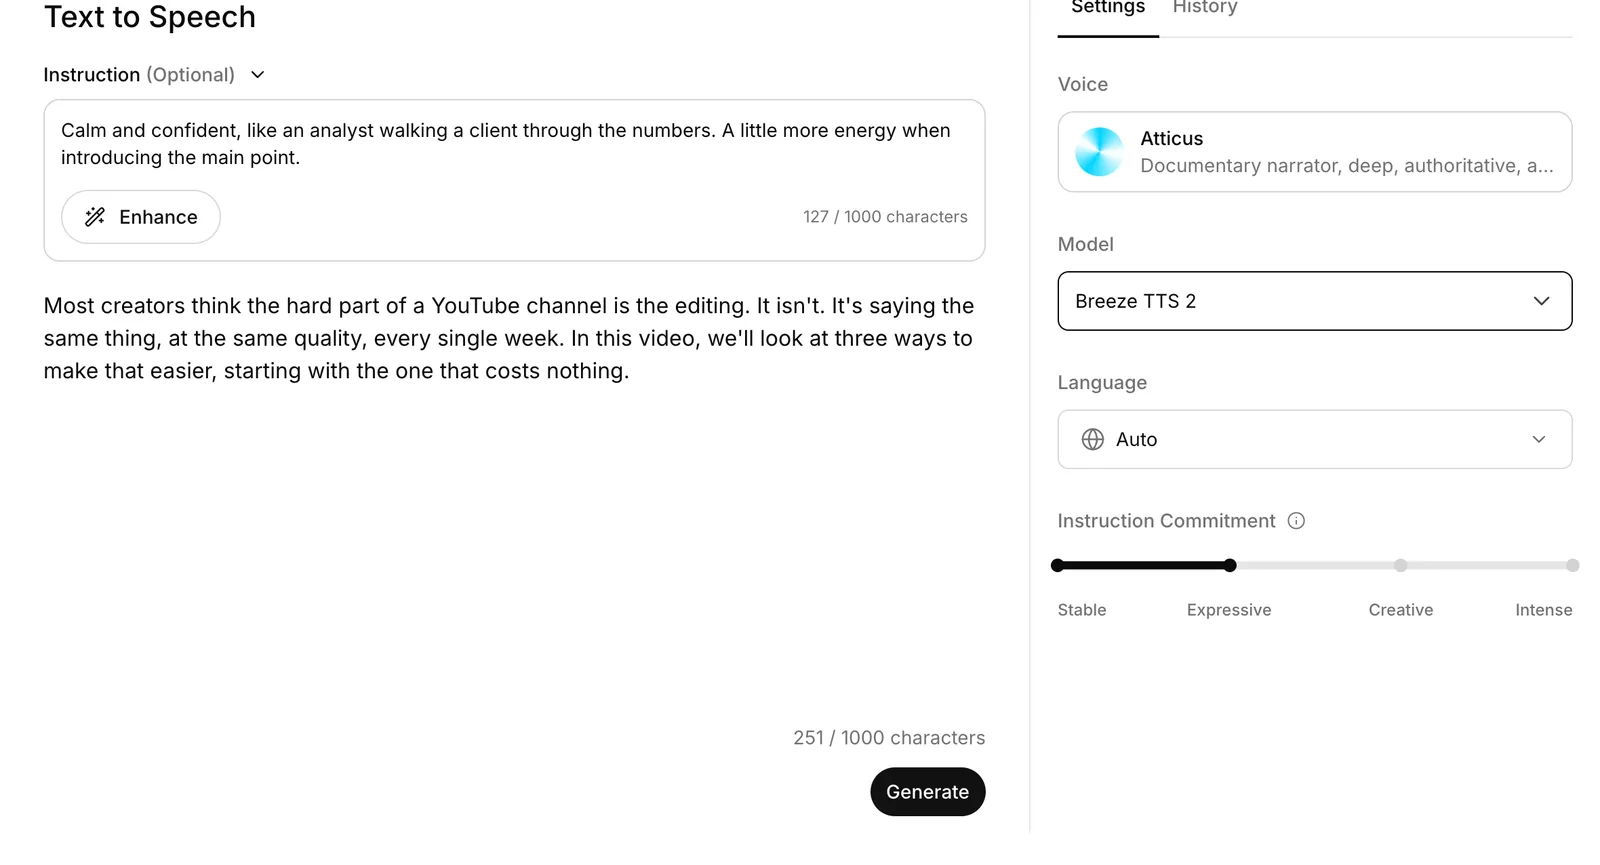
| Finanzen und Business | Geerdet, glaubwürdig, bedacht; wenig Energie, hohe Autorität | Ruhig und souverän, wie ein Analyst, der einem Kunden die Zahlen erklärt. |
| Doku und Geschichte | Warm, autoritativ, mit bedächtigem Tempo und Raum für Ernst | Ruhige Doku-Erzählung mit subtiler dramatischer Spannung und langen, natürlichen Pausen. |
| Tech-Reviews | Gesprächig, neugierig, flott; Meinung gehört zum Format | Modern und locker, wie ein Experte, der einem Freund etwas erklärt, mit etwas mehr Energie beim Hauptfeature. |
| Storytelling und True Crime | Intim, kontrolliert, kann Spannung aufbauen und lösen | Beginne zurückhaltend und leise, dann steigere die Intensität allmählich bis zur Enthüllung. |
| Kinder und Lernen | Hell, freundlich, ausdrucksstark, ohne laut zu sein | Warm und ermutigend, etwas langsamer als normal, mit klarer Betonung neuer Wörter. |
| Motivation und Selbstverbesserung | Aufrichtig, nach vorn gerichtet, rhythmisch | Ernsthaft und gleichmäßig, mit wachsendem Schwung bis zu den letzten Zeilen, ohne zu schreien. |
| Produktdemos und Onboarding | Professionell, präzise, markenneutral | Geschliffen und klar, wie eine Produkttour für jemanden, der es zum ersten Mal nutzt. |
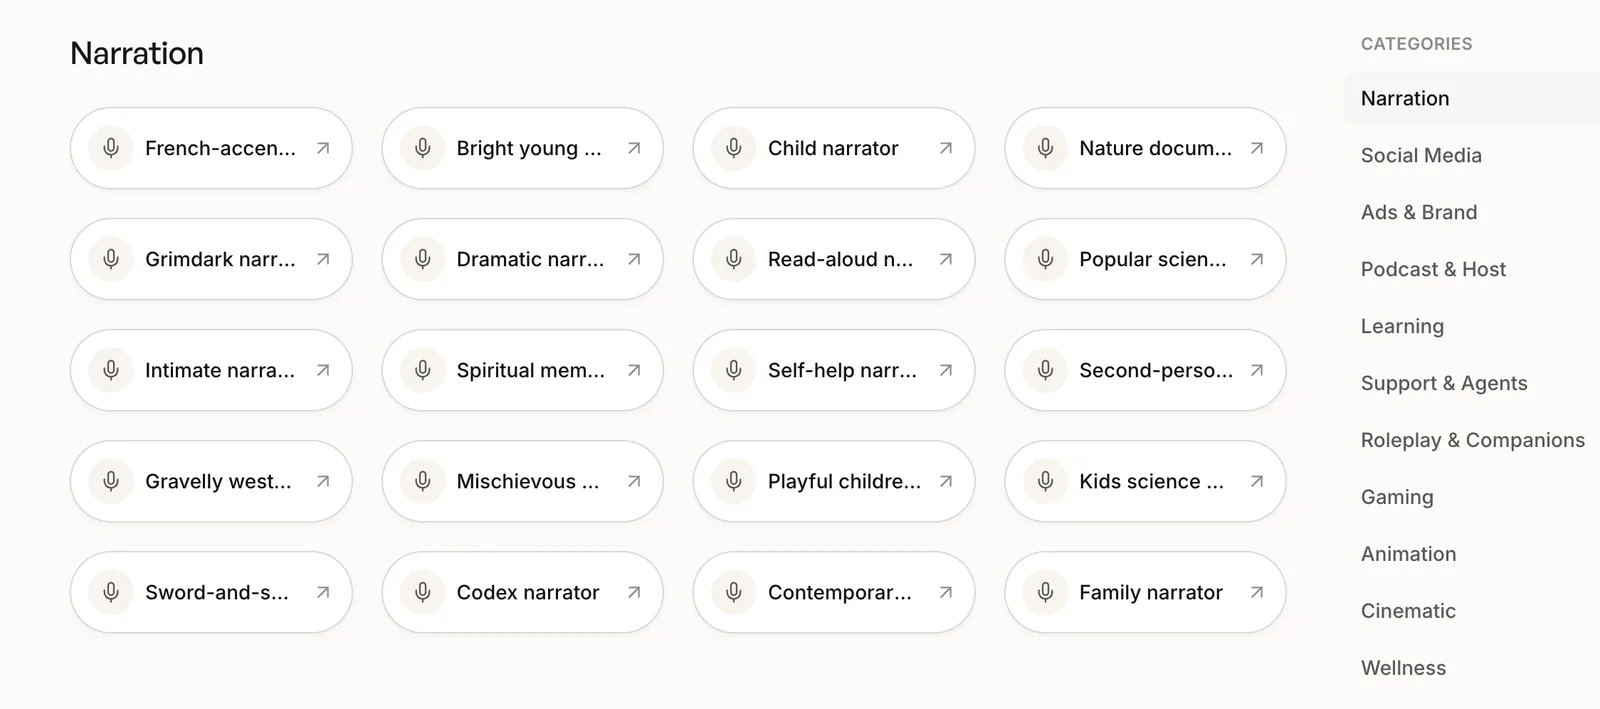
Die BreezeBlue Stimmbibliothek ist genau nach diesen Aufgaben gegliedert. Allein die Kategorie „Erzählung“ reicht von hellen, jungen Erzählstimmen und Naturdoku-Stimmen bis zu düsteren, dramatischen und Vorlese-Stilen, daneben gibt es Kategorien für Social Media, Lernen, Werbung, Podcasts, Gaming und Animation. Filtere nach der Art von Content, die du machst, hör in die Previews rein und stell dir eine Shortlist zusammen, bevor du eine einzige Anweisung schreibst.
Regie in ganz normaler Sprache
Die Wahl der Stimme entscheidet, wer spricht. Die Regie entscheidet, wie gesprochen wird, und genau hier klingt KI-Vertonung entweder professionell oder eben nicht. Bei Breeze TTS 2 ist Regie eine kurze Anweisung in natürlicher Sprache, die am Skript hängt, so wie du einen Sprecher in der Sprecherkabine briefen würdest.
Gute Anweisungen beschreiben vier Dinge: den Ton, die Energie, das Tempo und, wenn es hilft, eine Persona, in die die Stimme schlüpfen kann. Halte sie konkret und kurz. „Klingt gut“ ist keine Regieanweisung; „ruhig, autoritativ, bedächtiges Tempo“ schon.
Tech-Review
Souverän und locker, wie ein Experte, der einem Freund etwas erklärt. Etwas mehr Energie, wenn das Hauptfeature vorgestellt wird.
Geschichtsdoku
Ruhige Doku-Erzählung. Autoritativ, warm, mit bedächtigem Tempo und subtiler dramatischer Spannung.
Software-Tutorial
Sprich geduldig und klar, etwas langsamer als normal, mit einer natürlichen Pause vor jedem Schritt.
Enthüllung in der Story
Beginne leise und zurückhaltend, dann steigere die Intensität Satz für Satz bis zur Enthüllung.
Zwei weitere Regler formen einzelne Momente. Hinweise in Klammern wie [sigh], [giggle] oder [sob] lassen sich direkt im Skript platzieren, um einen einzelnen Moment einzufärben, ohne die gesamte Anweisung zu ändern. Der Regler Instruction Commitment legt fest, wie weit die Stimme deiner Regie folgt, von einer stabilen, geerdeten Lesart bis zu einer intensiven, ausdrucksstarken. Für die meiste YouTube-Vertonung ist eine stabile oder ausdrucksstarke Einstellung richtig; bei figurengetriebenem Storytelling darfst du weiter gehen.
Regie funktioniert nur, wenn das Modell ihr tatsächlich folgt und die Stimme dabei wiedererkennbar bleibt. Im offenen Voice Direction Benchmark, ausgewertet im August 2026, erreichte Breeze TTS 2 4.25 von 5 über neun Regie-Achsen, darunter Emotion, Intention und Akzent, bei einer Sprecherähnlichkeit von 0.67. In der Praxis heißt das: Der Sprecher, den du gewählt hast, klingt auch dann noch wie der Sprecher, den du gewählt hast, wenn du Spannung, Wärme oder Zurückhaltung verlangst.
Eine wiedererkennbare Stimme über alle Videos hinweg
Bibliotheksstimmen werden von vielen Creatorn genutzt. Für die meisten Formate ist das völlig in Ordnung, aber Kanäle, die eine Stimme wollen, die Zuschauer nur mit ihnen verbinden, haben zwei Optionen, und beide machen dich unabhängig vom Aufnahmeplan irgendeiner Person.
Stimmklonen macht aus einer kurzen, sauberen Referenzaufnahme eine wiederverwendbare KI-Stimme. Creator, die ihre Videos bereits selbst sprechen, behalten ihre Identität, produzieren aber deutlich mehr Content und können Zeilen noch lange nach der ursprünglichen Session mit ihrer eigenen Stimme neu generieren. Klone nur Stimmen, an denen du die Rechte hast: deine eigene oder eine, deren Inhaber schriftlich zugestimmt hat. So funktioniert Stimmklonen.
Stimmdesign erschafft einen komplett neuen Sprecher aus einer Textbeschreibung von Charakter, Alter, Ton und Stimmqualitäten, ganz ohne Ausgangsaudio. Es ist der schnellste Weg, einem Faceless-Kanal eine Signature-Stimme zu geben, die kein anderer Kanal hat. So funktioniert Stimmdesign.
Welchen Weg du auch wählst: Speichere die Stimme, kombiniere sie mit deiner Standardanweisung und nutze dieses Paar für alles, was der Kanal veröffentlicht. Konsistenz ist das Feature; das Tool ist nur die Art, wie du sie hältst.
Lange Videos, mehrere Sprecher und Kanäle im großen Stil
Ein zweiminütiger Short und eine vierzigminütige Doku brauchen unterschiedliche Werkzeuge. Kurze Skripte sind im Text-zu-Sprache-Editor gut aufgehoben: einfügen, führen, generieren, als WAV exportieren. Lange Skripte und Skripte mit mehreren Stimmen gehören in Studio, den Langform-Arbeitsbereich von BreezeBlue. Dort wird ein Skript in Segmente aufgeteilt, die jeweils eine eigene Stimme und Regie tragen, jedes Segment lässt sich einzeln neu generieren, und das fertige Projekt wird als eine Spur exportiert.
Diese Kontrolle auf Segmentebene macht Langform-Vertonung wartbar. Wenn sich ein Kapitel eines Kurses ändert oder ein Produkt-Interface neu gestaltet wird, ersetzt du die betroffenen Segmente und lässt den Rest der Aufnahme unangetastet, was mit einer menschlichen Session unmöglich ist.
Teams, die mehrere Faceless-Kanäle betreiben, Agenturen, die für mehrere Kunden produzieren, und E-Learning-Abteilungen mit großen Bibliotheken kommen an diesen Punkt und wollen dann Automatisierung: Skripte aus einer Tabelle, Vertonung nach Zeitplan, Audio direkt in die Schnitt-Pipeline. Dieselben Stimmen und Anweisungen stehen über die Developer API, SDKs und CLI bereit, sodass sich die Pipeline, die du im Browser aufgebaut hast, in Code nachbauen lässt, ohne dass sich der Klang des Kanals ändert.
Eine Warnung für die Skalierung: Automatisiere die Generierung, nicht das Urteil. Jemand sollte jedes Video anhören, bevor es live geht. Die Tools ersetzen die Aufnahmesession, nicht den Redakteur.
KI-Voiceovers und die Regeln von YouTube
KI-Vertonung ist auf YouTube erlaubt, und Kanäle, die darauf aufbauen, werden jeden Tag monetarisiert. Was die Monetarisierungsrichtlinien der Plattform bestrafen, sind massenhaft produzierte oder repetitive Inhalte mit wenig eigenem Wert, unabhängig davon, ob ein Mensch oder ein Modell das Skript gelesen hat. Die praktische Messlatte ist dieselbe wie für jeden anderen Kanal: eigene Recherche, ein echter Standpunkt, ein Schnitt, der dem Zuschauer dient, und eine Vertonung, die zum Video passt, statt einfach darübergelegt zu sein.
Ein paar Gewohnheiten halten einen Kanal auf der richtigen Seite der Linie. Kennzeichne synthetische Medien dort, wo YouTube es verlangt, vor allem wenn eine realistische Stimme oder ein Abbild mit einer echten Person oder einem echten Ereignis verwechselt werden könnte. Klone nur Stimmen, an denen du die Rechte hast. Füge Untertitel hinzu, für die Barrierefreiheit und weil sie der Suche helfen. Und lies die aktuellen Richtlinien von YouTube selbst nach, statt dich auf einen Blogbeitrag zu verlassen, denn die Regeln werden regelmäßig überarbeitet.
So eingesetzt ist KI-Voiceover kein Weg, die Standards der Plattform zu umgehen. Es ist ein Weg, sie öfter zu erfüllen, denn die Zeit, die du nicht in der Sprecherkabine verbringst, kannst du in die Recherche und den Schnitt stecken, die Zuschauer wirklich belohnen.
Erstelle dein nächstes YouTube-Voiceover mit BreezeBlue
YouTube-Vertonung hat sich von „Text-to-Speech“ zu etwas entwickelt, das eher einer geführten Performance gleicht. Du wählst einen Sprecher für den Kanal, beschreibst, wie jede Szene vorgetragen werden soll, hältst diese Stimme über jeden Upload hinweg konsistent und korrigierst eine Zeile, indem du sie neu generierst, statt erneut aufzunehmen.
BreezeBlue bringt diese Bausteine an einem Ort zusammen: Text-zu-Sprache für Skripte, eine Stimmbibliothek, die nach deinem Content gegliedert ist, Stimmklonen und Stimmdesign für einen Signature-Sprecher, Studio für Langform- und Multi-Voice-Projekte und eine Developer API für die Automatisierung. Der Einstieg ist kostenlos, mit kostenpflichtigen Tarifen für Creator und Teams, die in großem Umfang veröffentlichen.
Häufige Fragen
Kann ich YouTube-Videos mit KI-Voiceover monetarisieren?
Ja. Die Monetarisierungsrichtlinien von YouTube verbieten KI-Vertonung nicht. Sie bestrafen massenhaft produzierte oder repetitive Inhalte mit wenig eigenem Wert, ein Kanal, der KI-Voiceover für eigene, sauber geschnittene Videos nutzt, wird also wie jeder andere Kanal behandelt. Halte dich an die Kennzeichnungspflichten von YouTube für realistische synthetische Medien und lies die aktuellen Richtlinien, bevor du startest.
Welche KI-Stimme eignet sich am besten für einen Faceless-YouTube-Kanal?
Die, die zum Versprechen des Kanals passt. Finanz- und Doku-Formate brauchen geerdete, bedächtige Sprecher; Tech- und Review-Formate gesprächige, energiegeladene Stimmen; Story-Formate intime Stimmen, die Spannung aufbauen können. Setz zwei oder drei Stimmen aus der Kategorie „Erzählung“ auf deine Shortlist, generiere mit jeder denselben schwierigen Absatz und entscheide nach Gehör. Für eine Stimme, die kein anderer Kanal hat, gestalte eine aus einer Textbeschreibung.
Kann ich meine eigene Stimme für die KI-Vertonung nutzen?
Ja. Stimmklonen erstellt aus einer kurzen, sauberen Referenzaufnahme von dir eine wiederverwendbare KI-Stimme. So behältst du deine Identität, produzierst deutlich mehr Content und kannst Zeilen jederzeit mit deiner eigenen Stimme neu generieren. Klone nur Stimmen, die dir gehören oder für die du eine schriftliche Erlaubnis hast.
Wie klingt eine KI-Stimme weniger roboterhaft?
Drei Dinge zählen am meisten. Schreib das Skript so, wie Menschen sprechen, mit kurzen Sätzen und alltäglichen Formulierungen. Füge eine Anweisung von einem Satz hinzu, die Ton, Energie und Tempo beschreibt, statt dich auf die Standardlesart zu verlassen. Nutze dann Hinweise in Klammern für einzelne Momente und passe den Regler Instruction Commitment an, wenn der Vortrag zu flach oder zu viel ist. Die meisten „roboterhaften“ Ergebnisse entstehen, wenn eine ungeführte Stimme Text vorliest, der fürs Auge geschrieben wurde.
Welches Audioformat bekomme ich und wie füge ich es in meinen Videoeditor ein?
Vertonung aus Text-zu-Sprache und Studio wird als WAV heruntergeladen, das jeder Videoeditor direkt importiert. Zieh die Datei auf eine Audiospur, schneide deine Bilder auf die Vertonung und senke das Musikbett unter der Stimme ab. Ändert sich später eine Zeile, generierst du nur dieses Segment neu und tauschst es auf der Timeline aus.
Funktioniert KI-Voiceover auch für YouTube-Kanäle in anderen Sprachen als Englisch?
Ja. Breeze TTS 2 Multilingual-51 unterstützt 51 Sprachen, und der Workflow mit Stimme und Regie ist derselbe. Wähl eine Stimme für deine Sprache, schreib die Anweisung in derselben Sprache und prüfe das Ergebnis mit demselben Ablauf wie auf Englisch.