Das ausdrucksstärkste und am besten steuerbare Text-zu-Sprache-Modell
Alles, was du brauchst, um eine Performance zu führen
Ein kompletter Satz Regler, um jede Stimme und jede Zeile zu formen.
Beginne kühl und distanziert und halte die Wut unter der Oberfläche. Bleib leise und lass die letzten beiden Fragen in schneidenden Sarkasmus übergehen.
“ Na gut. Du hast mit allem recht, es war mein Fehler. Sind wir jetzt zufrieden? Was willst du denn noch von mir? ”
Stimmen, die du in ganz normaler Sprache führst
Wir nehmen eine Anweisung in natürlicher Sprache — wie sich eine Zeile anfühlen soll, nach wem sie klingen soll, in welchem Tempo sie laufen soll — und spielen dein Skript passend dazu. So formst du den Vortrag, wie eine Regie die Schauspieler führt, statt dich mit einer einzigen festen Lesart zufriedenzugeben.
Diese Aufnahmen zeigen dieselbe Stimme mit unterschiedlichen Regieanweisungen. Der Text bewahrt die Satzzeichen und Pausen der jeweiligen Aufnahme. Die Regieanweisungen sind Übersetzungen der englischen Aufnahmevorlagen.
Ausdruckskraft, die sich messen lässt
Im offenen Voice Direction Benchmark (700 Regie-Aufgaben, ausgewertet im August 2026) führt Breeze TTS 2 mit einem Overall Voice Direction Score von 4.25 von 5 — bei einer Sprecherähnlichkeit von 0.67. Die Stimme folgt deiner Regie, ohne in ein anderes Timbre abzudriften.
Den vollständigen Voice-Direction-Benchmark ansehen- 4.25
- Overall Voice Direction Score, auf einer Skala von 1–5
- 0.67
- Sprecherähnlichkeit unter Regie (0–1)
- 9
- Regie-Achsen, von Akzent und Emotion bis Intention
Echtzeit, gebaut für niedrige Latenz
Sprache kommt in Millisekunden zurück, schnell genug für Live-Agents und interaktive Medien. Du baust Erlebnisse, die in dem Moment antworten, in dem jemand spricht, ganz ohne Wartezeit fürs Rendern.
Stimmen, die spielen
Jede Zeile kommt mit echter emotionaler Bandbreite zurück: ein Flüstern, wachsende Aufregung, ein Moment des Zögerns. Das Ergebnis wirkt gespielt und nicht von einer Maschine vorgelesen.
Eine Stimmbibliothek mit echtem Charakter
Wähl aus einer kuratierten Bandbreite von Stimmen, jede mit eigener Persönlichkeit — oder klone und gestalte deine eigene. Jede Stimme ist vollständig steuerbar und sofort spielbereit.
Eine Stimm-Engine für jede Art von Arbeit
Was du auch produzierst — BreezeBlue-Stimmen sind gebaut, um darin zu spielen.
Hörbücher & Erzählung
Verwandle Manuskripte und Skripte in natürlich klingende Erzählung, mit gleichbleibendem Charakter und Tempo über alle Kapitel hinweg, in einem Bruchteil der Zeit.
Video-Voiceovers
Produziere Voiceovers für Videos, Serien und Animationen mit steuerbarem Ton und Gefühl, damit die Lesart zur Szene passt, ganz ohne Studiotermin.
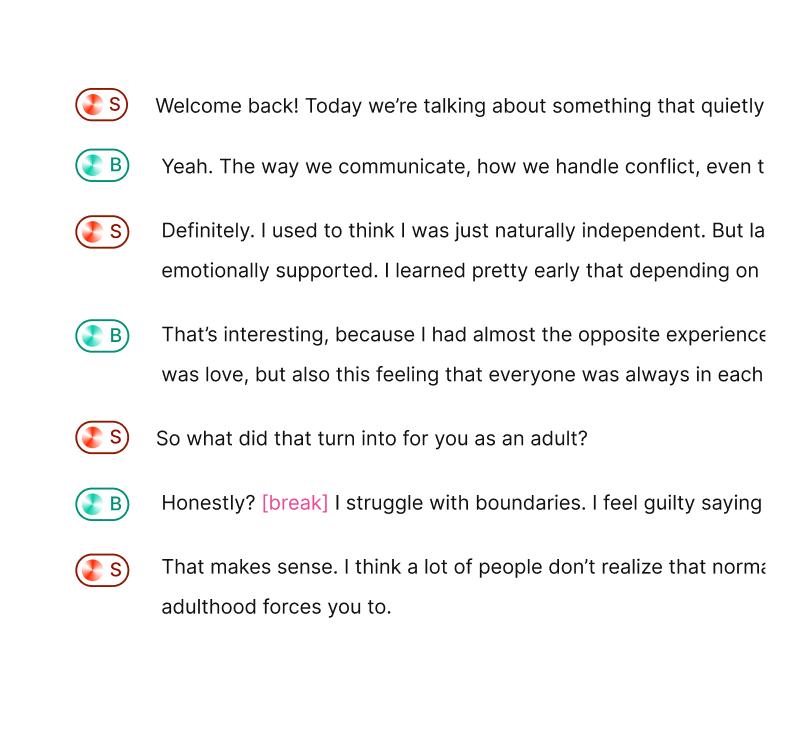
Podcasts
Erstelle Podcasts mit konstanter, professioneller Erzählung, die du Zeile für Zeile führst, und spar dir Zeit bei manuellen Aufnahmen.
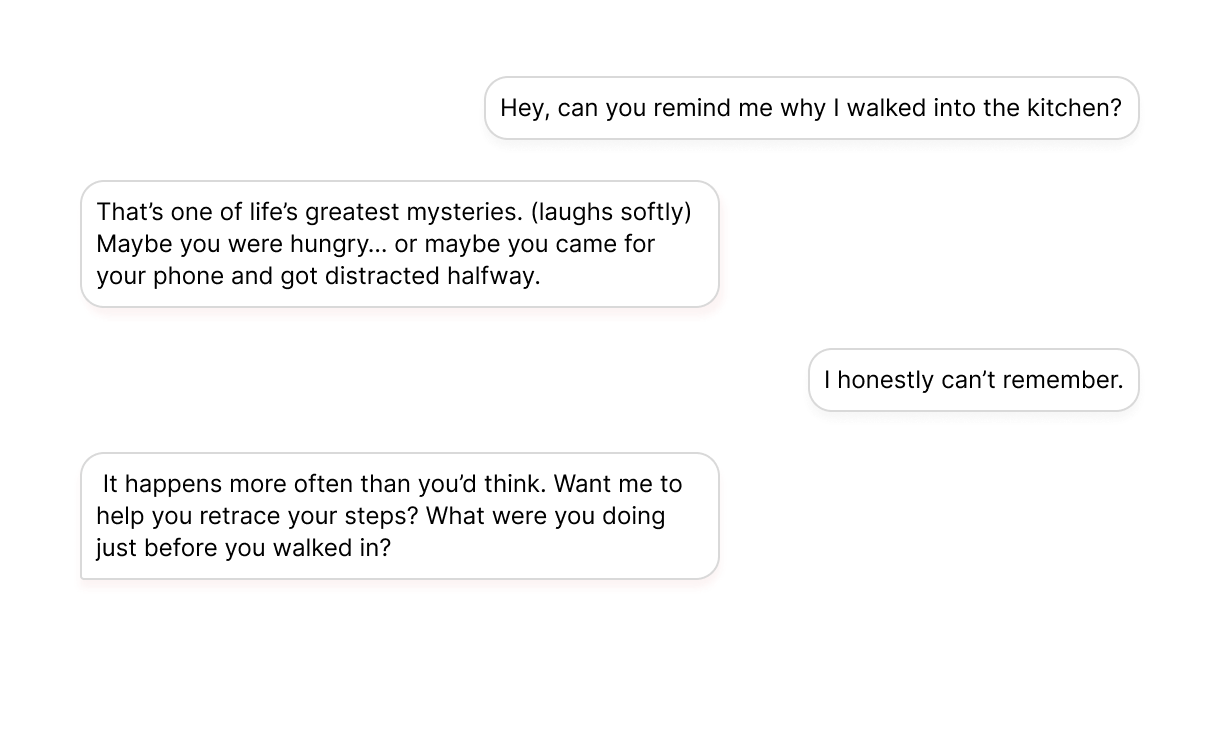
Dialogfähige Agents
Gib Chatbots und virtuellen Assistenten eine natürliche, menschlich klingende Stimme, die in Echtzeit antwortet, für Interaktionen, die sich wirklich nach Gespräch anfühlen.
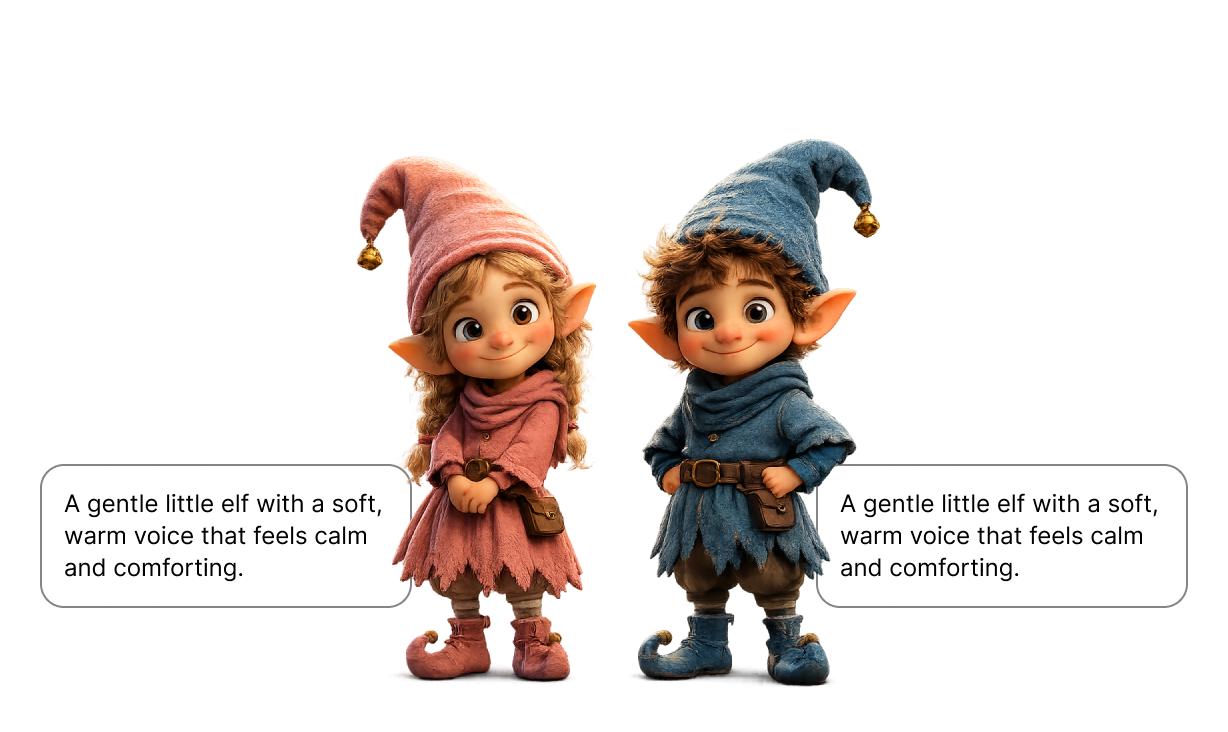
Games & Charaktere
Vertone Spielfiguren und ganze Original-Casts über die Text-zu-Sprache-API, mit kontextbewusstem, emotional treffendem Vortrag für jede Szene.
Verfügbar als Web-App und über die API
Eine Anweisung, zwei Wege sie auszuführen
Nutze diese Anweisung und diesen Text im Creator oder sende sie über die API, um eine eigene Interpretation zu gestalten.
Anweisung
Beginne kühl und distanziert und halte die Wut unter der Oberfläche. Bleib leise und lass die letzten beiden Fragen in schneidenden Sarkasmus übergehen.
Text
Na gut. Du hast mit allem recht, es war mein Fehler. Sind wir jetzt zufrieden? Was willst du denn noch von mir?
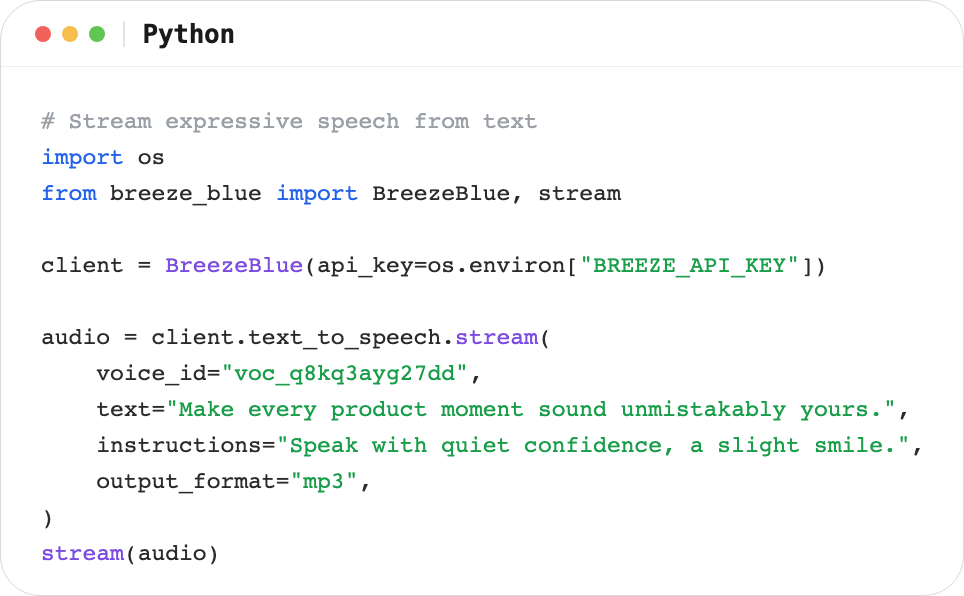
Im Creator gehören sie in das Anweisungs- und das Skriptfeld. Über die API schickst du dieselben zwei Strings in einer einzigen Synthese-Anfrage und streamst das Audio zurück.
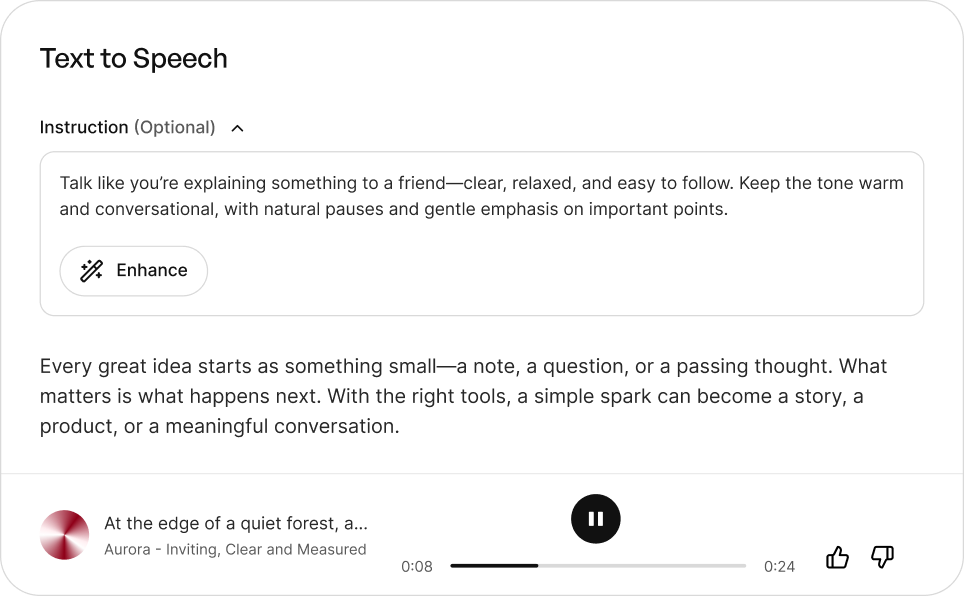
BreezeBlue Creator
Gestalte, führe und generiere Stimmen in einem einzigen Creator-Tool im Browser.
Text-zu-Sprache-API und SDKs
Integriere Text-zu-Sprache von BreezeBlue über APIs oder SDKs in dein Produkt.
Wie es weitergeht
Text-zu-Sprache ist ein Schritt in einem Stimm-Workflow — diese Seiten decken die Stimmen ab, die du hineingibst, und die Arbeit, die du am Ende ablieferst.
Häufige Fragen
Was unterscheidet BreezeBlue von anderen Text-zu-Sprache-Tools?
In unserem Sprachmodell schreibst du deine Anweisung in ganz normaler Sprache — „sprich wie ein Radiomoderator zu später Stunde, warm und ohne Eile“ — und die Stimme richtet ihren Vortrag danach aus. Das ist Regie in natürlicher Sprache, so wie du ein Sprechtalent briefen würdest, und keine feste Liste voreingestellter Emotionen.
Kann ich den Vortrag einzelner Zeilen feinjustieren?
Ja. Über die Gesamtanweisung hinaus setzt du kurze Hinweise in Klammern wie [sob], [sigh] oder [giggle] an beliebiger Stelle im Text ein, um einen einzelnen Moment zu formen. Und mit dem Regler Instruction Commitment legst du fest, wie weit die Stimme deiner Regie folgt: von stabil und geerdet bis mutig und ausdrucksstark.
Welche Referenzstimme kann ich für Text-zu-Sprache nutzen?
Jede Stimme auf der Plattform kann deine Referenz sein. Wähl aus einer kuratierten Bibliothek, in der jede Stimme eine eigene Persönlichkeit hat statt austauschbarer Erzählung, klone deine eigene aus einer kurzen Aufnahme oder gestalte eine neue Stimme aus einem Text-Prompt.
Welche Sprachen unterstützt BreezeBlue?
Breeze TTS 2 Multilingual unterstützt 51 Sprachen. Welche Sprachen verfügbar sind, hängt vom gewählten Modell ab, und BreezeBlue zeigt nur die Sprachen an, die dieses Modell aktuell freigibt.
Darf ich das Audio kommerziell nutzen?
Audio, das in den kostenpflichtigen Tarifen von BreezeBlue erzeugt wird, darfst du in kommerziellen Projekten einsetzen, von Videos und Werbung bis zu Games und Hörbüchern.
Was kostet das? Gibt es einen kostenlosen Tarif?
Ja. BreezeBlue ist zum Start kostenlos, und jeder kann sich täglich kostenlose Credits abholen. Die kostenpflichtigen Tarife bauen darauf auf: mehr Credits pro Monat, mehr Stimm-Slots und schnellere Generierung, wenn dein Bedarf wächst. Die vollständige Übersicht findest du auf unserer Preisseite.
Welche Audioformate kann ich exportieren?
Audio aus Text-zu-Sprache und Studio wird als WAV heruntergeladen, Stimmen aus der Stimmbibliothek als MP3.
Kann KI-Text-zu-Sprache wirklich emotional klingen?
Ja — und das ist gemessen, nicht nur versprochen. Im offenen Voice Direction Benchmark (August 2026) erreichte Breeze TTS 2 einen Gesamtwert von 4.25 von 5 über neun Regie-Achsen, darunter Emotion, Intention und Akzent. In der Praxis beschreibst du das Gefühl, das du willst — zurückgehaltene Trauer, wachsende Aufregung, trockener Sarkasmus — und die Stimme spielt es, statt ein fertiges Fröhlich-oder-Traurig-Preset überzustülpen.
Wie schreibe ich eine Stimm-Anweisung, der das Modell folgt?
Behandle sie wie eine Regienotiz: Benenn die Emotion, die Absicht hinter der Zeile und das Tempo, statt Adjektive zu stapeln. „Sag es flüsternd, sehr leise und angespannt, als hättest du Angst, belauscht zu werden“ funktioniert besser als „flüstere dramatisch“. Jedes Beispiel auf dieser Seite zeigt seine vollständige Anweisung im Wortlaut — du kannst von einer starten, ein einzelnes Detail ändern und genau hören, was sich verschiebt.
Bietet die API dieselbe Anweisungssteuerung wie die Web-App?
Ja. Die Text-zu-Sprache-API nutzt dasselbe Modell wie der Web-Creator, dieselbe Anweisung in natürlicher Sprache ergibt also auf beiden Wegen dieselbe geführte Performance. Das Audio streamt über die API zurück, die SDKs erledigen die Anfrage in wenigen Zeilen, und mit den identischen Eingaben auf dieser Seite prüfst du leicht, dass beide Wege übereinstimmen.