导演一场表演所需的一切
一整套控制力,用来塑造每一个声音、每一句台词。
压住怒火,用冷淡、带刺的反讽说;重读“你说的都对”和“是我错了”,最后两个问句逐渐尖锐,但不要喊。
“ 好吧,你说的都对,是我错了。这样总行了吧?你还想让我怎么样呢? ”
用大白话就能指挥的声音
我们接收一条自然语言指令——一句台词该有什么感觉、该像谁、该用什么节奏——再让模型照着演绎你的文稿。你可以像导演指挥演员那样塑造每一次表达,而不是只能接受一种固定的读法。
以下录音使用同一个声音,展示不同指令下的演绎。台词保留各段录音实际使用的标点和停顿。
表现力,可以被测量
在公开的 Voice Direction Benchmark(700 个演绎任务,2026 年 8 月评测)上,Breeze TTS 2 以 4.25 / 5 的综合 Voice Direction Score 领先,同时说话人相似度保持在 0.67——声音会跟随你的指挥去演,而不会漂移成另一种音色。
查看完整的 Voice Direction 基准评测- 4.25
- 综合 Voice Direction Score(1–5 分制)
- 0.67
- 被指挥时保持的说话人相似度(0–1)
- 9
- 覆盖的控制维度,从口音、情绪到意图
实时,为低延迟而生
语音以毫秒级流式返回,足够支撑实时语音助手与互动媒体。你可以在用户开口的那一刻就给出回应,无需等待渲染。
会表演的声音
每一句都带着真实的情绪起伏——一声耳语、一段逐渐高涨的兴奋、一拍迟疑。最终听起来是被演出来的,而不是被机器念出来的。
真正有性格的音色库
从精选的声音里挑选,每一个都有自己的个性——也可以克隆和设计你自己的声音。每个声音都完全可被指挥,随时可以开演。
一个语音引擎,胜任各种创作
无论你在做什么内容,BreezeBlue 的声音都为它而生、为它而演。
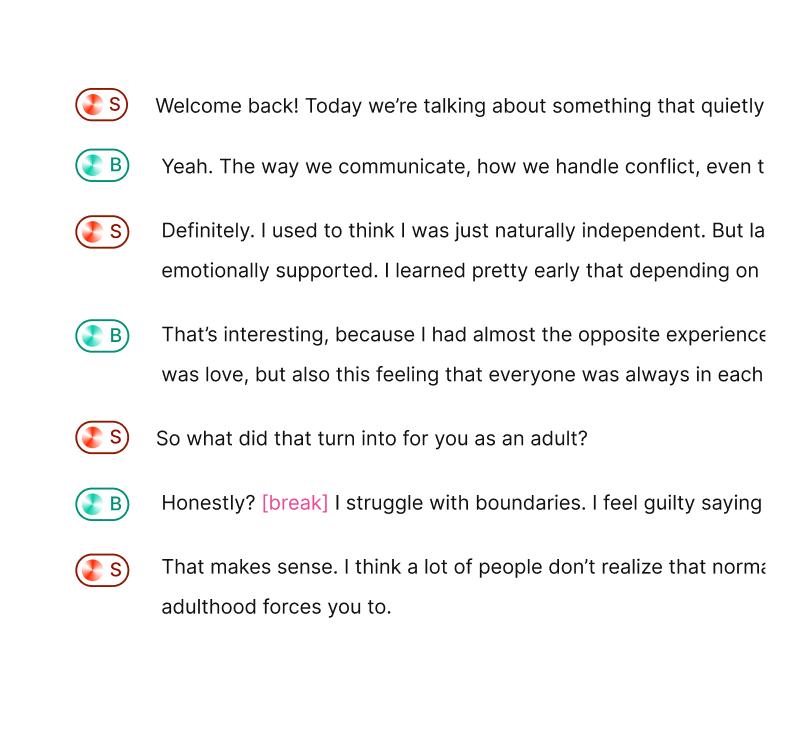
有声书与旁白
把书稿和剧本转成自然的旁白,跨章节保持一致的角色与节奏,所需时间只是过去的一小部分。
视频配音
为视频、节目和动画制作配音,语气与情绪都可被指挥,让朗读贴合画面,无需进棚录制。
播客
用可逐句指挥的、稳定专业的旁白制作播客,大幅减少手动录制的时间。
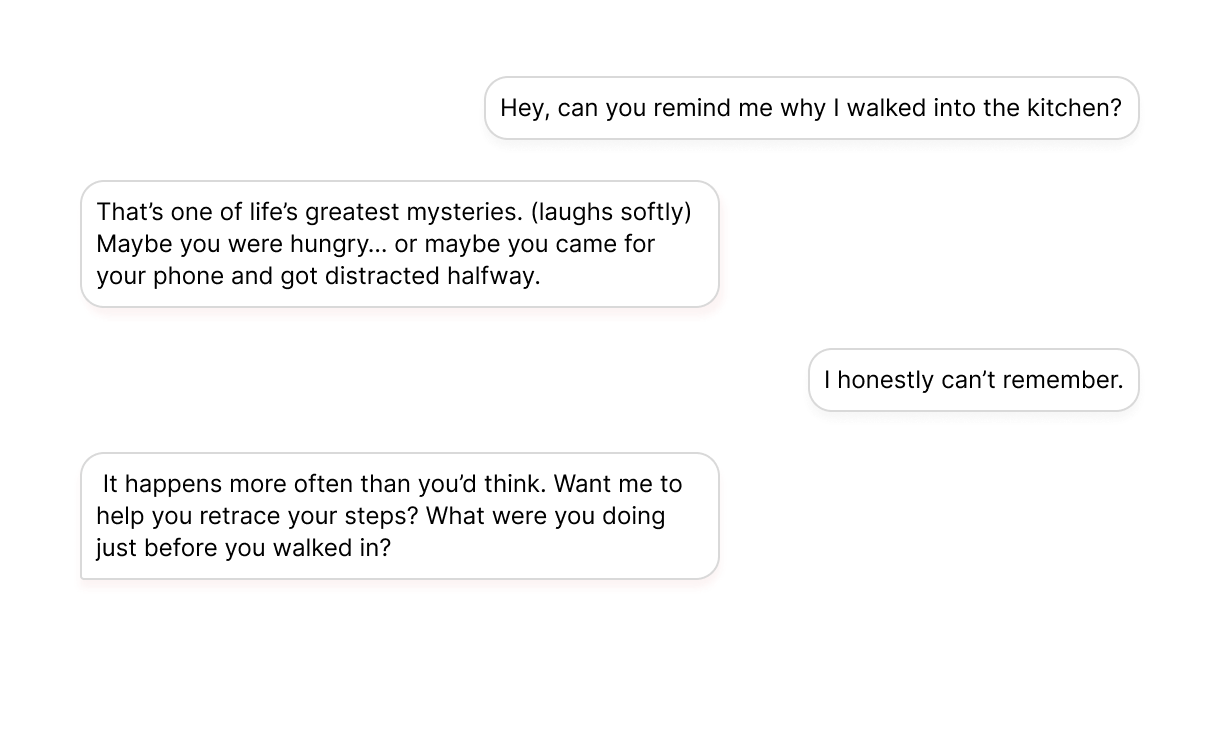
对话式智能体
为聊天机器人和虚拟助手赋予自然、拟人的声音,实时应答,让交互真正像在对话。
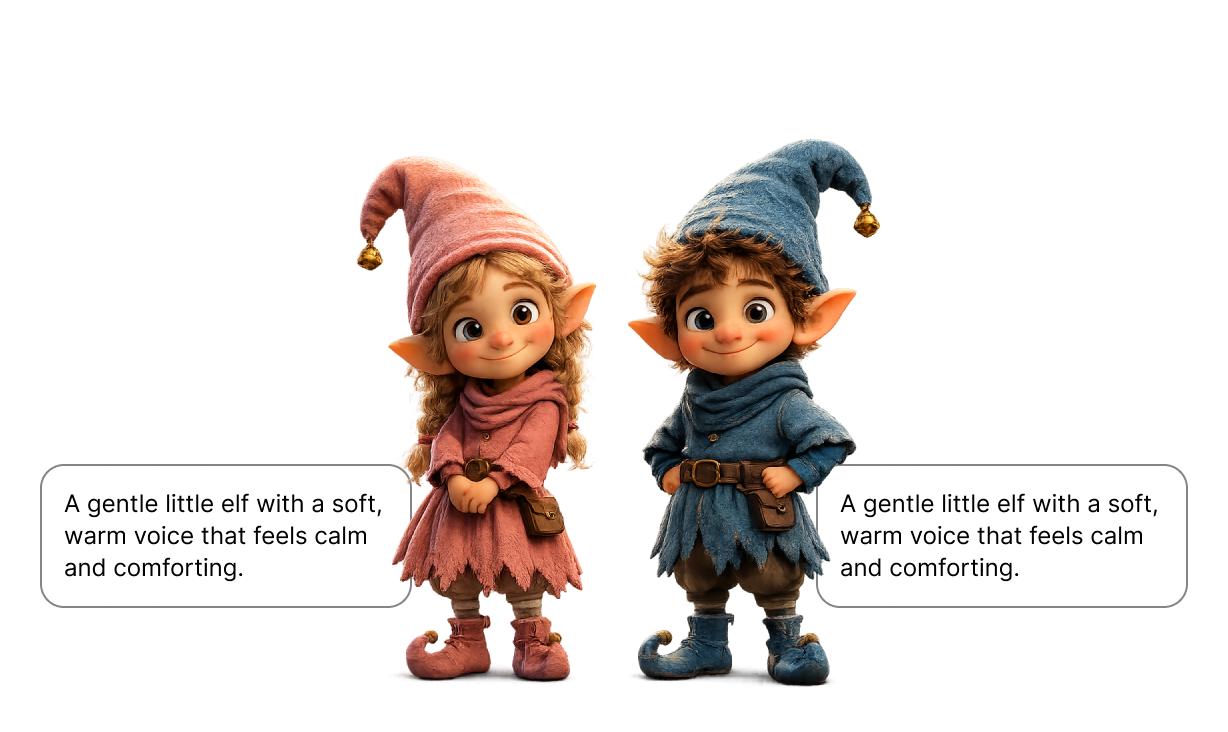
游戏与角色
通过文本转语音 API 为游戏角色和原创群像配音,结合上下文、情绪精准的演绎贴合每一个场景。
网页应用与 API 双端可用
同一条指令,两条路径运行
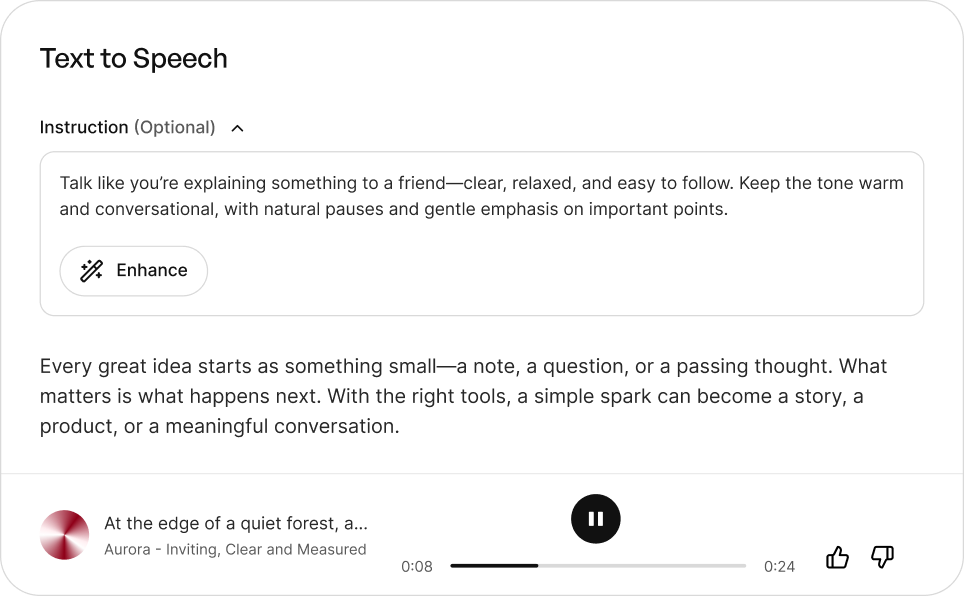
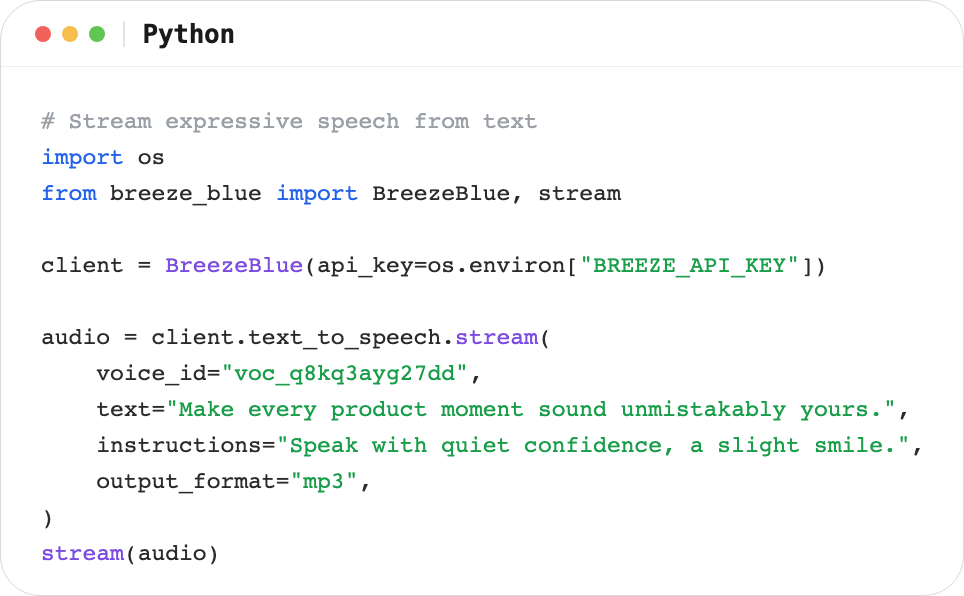
把下面的指令和台词填入 Creator,或通过 API 提交,尝试用自己的声音演绎这段内容。
指令
压住怒火,用冷淡、带刺的反讽说;重读“你说的都对”和“是我错了”,最后两个问句逐渐尖锐,但不要喊。
文本
好吧,你说的都对,是我错了。这样总行了吧?你还想让我怎么样呢?
在 Creator 里,把它们分别填进指令栏和文稿栏;通过 API,则在一次合成请求里发送同样的两段文字,音频会流式返回。
常见问题
BreezeBlue 和其他文本转语音工具有什么不同?
在我们的语音模型里,你用大白话写下指令——“像深夜电台主持人那样,温暖而从容”——声音就会照着调整它的演绎。这是自然语言式的导演,就像你给配音演员说戏,而不是从一份固定的预设情绪清单里挑。
我可以微调某些台词的演绎吗?
可以。除了整体指令,你还能在文字任意位置插入像 [sob]、[sigh]、[giggle] 这样的简短括号提示,来塑造某一个瞬间。Instruction Commitment 控制项则让你设定声音对指令的执行力度——从稳定克制到大胆张扬。
文本转语音可以用什么样的参考声音?
平台上的任何声音都能作为你的参考。可以从精选音色库里挑选——每个声音都有自己的个性,而不是千篇一律的旁白——也可以用一小段样本克隆你自己的声音,或用一段文字提示设计全新的声音。
BreezeBlue 支持哪些语言?
Breeze TTS 2 Multilingual 支持 51 种语言。可用语言取决于你选择的模型,BreezeBlue 只会显示当前由该模型开放的语言。
生成的音频可以商用吗?
在 BreezeBlue 付费方案下生成的音频可用于商业项目,从视频、广告到游戏和有声书都可以。
价格如何?有免费方案吗?
有。BreezeBlue 免费即可上手,每位用户每天都能领取免费额度。付费方案在此基础上提供更多的月度额度、声音槽位和更快的生成速度,随你的需求扩展。完整明细见我们的定价页面。
我可以导出哪些音频格式?
在文本转语音和工作台中生成的音频以 WAV 下载,音色库里的声音以 MP3 下载。
AI 文本转语音真的能有情绪吗?
能——而且是测出来的,不是口头承诺。在公开的 Voice Direction Benchmark(2026 年 8 月)上,Breeze TTS 2 在情绪、意图、口音等 9 个控制维度上取得 4.25 / 5 的综合得分。实际使用时,你只需描述想要的感觉——强忍的悲伤、逐渐高涨的兴奋、干巴巴的讽刺——声音就会照着演,而不是套用一个现成的“开心”或“难过”预设。
怎样写出模型能执行的声音指令?
把它当成导演的说戏笔记:写清情绪、这句话背后的意图和节奏,而不是堆砌形容词。“用耳语的方式说,非常轻、非常紧张,仿佛害怕被人听见”就比“戏剧化地耳语”有效得多。本页每条示例都原样展示了完整指令,你可以从其中一条出发,只改一个细节,然后听听发生了什么变化。
API 能获得和网页版一样的指令控制吗?
能。文本转语音 API 与网页版 Creator 跑的是同一个模型,同一条自然语言指令在两边会得到同样的演绎。音频通过 API 流式返回,SDK 几行代码即可完成调用,而本页给出的完全相同的输入也方便你验证两条路径的结果一致。