Breeze TTS 2 est désormais le modèle de synthèse vocale à poids ouverts n° 1 du classement Provider Voice Arena d’Artificial Analysis, avec un score Quality Elo de 1215.
Dans l’instantané du classement du 26 août 2026, Breeze TTS 2 devançait tous les autres modèles TTS à poids ouverts évalués par Artificial Analysis. Il termine avec 90 points Elo d’avance sur Fish Audio S2 Pro, deuxième, et 113 points d’avance sur Step Audio EditX, troisième.
C’est une étape importante pour BreezeBlue et pour l’IA vocale à poids ouverts. Le classement repose sur les préférences d’auditeurs humains en aveugle, et non sur des scores choisis par les éditeurs ni sur des métriques audio automatisées ; il établit Breeze TTS 2 comme le modèle à poids ouverts le mieux noté de cette évaluation TTS indépendante.
Qu’est-ce que l’Arena TTS d’Artificial Analysis ?
L’Arena Text to Speech d’Artificial Analysis est un benchmark indépendant qui compare les modèles de génération de parole au moyen de tests d’écoute en aveugle, en face-à-face.
À chaque comparaison, les auditeurs entendent deux extraits audio générés à partir du même texte, sans savoir quels modèles les ont produits. Ils choisissent l’extrait qui leur semble le plus naturel, et Artificial Analysis agrège ces préférences en un score Quality Elo relatif. Plus le score Elo est élevé, plus les auditeurs ont préféré ce modèle par rapport aux autres modèles de l’Arena.
Le classement est conçu pour saisir la qualité de parole telle qu’elle est perçue par de vrais auditeurs. Cela recouvre des qualités telles que :
Le naturel
La qualité audio
La prononciation
Le rythme
La prosodie et l’expressivité
Pour la Provider Voice Arena, Artificial Analysis évalue chaque modèle à partir d’un ensemble représentatif de ses voix disponibles. L’objectif est de couvrir des voix masculines et féminines aux accents américain et britannique, avec jusqu’à huit voix par modèle. Le score obtenu reflète donc l’expérience globale des voix associées à chaque modèle, et non une seule démo triée sur le volet.
Artificial Analysis publie également le nombre d’échantillons, les intervalles de confiance, des filtres par catégorie et des filtres par accent pour aider les lecteurs à interpréter le classement. L’Elo est une mesure relative : les scores peuvent évoluer à mesure que de nouveaux votes sont collectés et que de nouveaux modèles entrent dans l’Arena.
Breeze TTS 2 en tête du classement à poids ouverts
Les cinq premiers modèles à poids ouverts de la Provider Voice Arena étaient :
| Rang | Modèle | Créateur | Quality Elo |
|---|---|---|---|
| 1 | Breeze TTS 2 | BreezeBlue | 1215 |
| 2 | Fish Audio S2 Pro | Fish Audio | 1125 |
| 3 | Step Audio EditX (March 2026) | StepFun | 1102 |
| 4 | Voxtral TTS | Mistral | 1082 |
| 5 | Magpie-Multilingual 357M | NVIDIA | 1066 |
Breeze TTS 2 conservait 90 points d’avance sur son concurrent à poids ouverts le plus proche. Dans un système fondé sur l’Elo, chaque score est déterminé par rapport aux préférences des auditeurs sur l’ensemble des modèles, ce qui fait de cet écart un signal significatif de la constance avec laquelle les auditeurs ont choisi Breeze TTS 2.
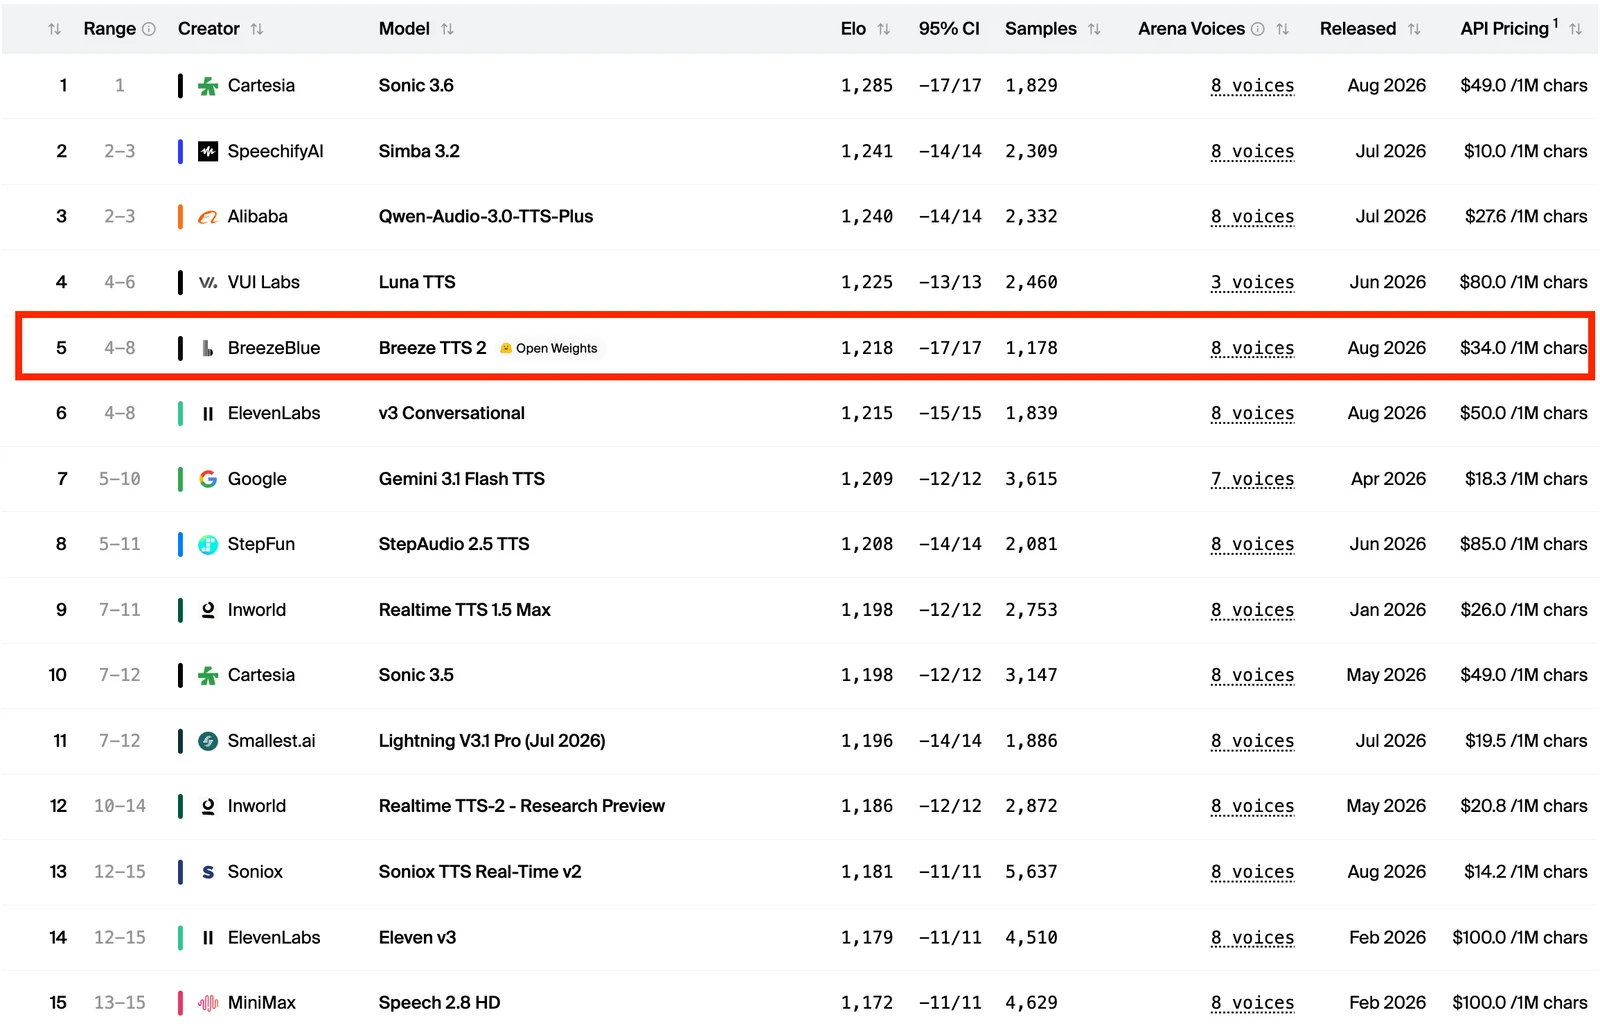
La Provider Voice Arena complète place aussi Breeze TTS 2 parmi les systèmes TTS les mieux notés toutes catégories confondues, aux côtés des meilleurs modèles propriétaires. Comme les scores de l’Arena sont mis à jour en continu à mesure que de nouveaux votes arrivent, l’image du classement complet ci-dessous reflète un instantané plus récent.
Pourquoi cette première place compte
Nous pensons que les développeurs ne devraient pas avoir à choisir entre l’accessibilité et une qualité vocale exceptionnelle. Les modèles de parole à poids ouverts offrent plus de liberté pour inspecter, évaluer et exécuter un modèle dans l’infrastructure de son équipe, mais ils ont historiquement accusé un retard de qualité perçue face aux API commerciales les plus solides.
Le résultat d’Artificial Analysis dessine un autre tableau. Dans des comparaisons en aveugle, les auditeurs ont placé Breeze TTS 2 nettement devant le reste des modèles à poids ouverts, et dans le même groupe de tête que les meilleurs systèmes TTS propriétaires.
Ce classement est donc pertinent pour les équipes qui conçoivent :
Des agents vocaux conversationnels
Des personnages de jeux vidéo et d’animation
Des livres audio et des contenus narratifs
Des workflows de doublage IA et de localisation
Des podcasts et des outils pour créateurs
Des applications de service client
Pour ces produits, la parole doit faire plus que prononcer correctement les mots. Elle doit sonner naturelle, porter une intention, conserver une identité vocale convaincante et s’adapter au contexte de l’interaction. Les tests de préférence humaine sont précieux parce que les auditeurs jugent ces qualités ensemble, au lieu de les réduire à un seul signal automatisé.
Conçu pour créer une voix et diriger son interprétation
Nous avons conçu Breeze TTS 2 pour donner à chaque personnage la bonne voix et à chaque réplique la bonne interprétation. Il associe une qualité de parole très bien notée à des contrôles pour créer et diriger les voix :
Le [Design de voix](/voice-design) crée une voix distinctive à partir d’une description en langage naturel, sans audio de référence.
Le [Clonage de voix](/voice-cloning) utilise un audio de référence et sa transcription pour préserver le timbre, le rythme, l’émotion et le style d’un locuteur.
La Direction de voix utilise des instructions en langage naturel pour orienter le ton, l’émotion, le rythme et la diction, tout en gardant la voix de référence reconnaissable.
Les Événements vocaux ajoutent des moments expressifs comme des rires, des soupirs, des toux et des raclements de gorge directement dans le script.
Le streaming en temps réel prend en charge la génération audio en flux, avec un délai jusqu’au premier audio (TTFA) inférieur à 40 ms.
La génération en anglais et en chinois est prise en charge dans la version à poids ouverts.
Ces capacités font de Breeze TTS 2 bien plus qu’une collection de voix prédéfinies. Développeurs et créateurs peuvent concevoir un personnage, préserver son identité et diriger la façon dont il interprète une réplique donnée, le tout dans un seul et même modèle.
Le résultat de l’Arena ajoute un signal externe important à cet ensemble de capacités : lorsque les auditeurs ont comparé la parole générée sans connaître le nom du modèle, Breeze TTS 2 s’est imposé comme leur premier choix parmi les modèles à poids ouverts.
Une nouvelle référence pour l’IA vocale à poids ouverts
Aucun classement public ne peut représenter tous les scripts, tous les locuteurs, toutes les langues ni tous les environnements de production. Mais la préférence humaine en aveugle constitue l’un des tests les plus clairs de l’expérience qui compte le plus : la façon dont la voix générée sonne réellement à l’oreille d’un auditeur.
Ce résultat constitue un solide point de départ. Breeze TTS 2 a obtenu :
La première place parmi les modèles TTS à poids ouverts
Un score Quality Elo de 1215
90 points d’avance sur le deuxième modèle à poids ouverts
Pour nous, ce résultat valide une idée fondatrice de Breeze TTS 2 : un modèle à poids ouverts peut produire une parole naturelle et expressive tout en donnant aux développeurs un contrôle plus poussé sur la création des voix, leur interprétation et leur déploiement.
Breeze TTS 2 est disponible dans BreezeBlue Creator et via l’API BreezeBlue. Les développeurs peuvent aussi accéder aux poids du modèle Breeze TTS 2 sur Hugging Face et au code d’inférence PyTorch officiel sur GitHub.