Breeze TTS 2 现已成为 Artificial Analysis Provider Voice Arena 排行榜上排名第一的开放权重文本转语音模型,Quality Elo 分数为 1215。
在 2026 年 8 月 26 日的排行榜快照中,Breeze TTS 2 领先 Artificial Analysis 评测的所有其他开放权重 TTS 模型,比第二名 Fish Audio S2 Pro 高出 90 个 Elo 分,比第三名 Step Audio EditX 高出 113 分。
对 BreezeBlue 和整个开放权重语音 AI 领域来说,这都是一个重要的里程碑。这一排名基于盲听条件下的人工偏好,而不是厂商自选的分数或自动化音频指标,由此确立了 Breeze TTS 2 在这项独立 TTS 评测中开放权重模型的最高评分。
什么是 Artificial Analysis TTS Arena?
Artificial Analysis Text to Speech Arena 是一项独立基准测试,通过盲听、一对一对比的方式评估语音生成模型。
在每一次对比中,听众会听到由同一段文本生成的两段音频,但不知道分别出自哪个模型。他们选出听起来更自然的一段,Artificial Analysis 再把这些偏好汇总为相对的 Quality Elo 分数。Elo 分数越高,说明与 Arena 中其他模型相比,听众更常偏向该模型。
这份排行榜旨在捕捉真实听众感受到的语音质量,涵盖以下方面:
自然度
音频质量
发音
语速节奏
韵律与表现力
在 Provider Voice Arena 中,Artificial Analysis 会用每个模型可用音色中具有代表性的一组来评测,力求覆盖美式和英式口音的男声与女声,每个模型最多八个音色。因此最终分数反映的是使用该模型各音色的整体体验,而不是某一个精心挑选的演示样本。
Artificial Analysis 还会公布样本数量、置信区间、类别筛选和口音筛选,帮助读者解读排名。Elo 是一种相对度量,随着新投票不断收集、新模型不断加入 Arena,分数可能发生变化。
Breeze TTS 2 领跑开放权重排行榜
Provider Voice Arena 中排名前五的开放权重模型如下:
| 排名 | 模型 | 开发方 | Quality Elo |
|---|---|---|---|
| 1 | Breeze TTS 2 | BreezeBlue | 1215 |
| 2 | Fish Audio S2 Pro | Fish Audio | 1125 |
| 3 | Step Audio EditX (March 2026) | StepFun | 1102 |
| 4 | Voxtral TTS | Mistral | 1082 |
| 5 | Magpie-Multilingual 357M | NVIDIA | 1066 |
Breeze TTS 2 领先最接近的开放权重竞品 90 分。在 Elo 体系中,每个分数都由听众在整个模型池中的偏好相对决定,因此这一领先幅度有力地说明了听众选择 Breeze TTS 2 的一致程度。
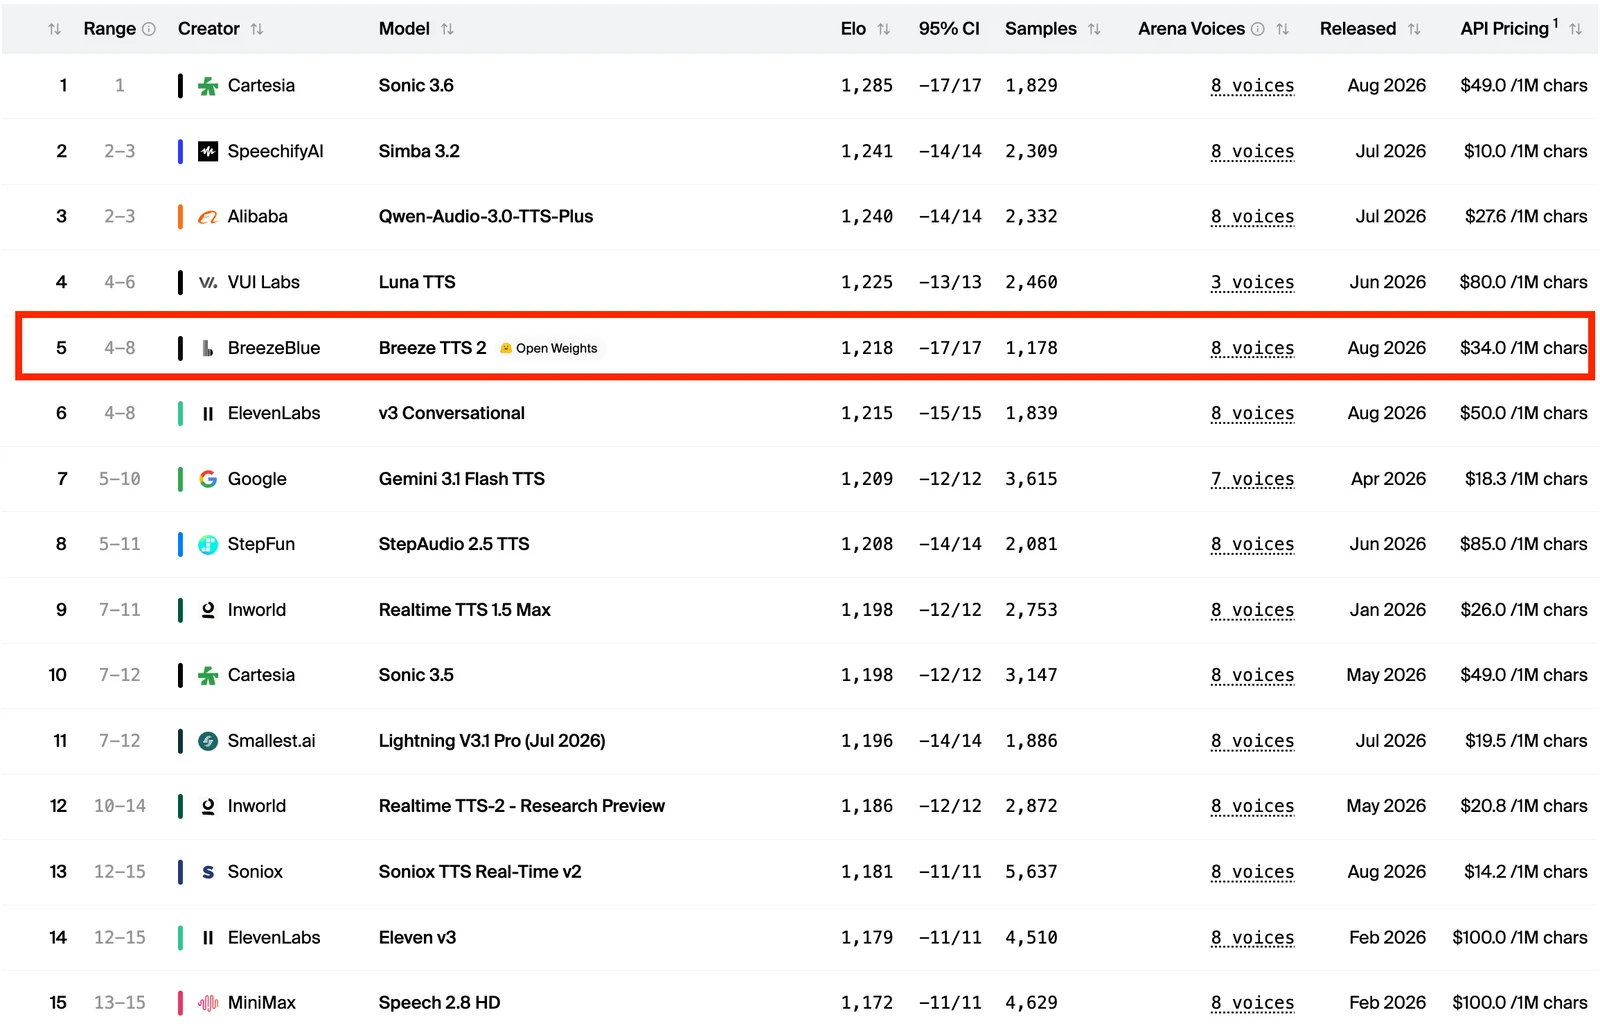
在完整的 Provider Voice Arena 排行榜中,Breeze TTS 2 也与领先的闭源模型一起位列评分最高的 TTS 系统之列。由于 Arena 分数会随新投票持续更新,下方的完整排行榜图片对应的是一个更晚的快照。
这个第一名为什么重要
我们认为,开发者不应该在开放获取和顶级语音质量之间二选一。开放权重语音模型让团队可以更灵活地审视、评估模型,并在自己的基础设施中运行,但在感知质量上,它们长期落后于最强的商业 API。
Artificial Analysis 的结果给出了不同的答案。在盲听对比中,听众把 Breeze TTS 2 明显排在其他开放权重模型之前,并与领先的闭源 TTS 系统处于同一梯队。
因此,这一排名对以下产品的团队尤其有参考价值:
对话式语音 agent
游戏与动画角色
有声书与叙事内容
AI 配音与本地化工作流
播客与创作者工具
客服应用
对这些产品来说,语音不只是把字念对。它需要听起来自然、传达意图、保持可信的声音身份,并贴合交互场景。人工偏好测试的价值就在于,听众是把这些品质放在一起综合判断的,而不是把它们压缩成一个自动化指标。
为设计音色、执导演绎而生
我们打造 Breeze TTS 2,是为了让每个角色都有合适的声音,让每句台词都有合适的演绎。它把高评分的语音质量与创建、执导音色的控制能力结合在一起:
[音色设计](/voice-design)根据自然语言描述创造独特的音色,无需参考音频。
[音色克隆](/voice-cloning)利用参考音频及其文稿,保留说话人的音色、节奏、情绪和风格。
指令遵循通过自然语言指令控制语气、情绪、语速和表达方式,同时保持参考音色的辨识度。
人声事件可直接在脚本中加入笑声、叹气、咳嗽、清嗓等富有表现力的瞬间。
实时流式生成支持流式输出音频,首音频时间(TTFA)低于 40 ms。
中英文生成在开放权重版本中均已支持。
这些能力让 Breeze TTS 2 不只是一组预设音色。开发者和创作者可以在同一个模型中设计角色、保持其身份,并执导它如何演绎某一句台词。
Arena 的结果为这套能力增添了一个重要的外部信号:当听众在不知道模型名称的情况下比较生成的语音时,Breeze TTS 2 成为他们在开放权重模型中的首选。
开放权重语音 AI 的新标杆
没有任何公开排行榜能覆盖所有脚本、说话人、语言或生产环境。但盲听人工偏好是对最关键体验最清晰的检验之一:生成的声音在听众耳中究竟是什么样。
这一结果是一个有力的起点。Breeze TTS 2 取得了:
开放权重 TTS 模型中的第一名
1215 的 Quality Elo 分数
领先第二名开放权重模型 90 分
对我们而言,这一结果印证了 Breeze TTS 2 背后的核心理念:开放权重模型也能生成自然、富有表现力的语音,同时让开发者在音色创建、演绎和部署上拥有更深入的控制。
Breeze TTS 2 可通过 BreezeBlue Creator 和 BreezeBlue API 使用。开发者也可以获取 Hugging Face 上的 Breeze TTS 2 模型权重以及 GitHub 上的官方 PyTorch 推理代码。