BreezeRT maintient une faible latence du premier paquet pour Breeze TTS 2, même avec de nombreuses requêtes simultanées. Nous réduisons les attentes dans l’ordonnancement des requêtes, le découpage audio et l’exécution GPU, puis utilisons Predictor pour planifier le premier audio et les blocs suivants. Les nouvelles requêtes démarrent rapidement, tandis que la parole en cours continue d’être diffusée.
Vue d’ensemble des optimisations BreezeRT
| Optimisation | Effet |
|---|---|
| 1. Ordonnancement unifié en plusieurs étapes | Moins d’attente |
| 2. Blocs progressifs et décodage incrémental | C16 TTFB p50: 1626 → 136 ms |
| 3. Compilation de Depth et CUDA Graphs | C16 TTFB p50: 136 → 85 → 38 ms |
| 4. Predictor : échéances du premier audio et de la lecture | Requêtes avec risque d’interruption sur 300: 14 → 0 |
Comparaison des frameworks d’inférence
Tous les tests de cet article ont été réalisés sur un seul GPU H100. Nous avons retesté PyTorch, vLLM-Omni et SGLang-Omni avec les textes test-en originaux de Seed-TTS, sans audio de référence. Le graphique compare ces implémentations à BreezeRT, avec le même modèle Breeze TTS 2 pour 1–16 requêtes simultanées. À 16 requêtes simultanées, BreezeRT atteint une latence du premier paquet de 38 / 52 ms en p50 / p95.
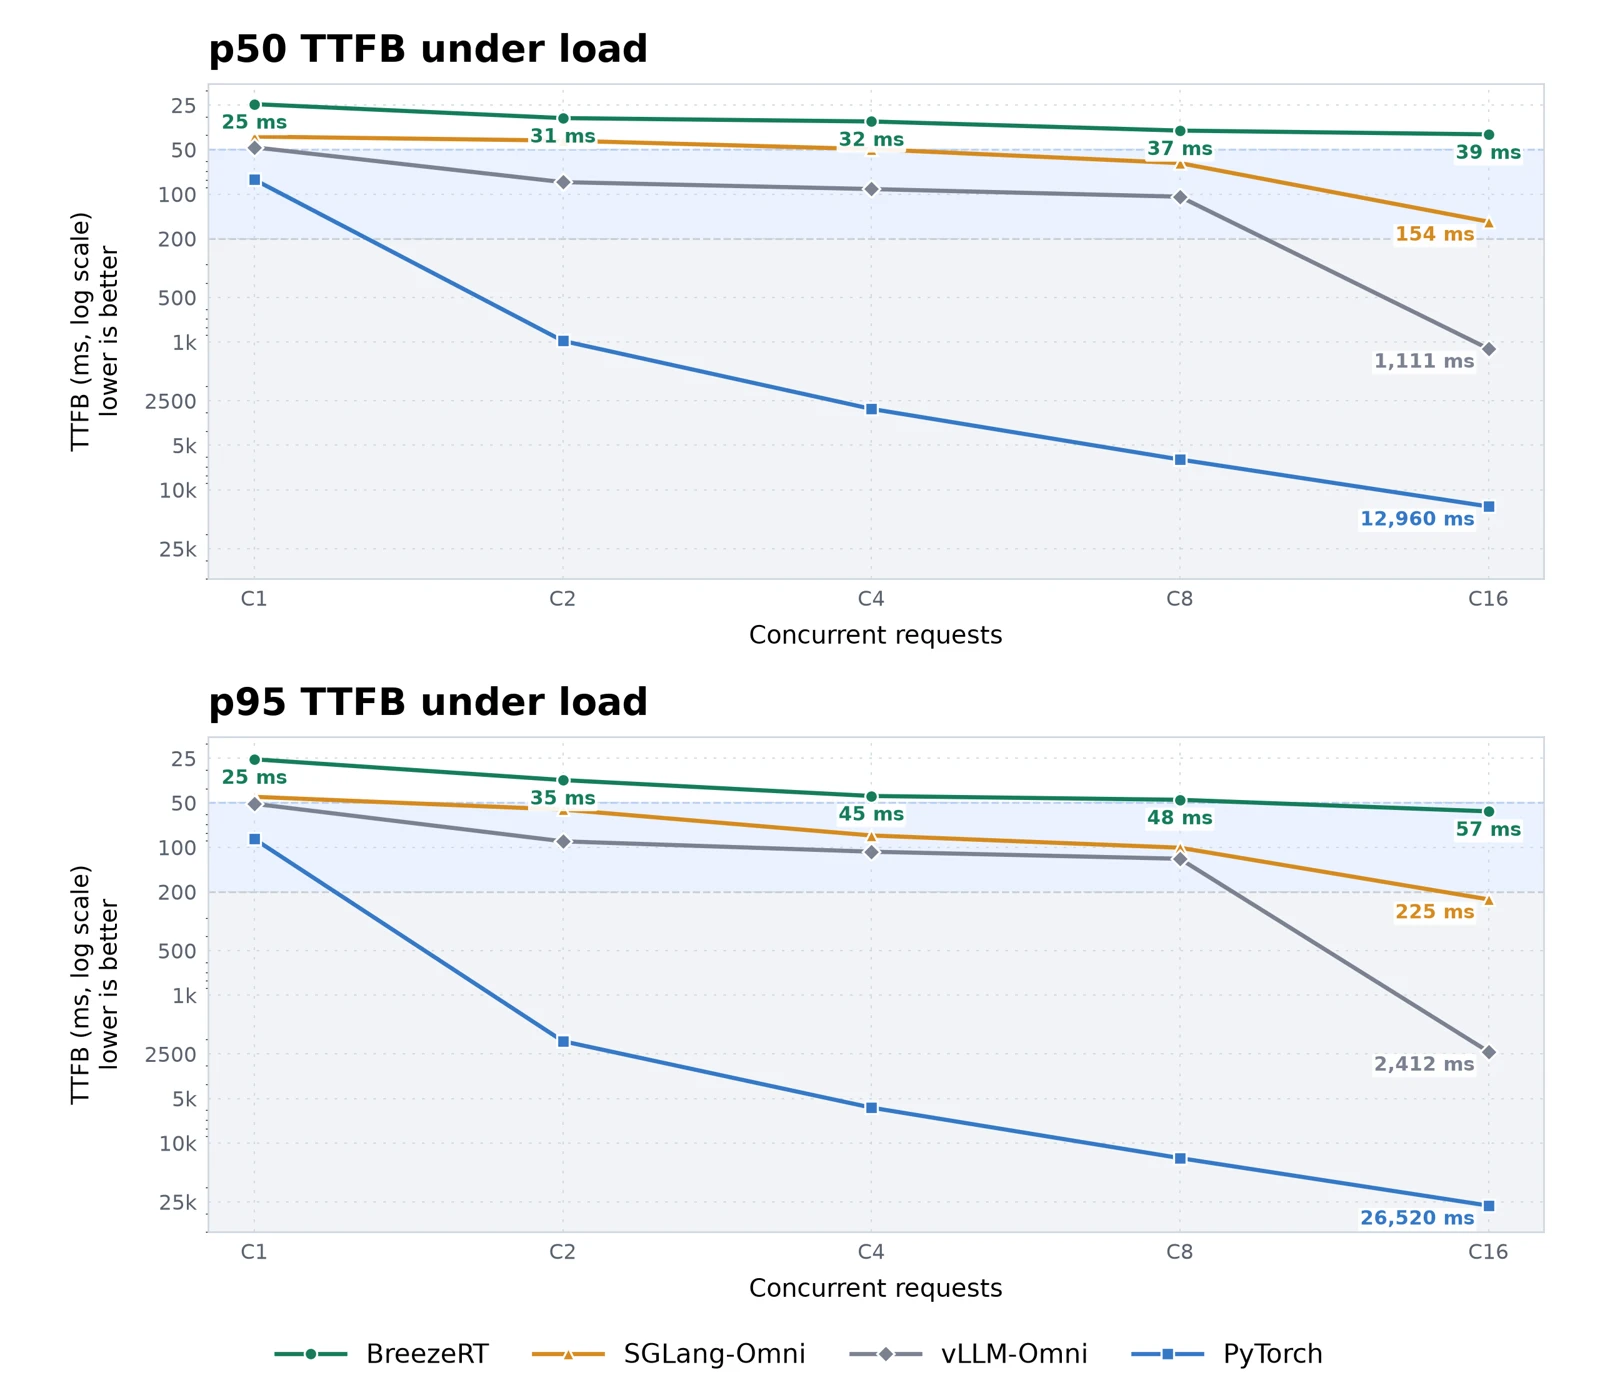
Nous avons adapté et optimisé PyTorch, vLLM-Omni et SGLang-Omni pour Breeze TTS 2. Le graphique présente la latence du premier paquet de ces implémentations. Nos adaptations n’ont pas encore été intégrées à leurs dépôts open source.
Les quatre optimisations de BreezeRT
1. Ordonnancement unifié en plusieurs étapes
Breeze TTS 2 encode d’abord le texte et exécute Backbone Prefill. Pour chaque trame vocale, le Backbone prédit le premier code audio, le Depth Decoder génère les 15 codes restants et le Codec produit les échantillons de la forme d’onde. Chaque étape a ses propres besoins de calcul, sa fréquence d’exécution et ses tailles de lot adaptées.
Les requêtes simultanées se trouvent souvent à des étapes différentes : A dispose de codes audio prêts à être décodés, B génère sa prochaine trame et C vient d’arriver et attend son premier audio. Continuer avec A ferait attendre B et C. L’ordonnanceur doit passer d’une requête à l’autre avant qu’une phrase entière soit terminée.
BreezeRT ordonnance séparément le traitement du texte, Backbone Prefill, Backbone Decode, Depth et le décodage audio. Un même environnement d’exécution gère la progression des requêtes, les caches et l’audio en attente. Après chaque étape, il choisit l’étape et les requêtes à exécuter ensuite.
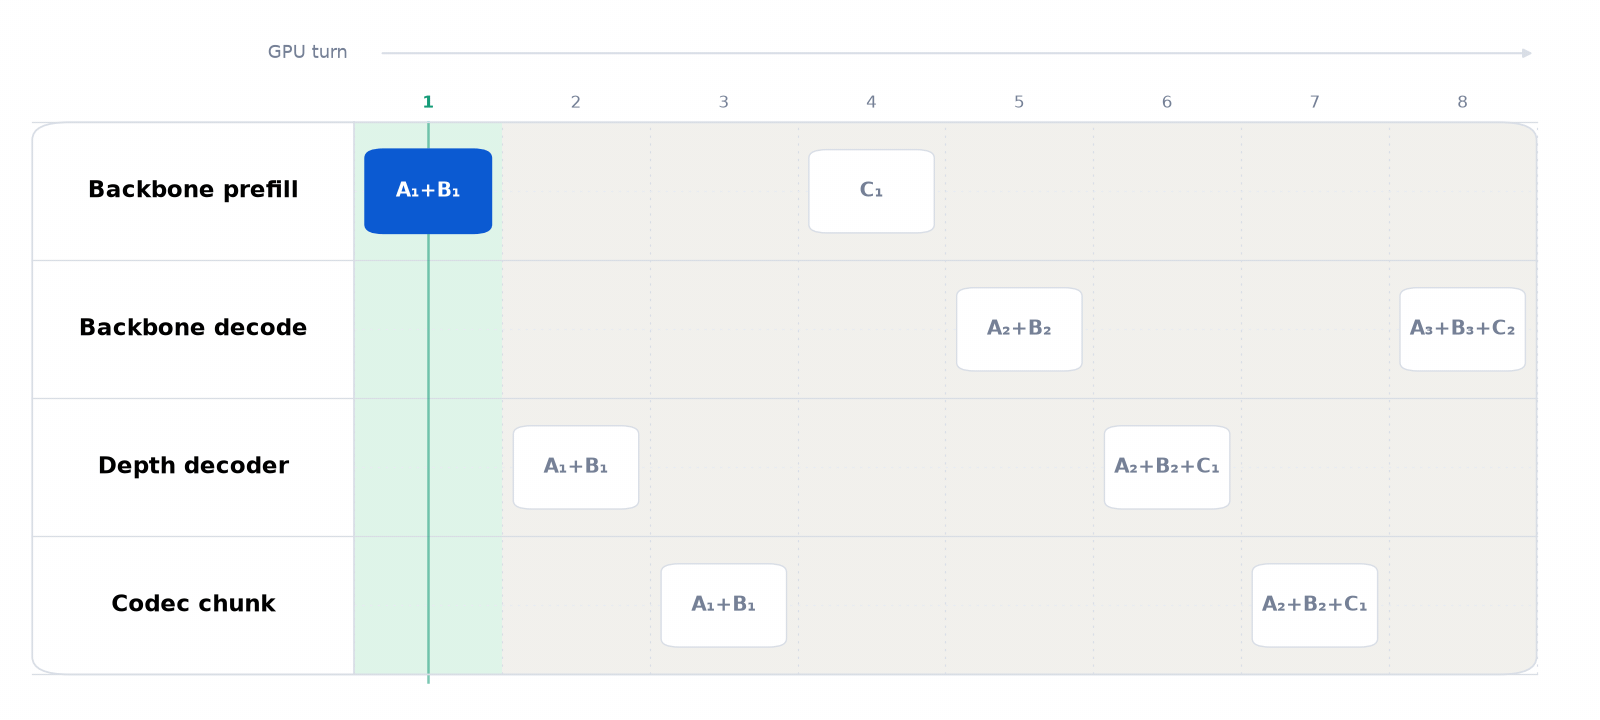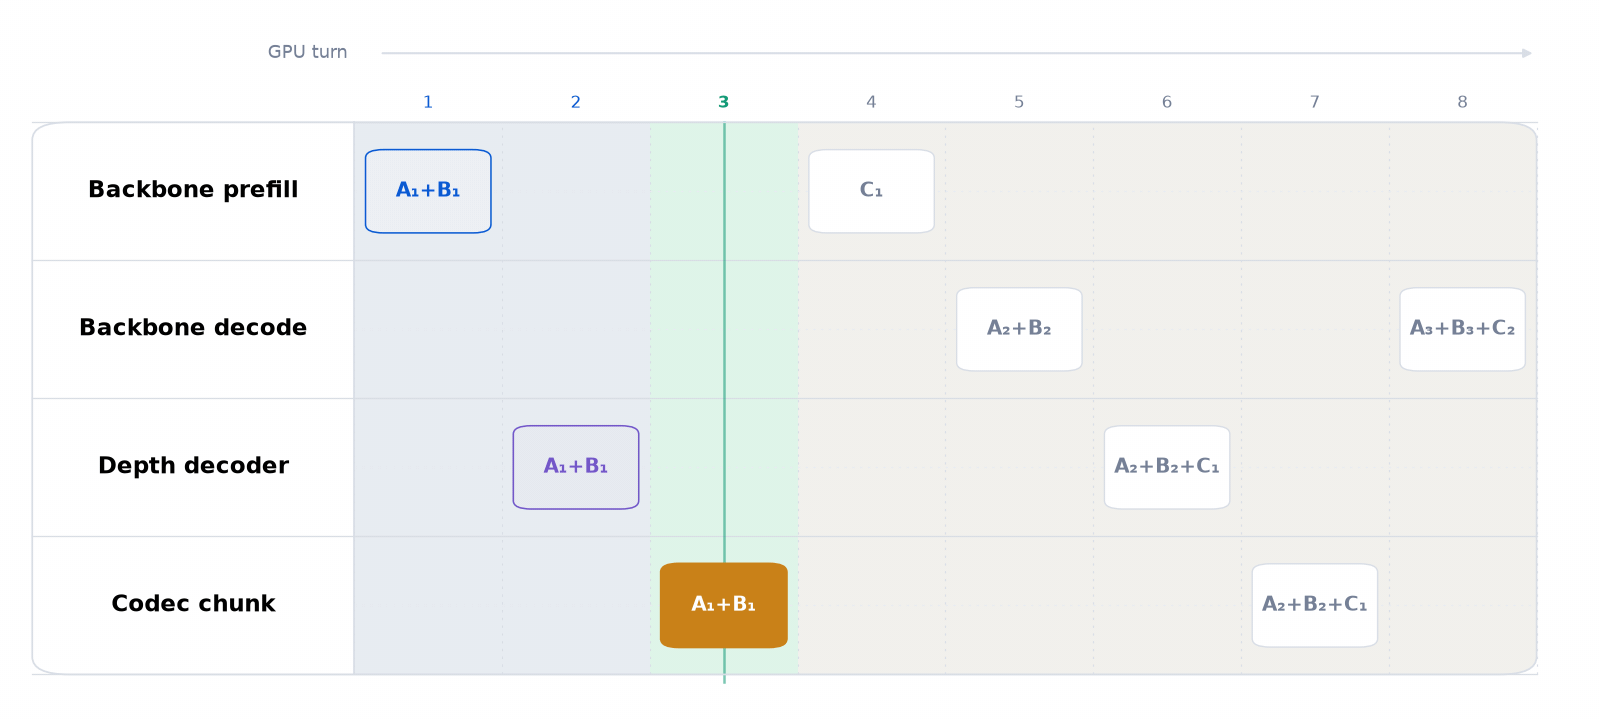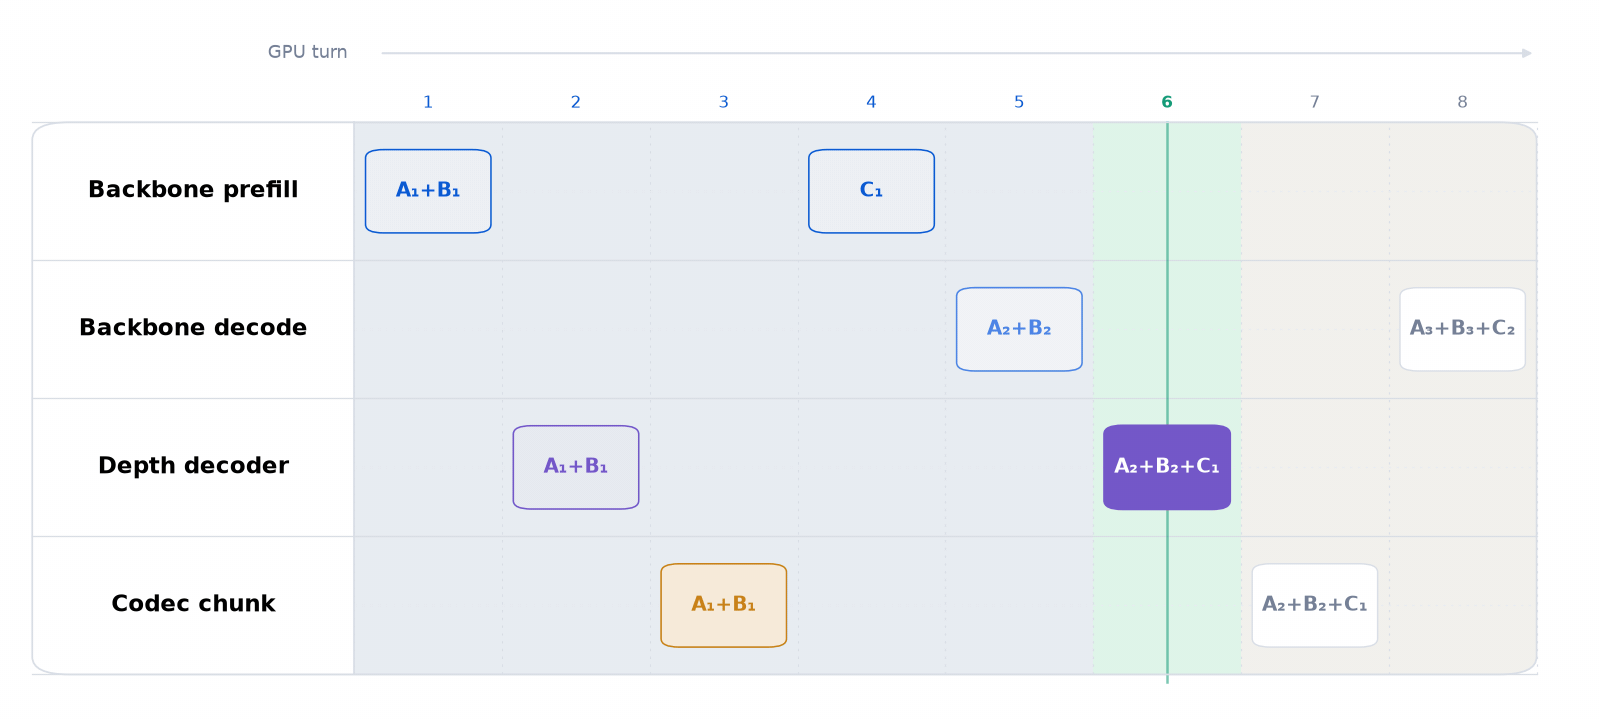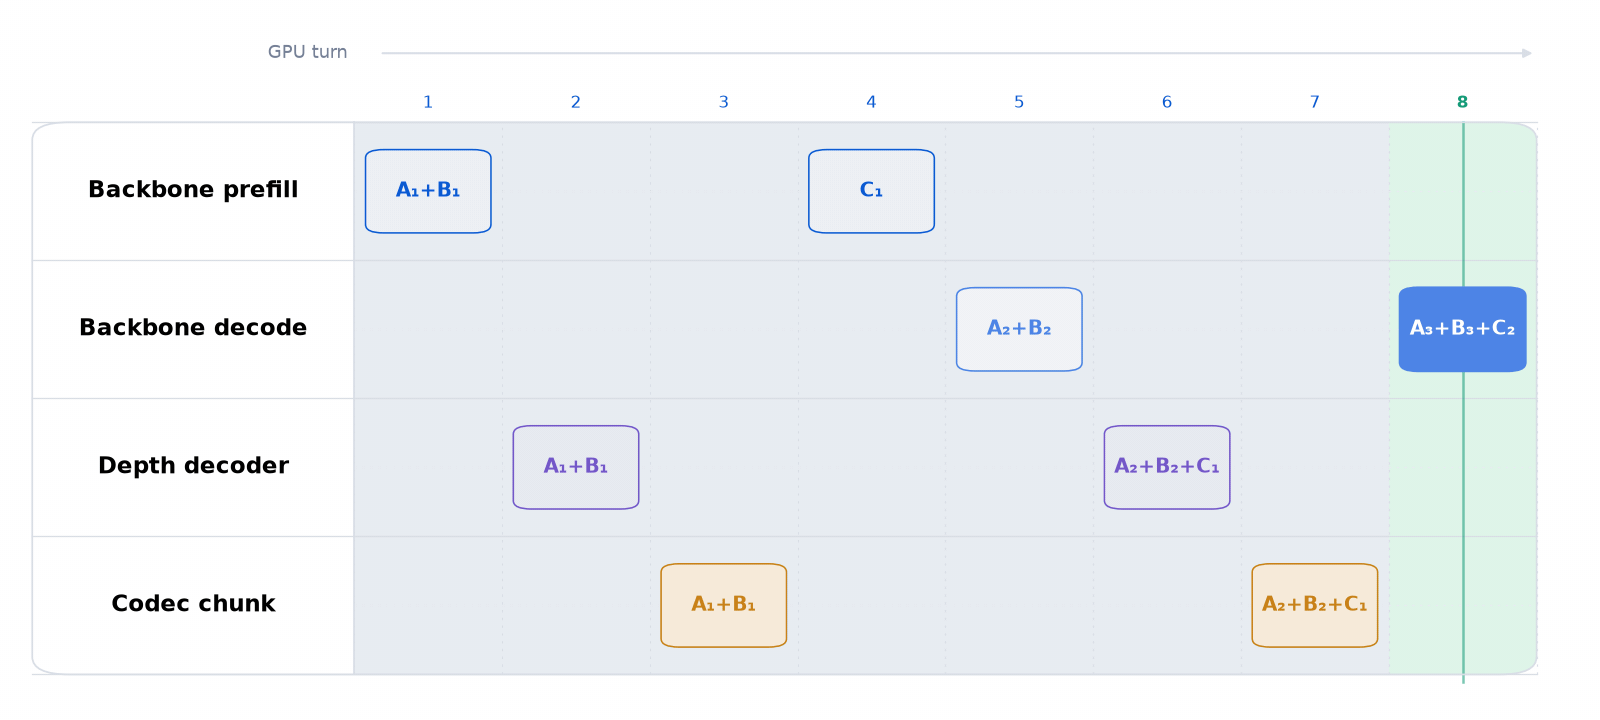
L’ordonnanceur choisit les requêtes par priorité, puis regroupe le travail en lots au sein de l’étape choisie. Chaque étape possède sa propre limite de taille de lot, ce qui permet au Codec et au Backbone d’utiliser des tailles différentes. De nouvelles requêtes peuvent entrer entre les étapes, et les flux actifs disposent de temps pour le décodage. Le même environnement d’exécution gère le découpage en blocs, la réexécution des graphes et l’ordonnancement selon les échéances.
2. Blocs progressifs et décodage incrémental
Un premier bloc plus grand oblige l’utilisateur à attendre davantage de trames avant d’entendre l’audio. Mais envoyer une seule trame à la fois impose d’exécuter le Codec et l’ordonnanceur plus souvent. Ce surcoût s’accumule à mesure que le nombre de requêtes augmente.
BreezeRT augmente progressivement la taille des blocs, en utilisant par exemple 1, 2, 4, 8 et 16 trames. Les petits blocs permettent de démarrer rapidement la lecture. Une fois de l’audio mis en mémoire tampon, les blocs plus grands réduisent le nombre d’appels de décodage.
Le Codec doit également conserver le travail précédent pour ne pas décoder le même audio à nouveau. BreezeRT stocke, pour chaque requête, les KV du Transformer à fenêtre glissante, l’historique de convolution causale et la fin de chevauchement de la convolution transposée, puis ne traite que les nouvelles trames. Ces caches préservent le contexte et assurent des transitions fluides entre les blocs lorsque leur taille change.
L’ablation est exécutée sur un seul GPU H100 à 16 requêtes simultanées, en mesurant la latence p50 du premier paquet sur 300 requêtes par configuration. Un premier bloc fixe de 16 trames donne 1626 ms ; les blocs progressifs ramènent cette valeur à 136 ms.
3. Compilation de Depth et CUDA Graphs
Avec un premier bloc plus petit, le surcoût de lancement côté CPU devient plus visible. Générer une trame vocale nécessite de nombreuses opérations du modèle. Même un GPU rapide peut rester inactif entre les soumissions. BreezeRT réduit le surcoût de calcul grâce à la compilation et utilise CUDA Graphs pour soumettre les opérations GPU capturées en une seule réexécution.
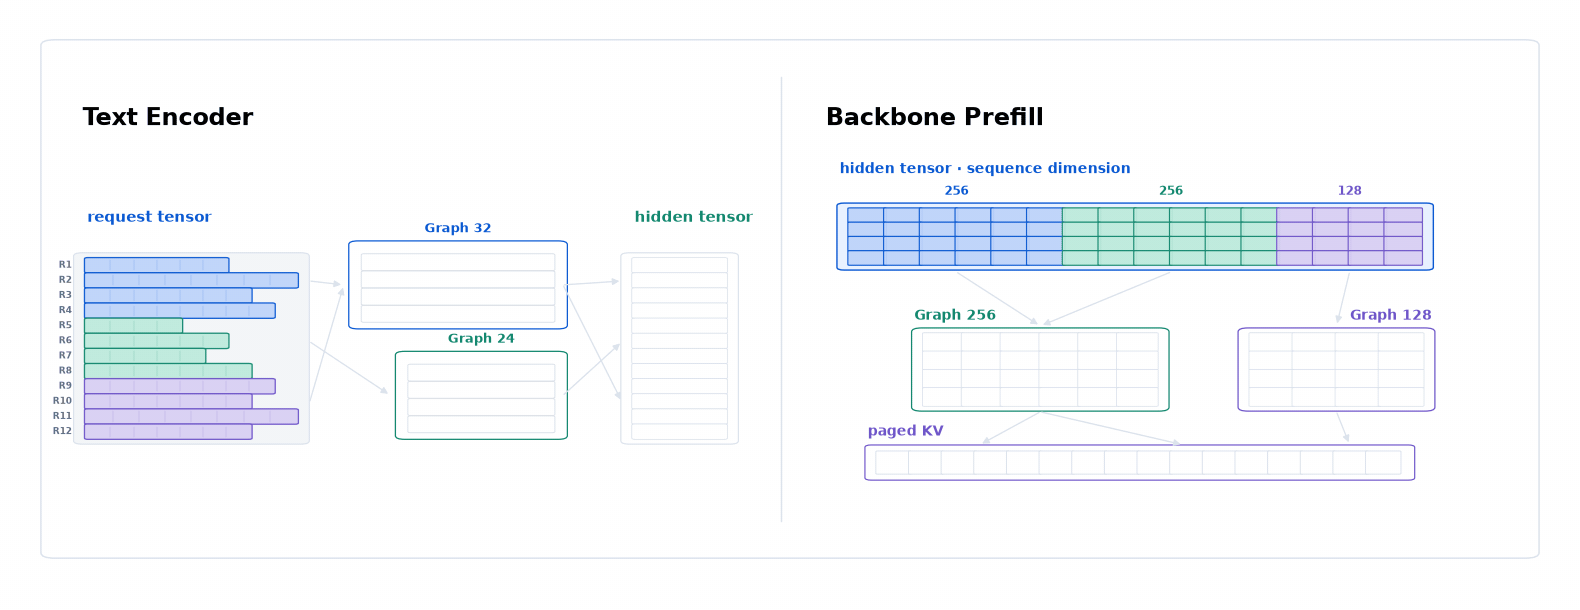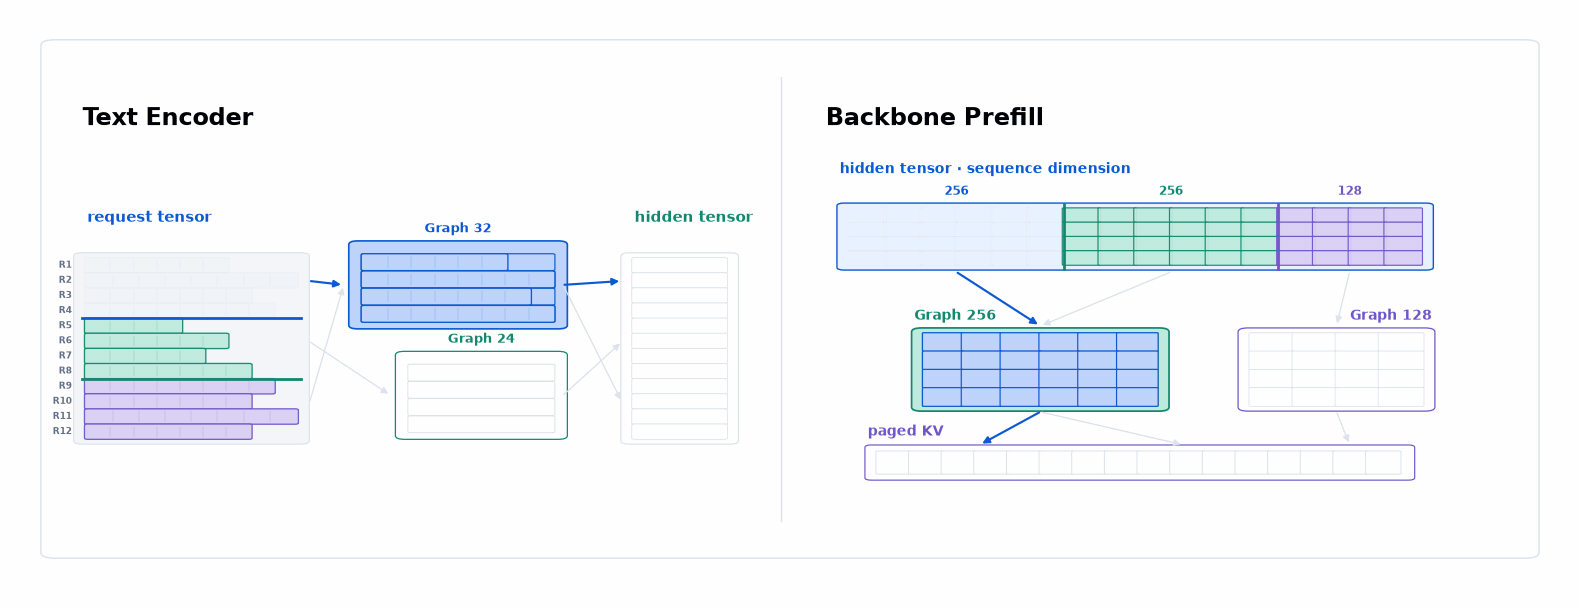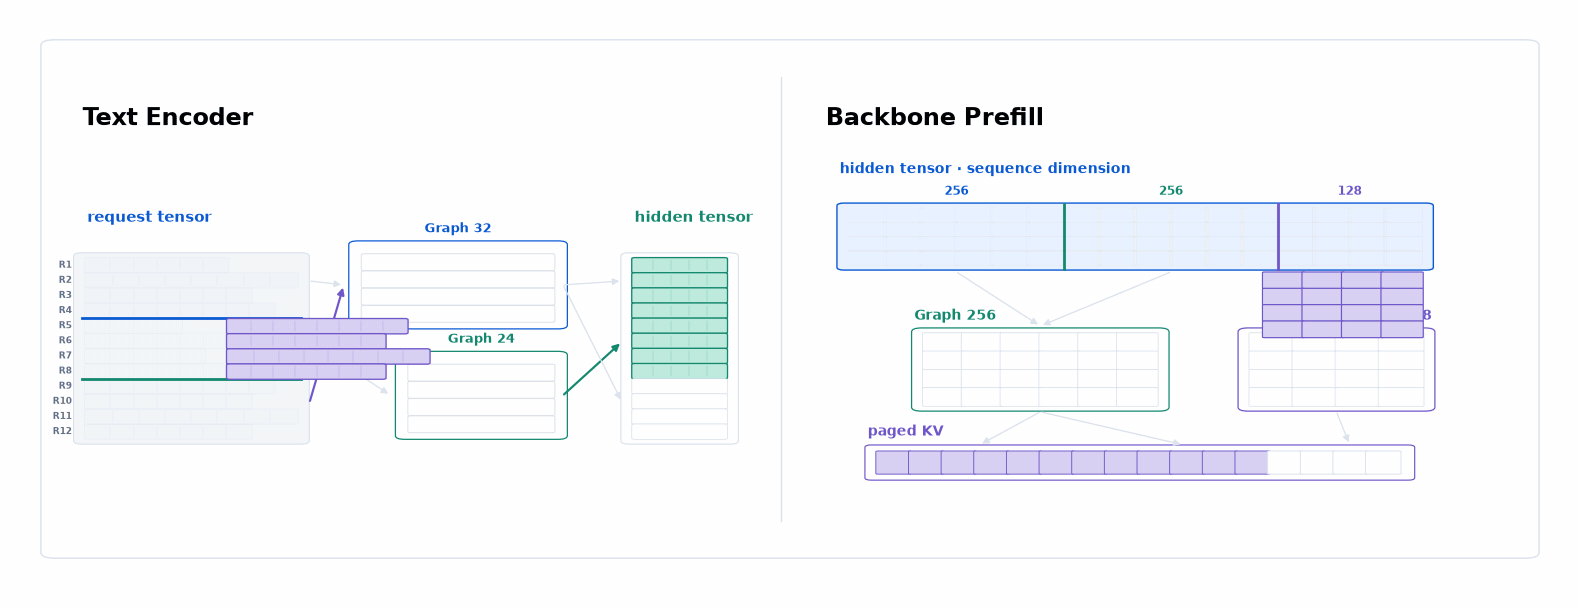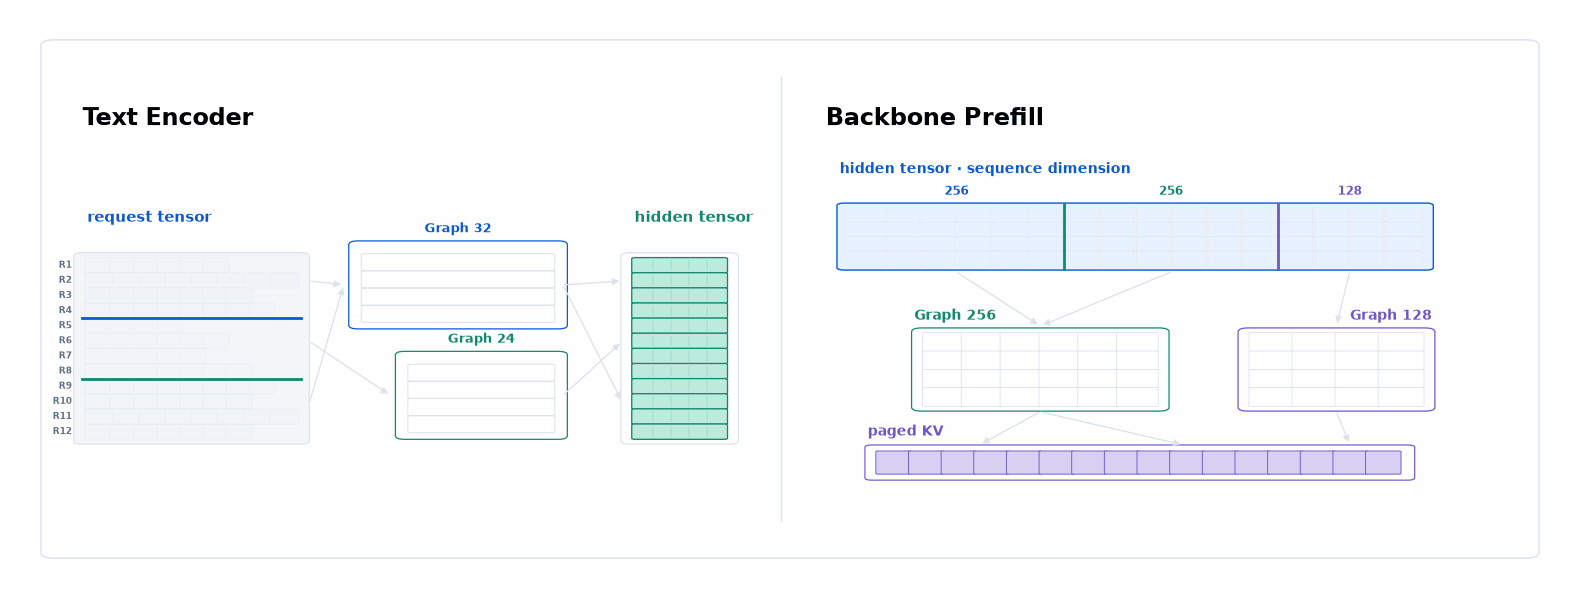
La réexécution d’un CUDA Graph exige des formes de tenseurs fixes, mais les longueurs de texte, les tailles de lot et les tailles de bloc audio varient. Capturer chaque combinaison consommerait trop de mémoire. BreezeRT conserve un ensemble de formes courantes et découpe ou complète les entrées pour les y adapter.
Le Text Encoder regroupe les tokens et répartit le travail selon le nombre de requêtes et la capacité en tokens pour réduire le remplissage. L’attention reste distincte pour chaque requête. Backbone Prefill fonctionne par blocs de tokens, avec un cache KV paginé qui stocke l’historique de génération de chaque requête pour réutiliser les graphes et les buffers existants.
Le Depth Decoder génère 15 codes audio supplémentaires par trame. BreezeRT compile la pile du décodeur et les têtes de sortie comme des unités entières, en fusionnant les opérations élément par élément compatibles dans un plus petit nombre de kernels. Cela réduit les lectures et écritures de tenseurs intermédiaires ainsi que les lancements de kernels, un travail répété qui s’accumule entre les requêtes simultanées. Les buffers KV, de position et d’entrée/sortie sont alloués à l’avance. La boucle autorégressive complète est capturée dans un seul graphe : une seule réexécution lance donc les 15 étapes dans l’ordre de leurs dépendances.
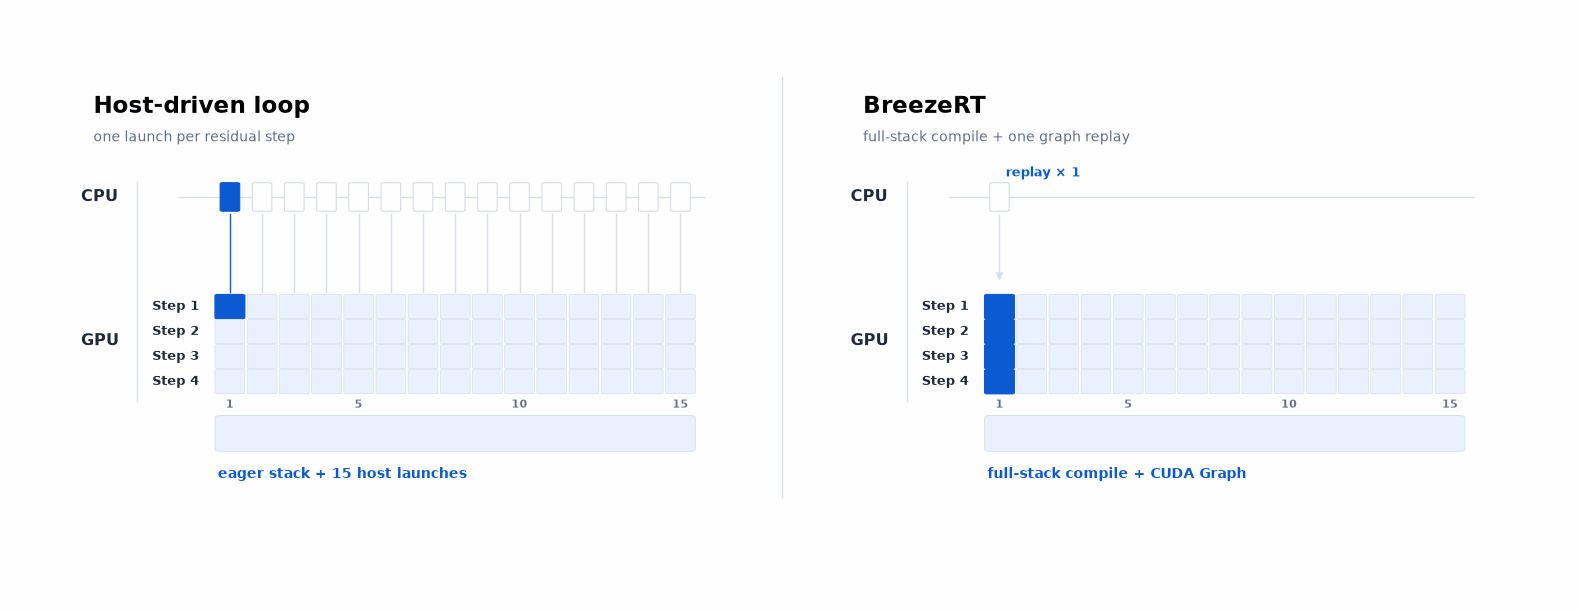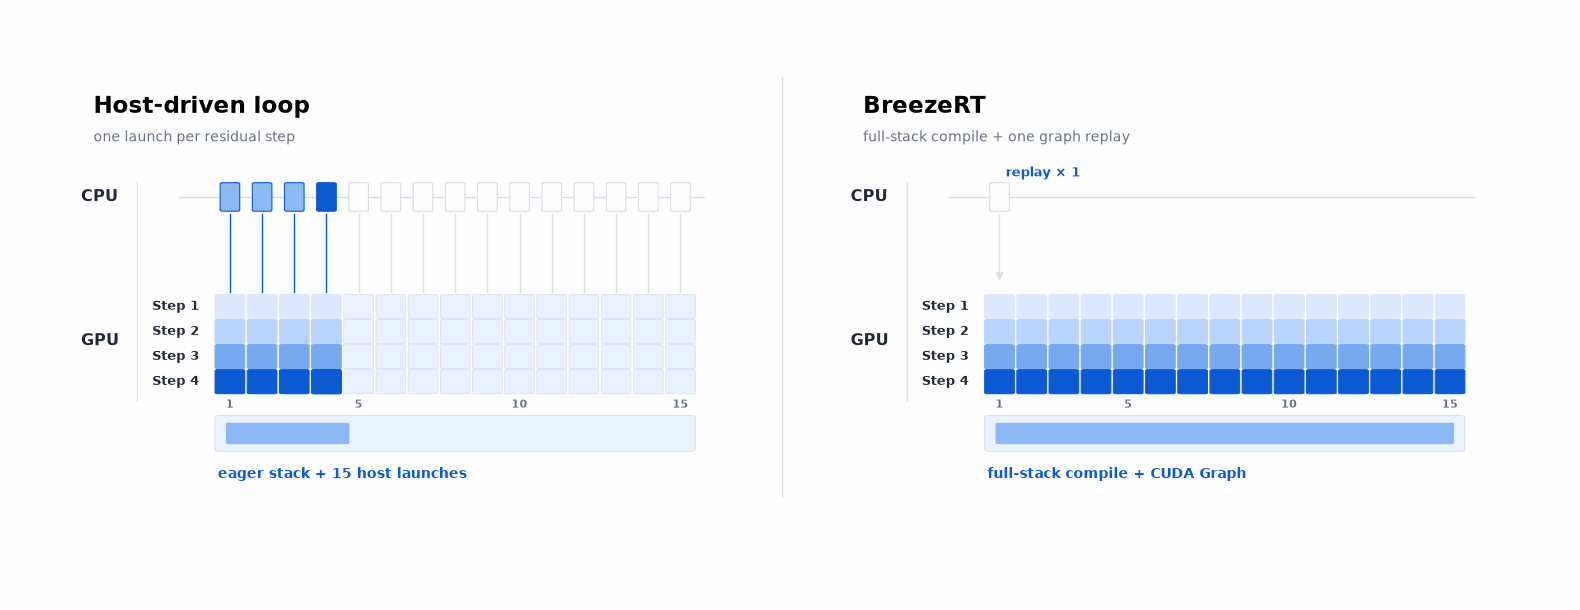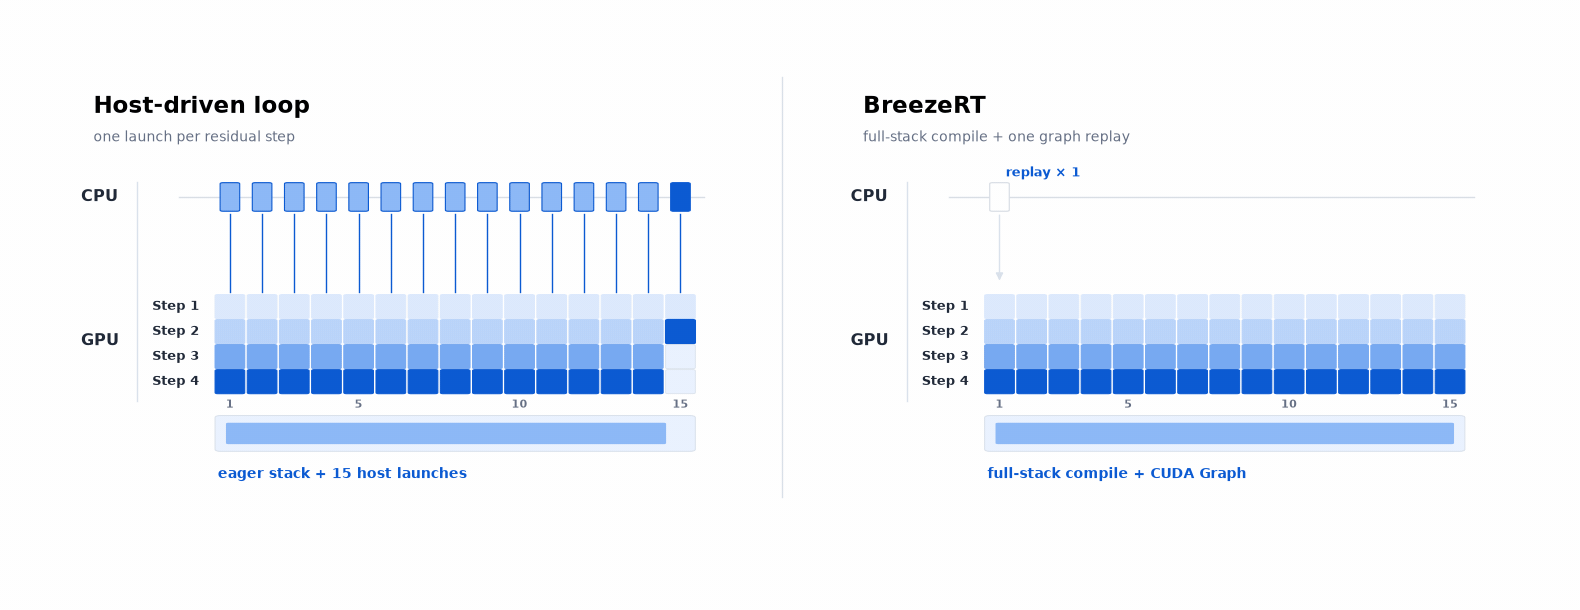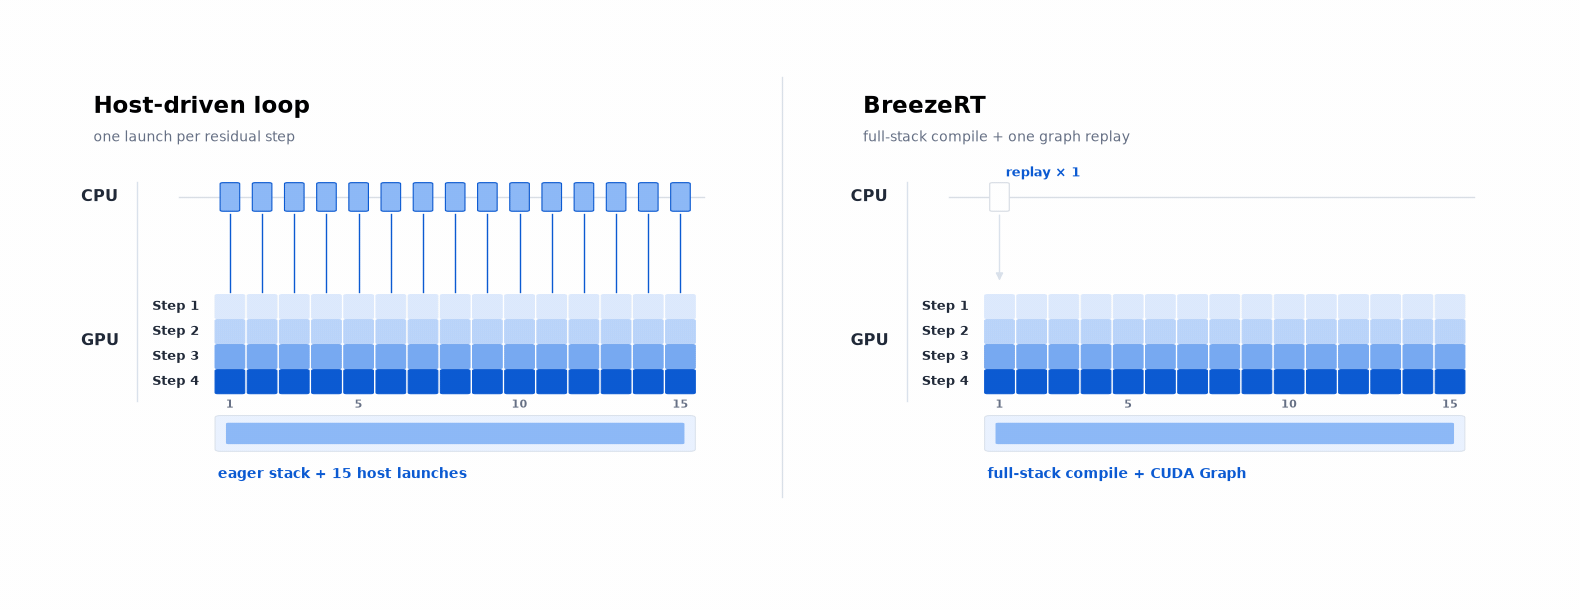
L’encodage du texte, le Backbone, Depth et le décodage audio utilisent tous des graphes, les formes courantes étant préchauffées au démarrage. Chaque requête conserve ses propres paramètres d’échantillonnage et son état aléatoire. Dans la même ablation C16, à découpage inchangé, la latence p50 du premier paquet passe de 136 ms à 85 ms avec la compilation de Depth, puis à 38 ms avec des graphes à toutes les étapes.
4. Predictor : échéances du premier audio et de la lecture
Les nouvelles requêtes attendent de commencer à parler ; les flux actifs attendent leur prochain bloc. Toujours servir les nouvelles requêtes en premier peut interrompre la lecture. Générer trop en avance pour les flux actifs fait attendre les nouvelles requêtes. Predictor utilise les échéances de lecture pour décider quel travail traiter en premier.
Les nouvelles requêtes sont prioritaires au démarrage. Pour les flux actifs, l’heure de la première sortie et la durée audio totale donnent une échéance de lecture estimée. Predictor enregistre les durées récentes des étapes par taille de lot et prévoit une marge pour estimer si le travail restant du Backbone, de Depth et du Codec peut être terminé à temps.
Par exemple, A est prêt pour le décodage, tandis que B a besoin d’une étape de génération supplémentaire pour rejoindre son lot. L’ordonnanceur attend B si le regroupement fait gagner du temps tout en respectant l’échéance de lecture de A. Sinon, A s’exécute en premier. Si le bloc cible ne peut pas être terminé à temps, l’environnement d’exécution peut envoyer les trames déjà générées au lieu de faire attendre le lecteur.
Predictor utilise une estimation légère des durées. Dans une comparaison portant sur 300 requêtes, le nombre de requêtes présentant des interruptions potentielles de lecture est passé de 14 à 0. D’après les heures d’arrivée des paquets audio, sans Predictor, la lecture devrait, dans le pire des cas, mettre en mémoire tampon environ 330 ms d’audio supplémentaire à l’avance pour éviter les interruptions. Lors de la nouvelle exécution avec Predictor activé, la lecture a pu démarrer à l’arrivée du premier paquet et se poursuivre sans aucune attente supplémentaire.