BreezeRT는 높은 동시 요청 수에서도 Breeze TTS 2의 첫 패킷 지연을 낮게 유지합니다. 요청 스케줄링, 오디오 청킹, GPU 실행의 대기 시간을 줄이고, Predictor로 첫 오디오와 후속 청크를 스케줄링합니다. 새 요청은 빠르게 발화를 시작하고, 진행 중인 음성은 계속 재생됩니다.
BreezeRT 최적화 개요
| 최적화 | 효과 |
|---|---|
| 1. 통합 다단계 스케줄링 | 대기 시간 단축 |
| 2. 점진적 청킹과 증분 디코딩 | 첫 요청의 TTFB: ~2500 → 150 ms |
| 3. Depth 컴파일과 CUDA Graphs | 첫 요청의 TTFB: ~150 → 100 → 35 ms |
| 4. Predictor: 첫 오디오와 재생 기한 | 300개 요청 중 재생 끊김 가능성이 있는 요청 수: 14 → 0 |
추론 프레임워크 비교
이 글의 모든 테스트는 H100에서 실행했습니다. 동일한 Breeze TTS 2 모델로 동시 요청 1–16개 조건에서 PyTorch, vLLM-Omni, SGLang-Omni, BreezeRT를 비교했으며, 첫 패킷 지연에 초점을 맞췄습니다.
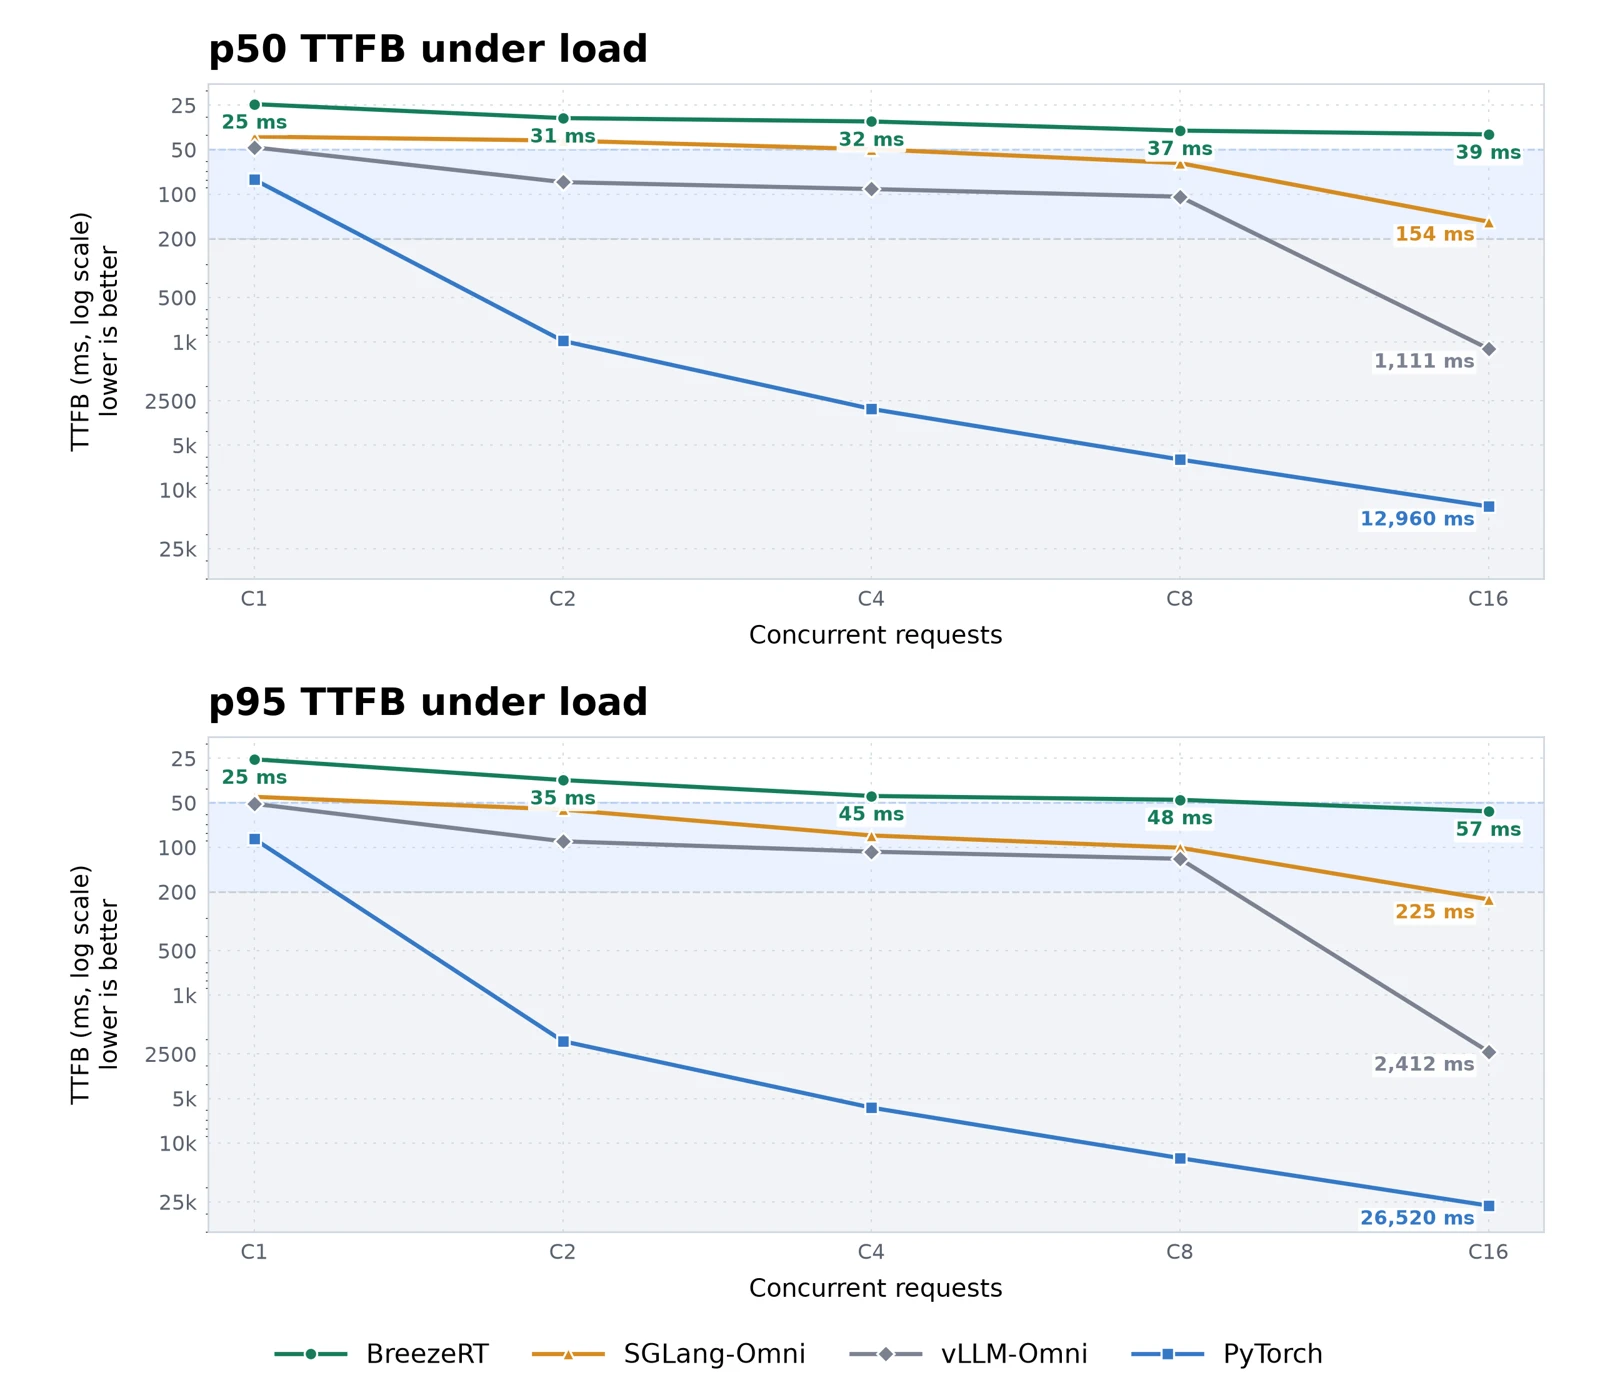
PyTorch, vLLM-Omni, SGLang-Omni가 Breeze TTS 2를 지원하도록 수정하고 튜닝했습니다. 차트는 각 프레임워크에서 측정한 결과 중 가장 좋은 결과를 보여줍니다. 이 수정 사항은 아직 각 오픈 소스 저장소에 병합되지 않았습니다.
1. 통합 다단계 스케줄링
Breeze TTS 2는 먼저 텍스트를 인코딩하고 Backbone Prefill을 실행합니다. 각 음성 프레임에서 Backbone은 첫 번째 오디오 코드를 예측하고, Depth Decoder는 나머지 15개 코드를 생성하며, Codec은 파형 샘플을 출력합니다. 각 단계는 필요한 연산량, 실행 빈도, 적합한 배치 크기가 다릅니다.
동시 요청은 서로 다른 단계에 있는 경우가 많습니다. A는 오디오 코드 디코딩 준비가 끝났고, B는 다음 프레임을 생성하고 있으며, C는 방금 도착해 첫 오디오를 기다리고 있을 수 있습니다. A를 계속 처리하면 B와 C는 기다려야 합니다. 스케줄러는 한 문장 전체가 완성되기 전에 요청 사이를 전환해야 합니다.
BreezeRT는 텍스트 처리, Backbone Prefill, Backbone Decode, Depth, 오디오 디코딩을 각각 스케줄링합니다. 하나의 런타임이 요청 진행 상태, 캐시, 출력 대기 중인 오디오를 관리합니다. 각 단계가 끝나면 다음에 실행할 단계와 요청을 선택합니다.
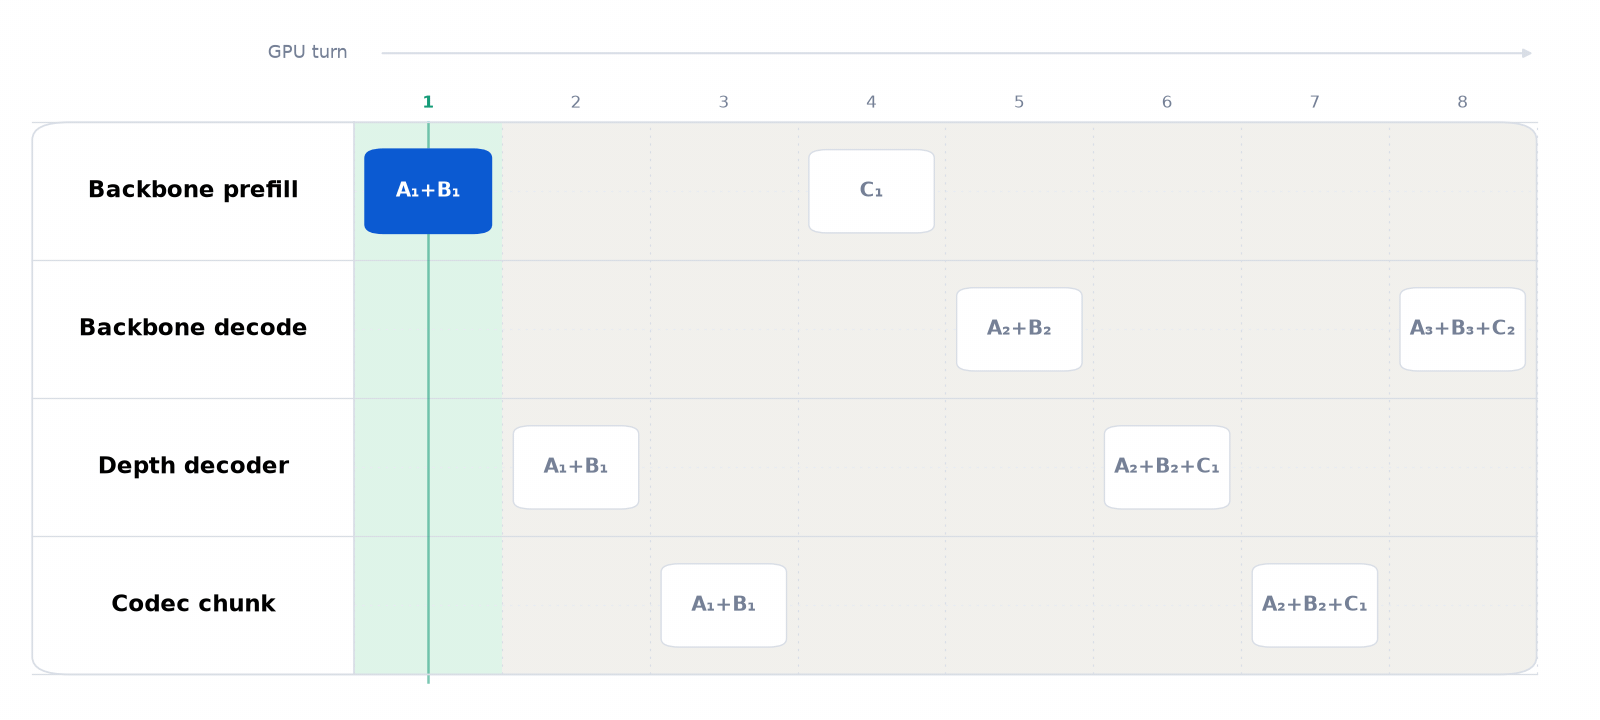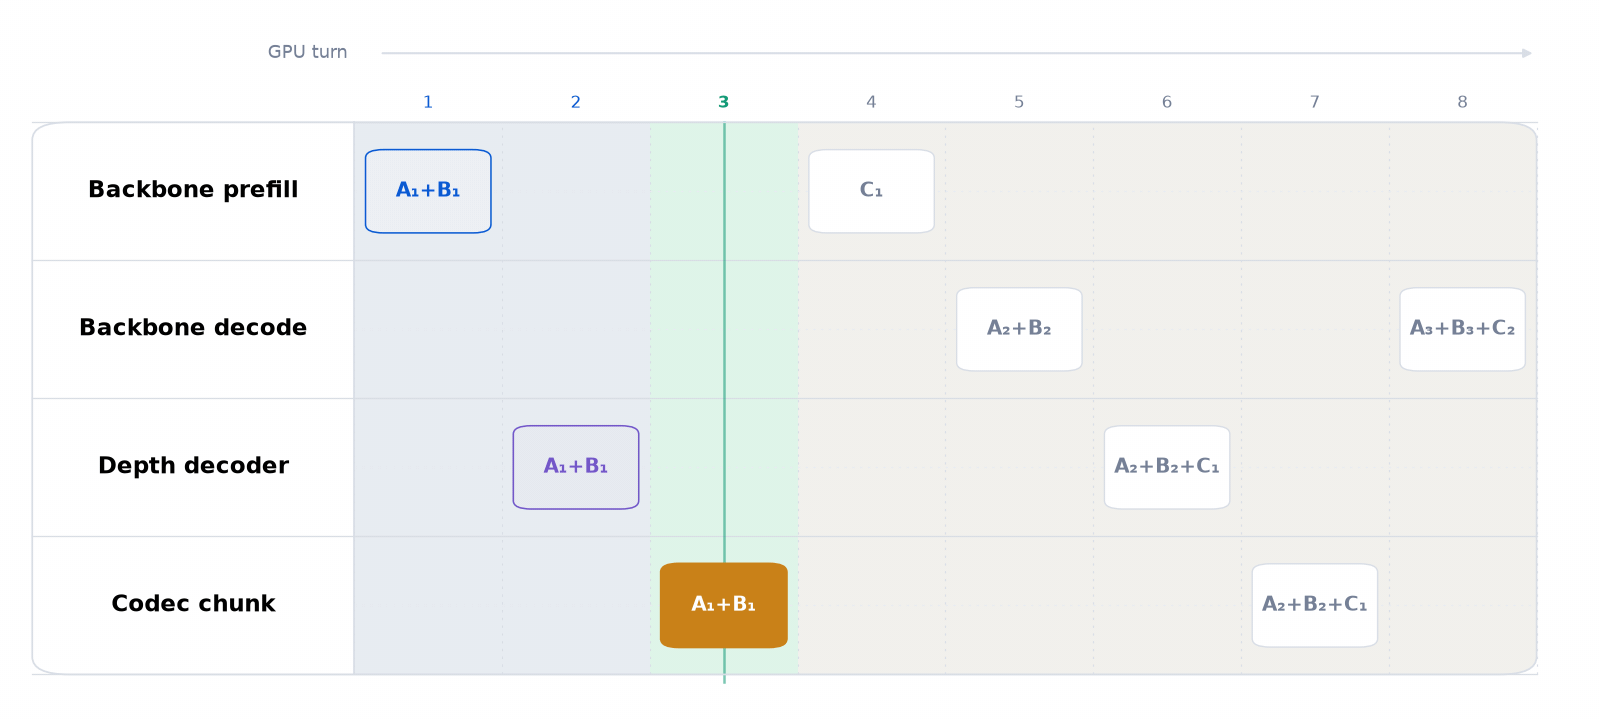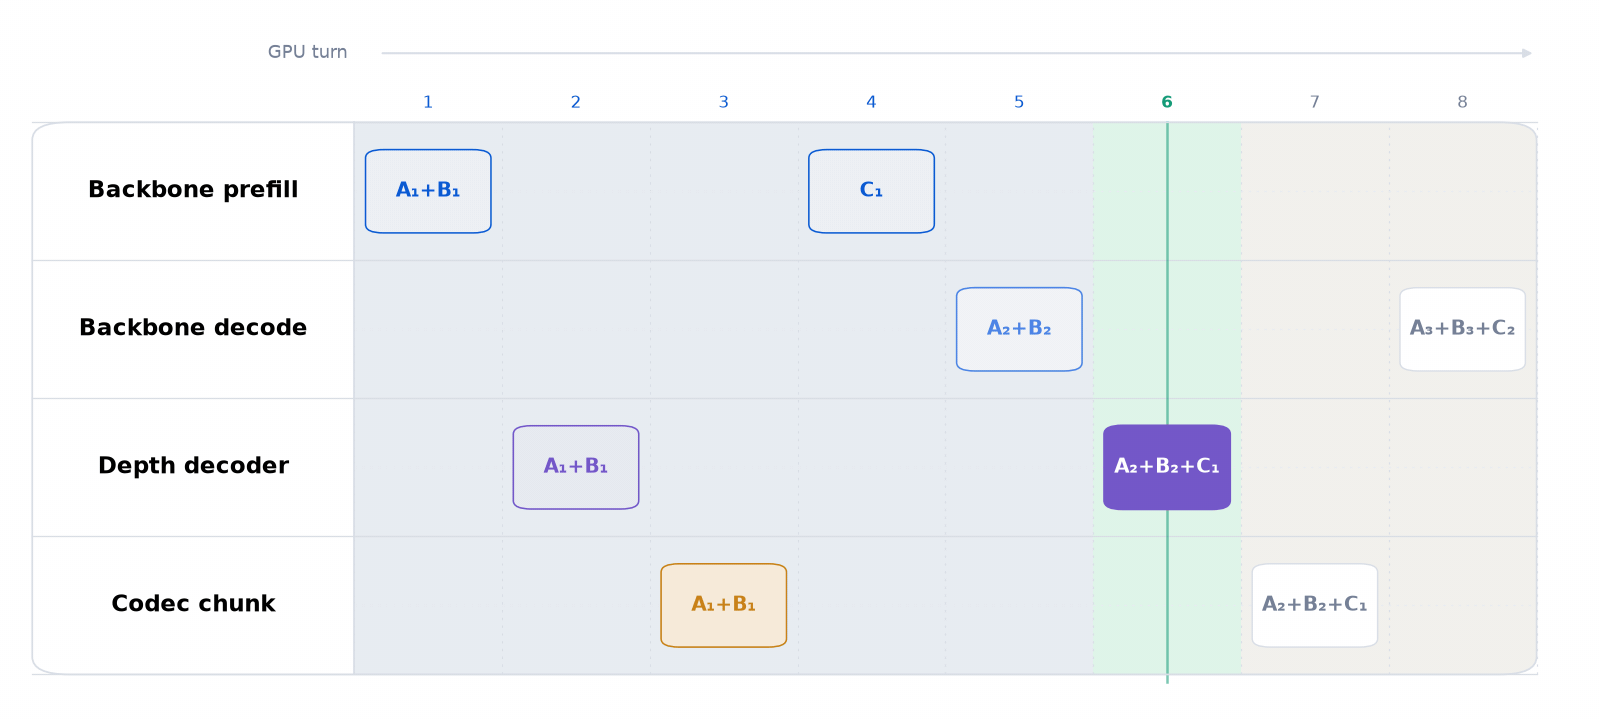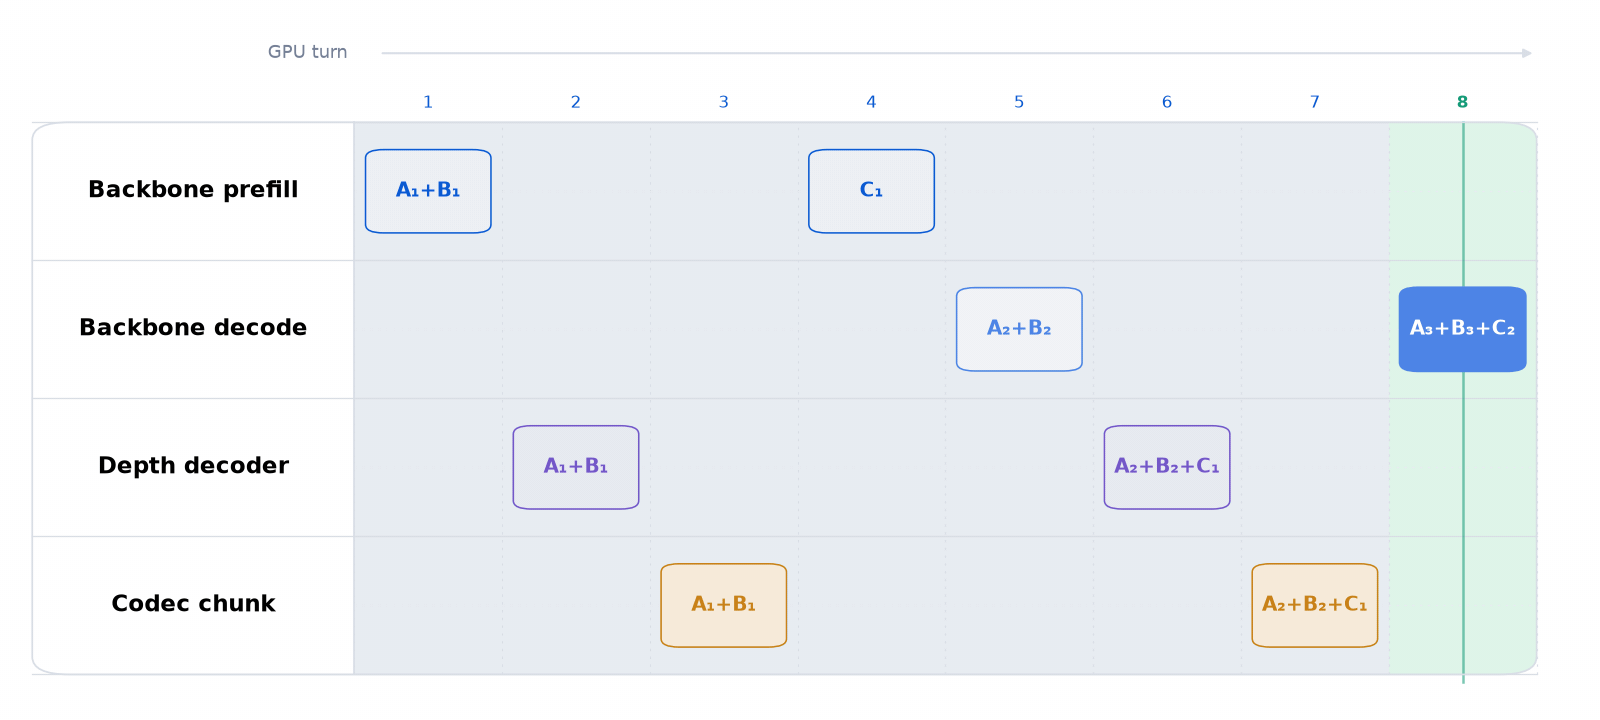
스케줄러는 우선순위에 따라 요청을 선택한 다음, 선택한 단계 안에서 작업을 배치로 묶습니다. 단계마다 배치 한도가 있어 Codec과 Backbone이 서로 다른 배치 크기를 사용할 수 있습니다. 새 요청은 단계 사이에 들어올 수 있고, 활성 스트림에도 디코딩할 시간을 확보합니다. 같은 런타임이 청킹, 그래프 재실행, 기한 기반 스케줄링을 처리합니다.
2. 점진적 청킹과 증분 디코딩
첫 청크가 크면 사용자는 더 많은 프레임이 쌓일 때까지 오디오를 기다려야 합니다. 하지만 한 번에 한 프레임씩 보내면 Codec과 스케줄러를 더 자주 실행해야 합니다. 요청이 늘어날수록 이 오버헤드가 누적됩니다.
BreezeRT는 예를 들어 1, 2, 4, 8, 16프레임처럼 청크 크기를 점진적으로 늘립니다. 작은 청크로 빠르게 재생을 시작하고, 오디오가 어느 정도 버퍼에 쌓이면 큰 청크로 디코딩 호출 횟수를 줄입니다.
Codec도 동일한 오디오를 다시 디코딩하지 않도록 이전 작업을 기억해야 합니다. BreezeRT는 요청마다 슬라이딩 윈도 Transformer KV, 인과적 합성곱 이력, 전치 합성곱의 겹치는 꼬리 부분을 저장한 뒤 새 프레임만 처리합니다. 이 캐시들은 청크 크기가 바뀌어도 문맥을 유지하고 청크 경계를 매끄럽게 연결합니다.
이를 확인하기 위한 비교에서 첫 청크를 16프레임으로 고정했을 때 첫 요청은 약 2500 ms 후에 오디오를 받았고, 점진적 청크를 사용했을 때는 약 150 ms 후에 받았습니다.
3. Depth 컴파일과 CUDA Graphs
첫 청크가 작아지면 CPU의 실행 제출 오버헤드가 더 잘 드러납니다. 음성 프레임 하나를 생성하는 데는 많은 모델 연산이 필요합니다. 빠른 GPU도 연산 제출 사이에는 유휴 상태로 남을 수 있습니다. BreezeRT는 컴파일로 연산 오버헤드를 줄이고, CUDA Graphs를 사용해 캡처한 GPU 연산을 한 번의 재실행으로 제출합니다.
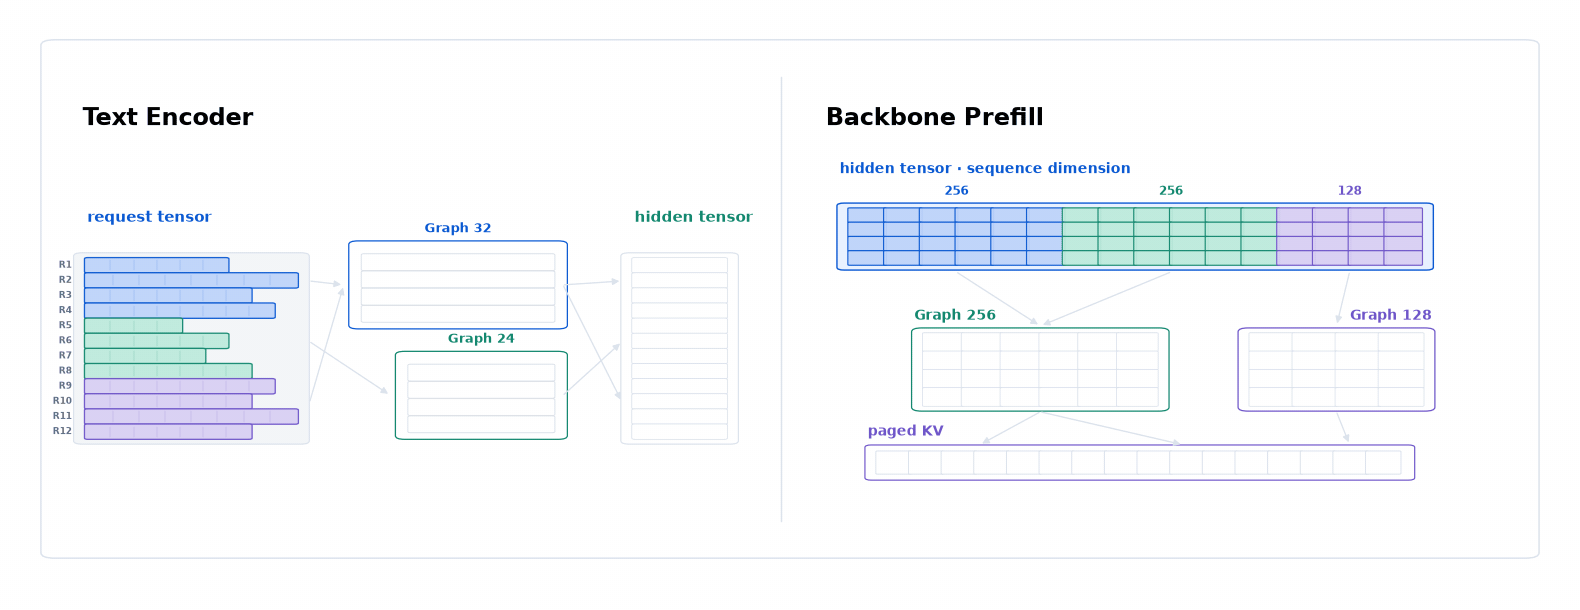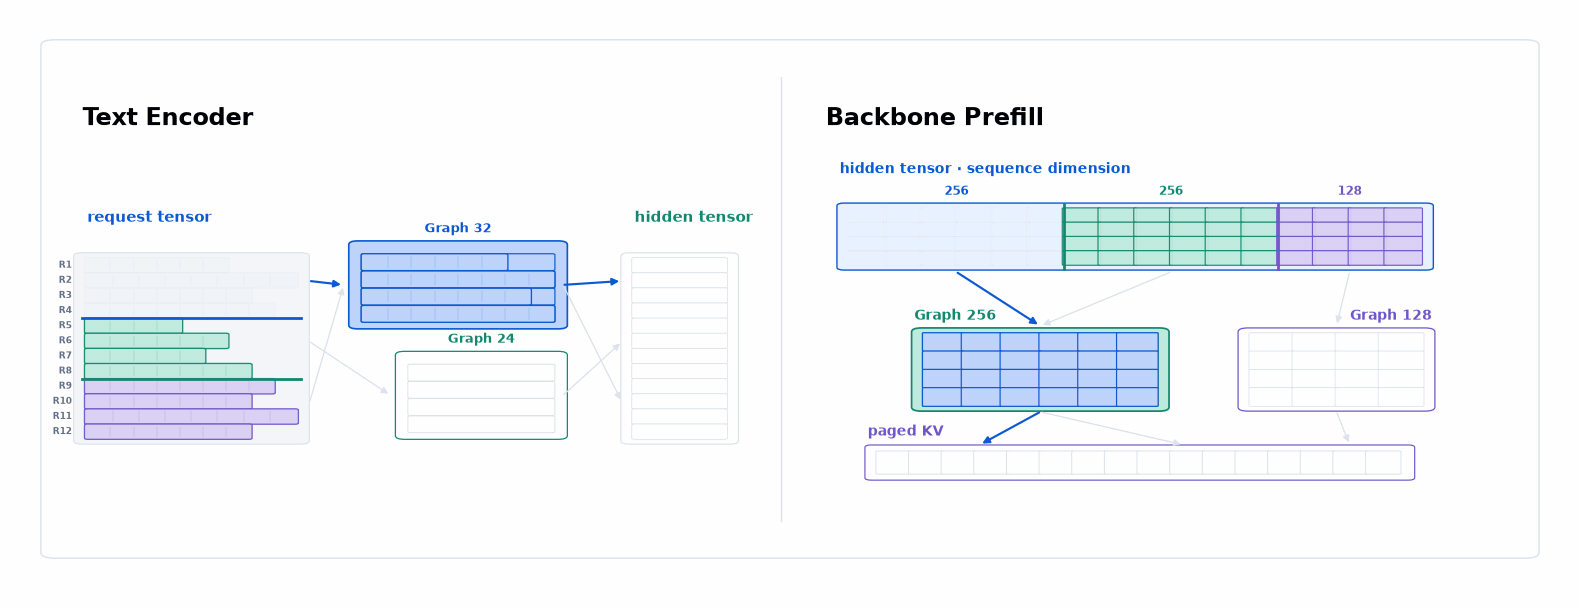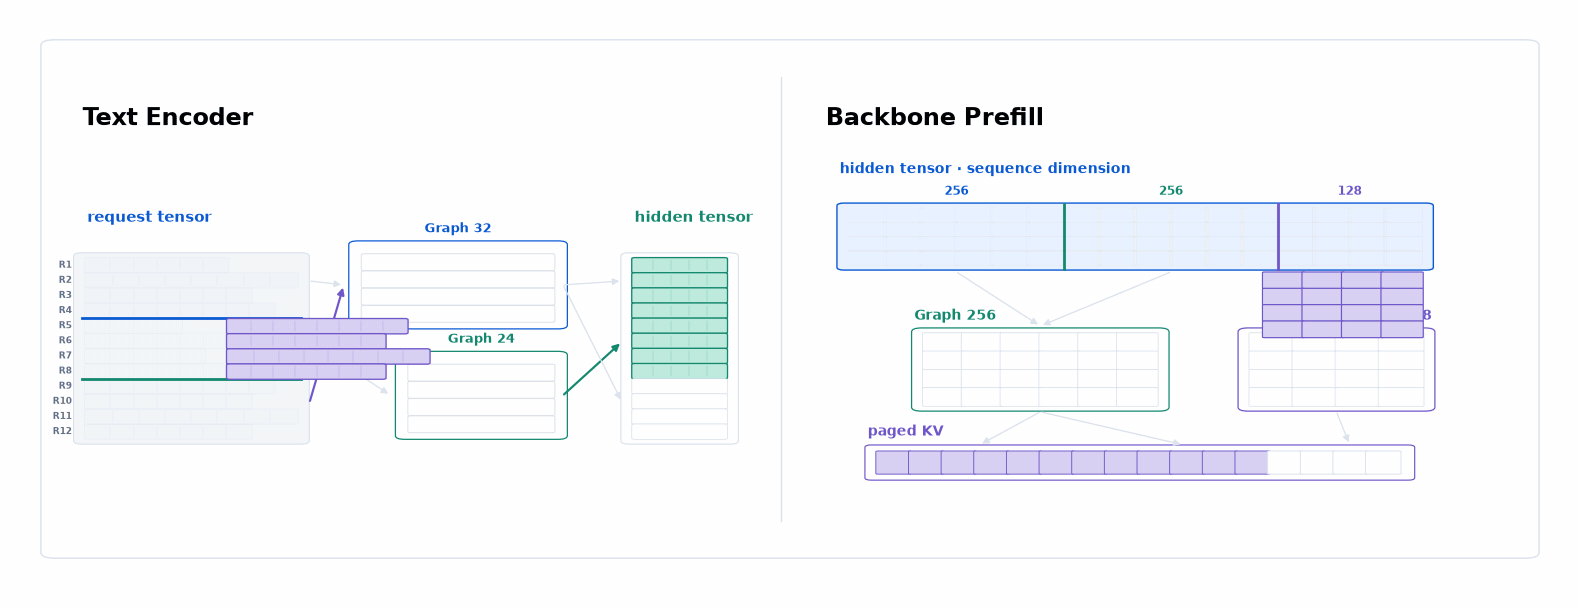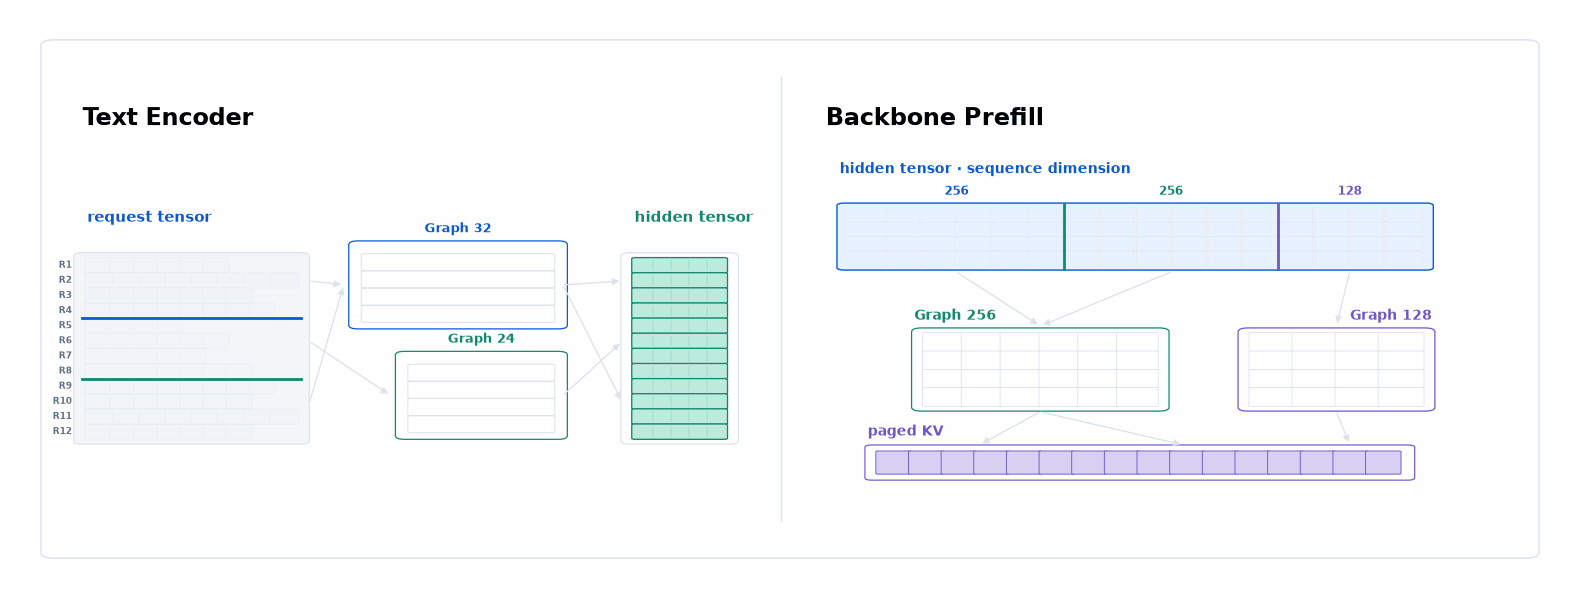
CUDA Graph 재실행에는 고정된 텐서 형태가 필요하지만, 텍스트 길이, 배치 크기, 오디오 청크 크기는 달라집니다. 모든 조합을 캡처하면 메모리를 너무 많이 사용하게 됩니다. BreezeRT는 자주 사용하는 형태들을 유지하고, 입력을 분할하거나 패딩해 해당 형태에 맞춥니다.
Text Encoder는 토큰을 묶고 요청 수와 토큰 용량에 따라 작업을 나눠 패딩을 줄입니다. Attention은 요청별로 독립적으로 유지됩니다. Backbone Prefill은 토큰 청크 단위로 동작하며, 페이지 기반 KV가 각 요청의 생성 이력을 저장하므로 기존 그래프와 버퍼를 재사용할 수 있습니다.
Depth Decoder는 프레임마다 오디오 코드 15개를 추가로 생성합니다. BreezeRT는 디코더 스택과 출력 헤드를 각각 전체 단위로 컴파일하고, 결합 가능한 원소별 연산을 융합해 커널 수를 줄입니다. 이를 통해 중간 텐서의 읽기·쓰기와 커널 실행 횟수를 줄입니다. 이러한 반복 작업은 동시 요청이 많아질수록 누적됩니다. KV, 위치, 입출력 버퍼는 미리 할당합니다. 전체 자기회귀 루프를 하나의 그래프로 캡처하므로 한 번의 재실행으로 15단계를 모두 의존 순서에 따라 실행합니다.
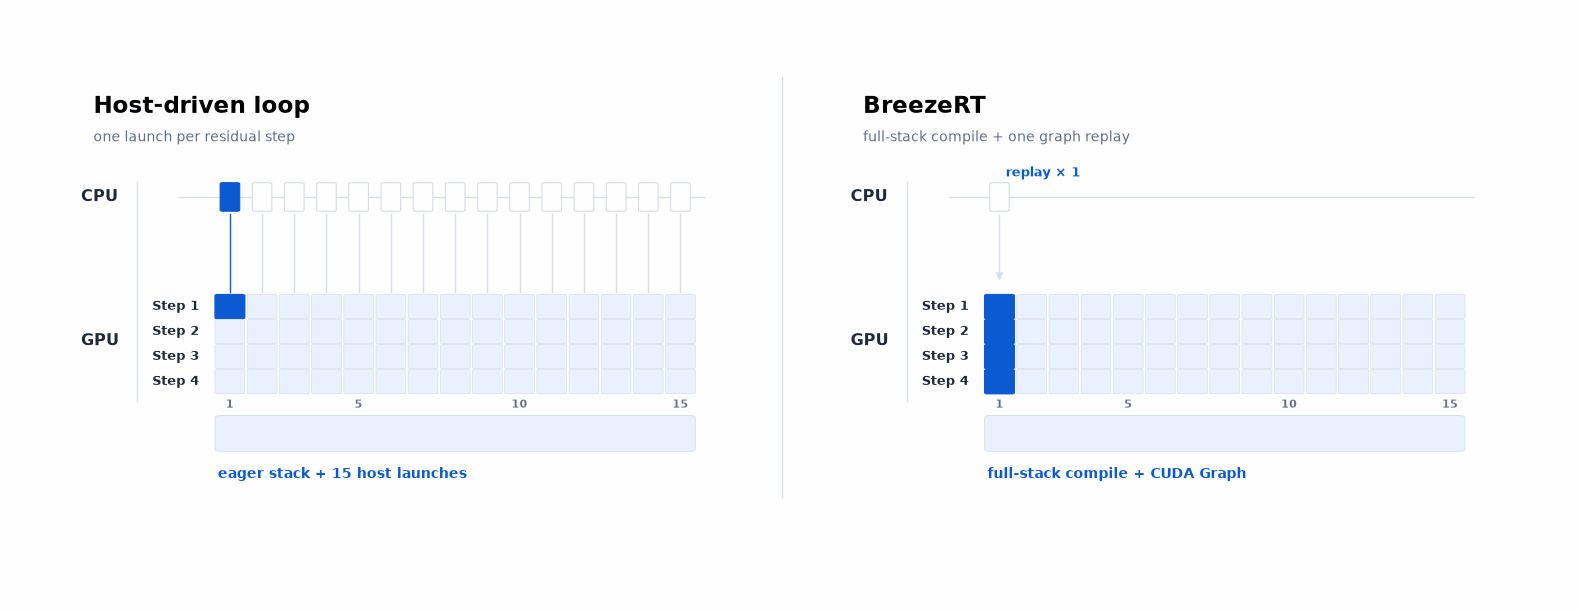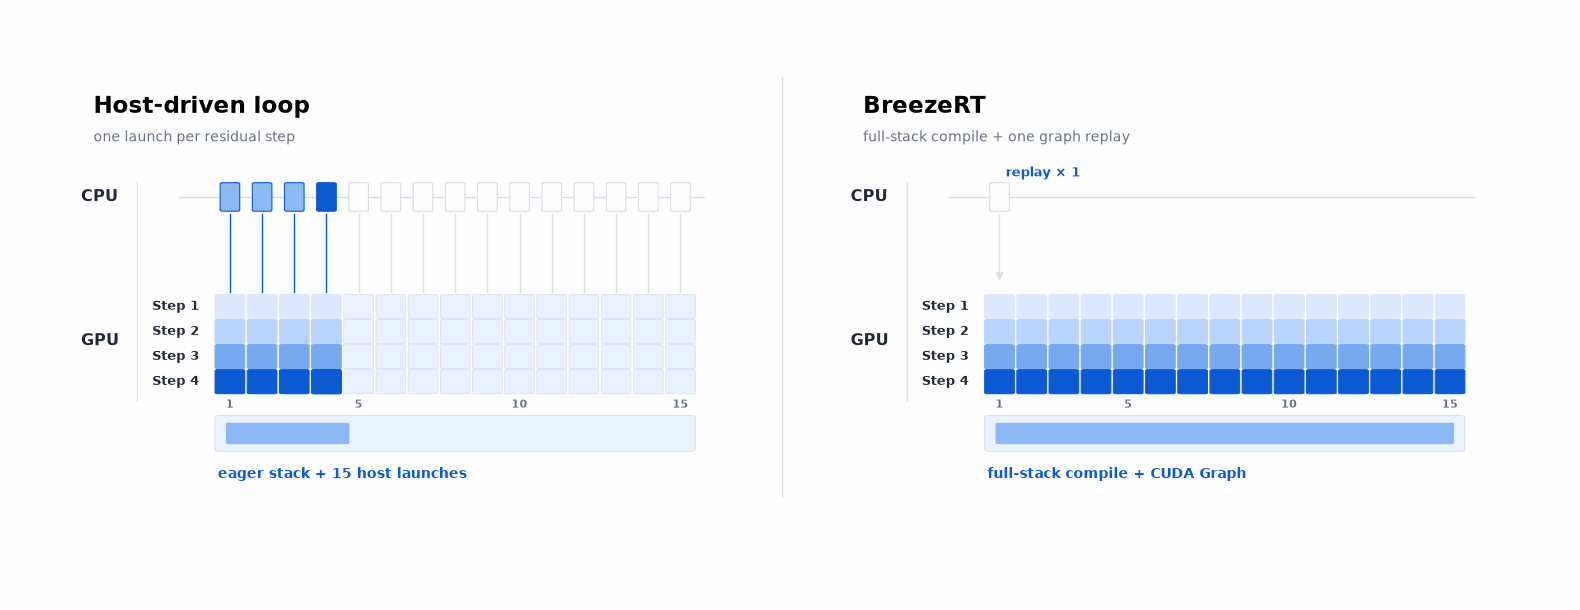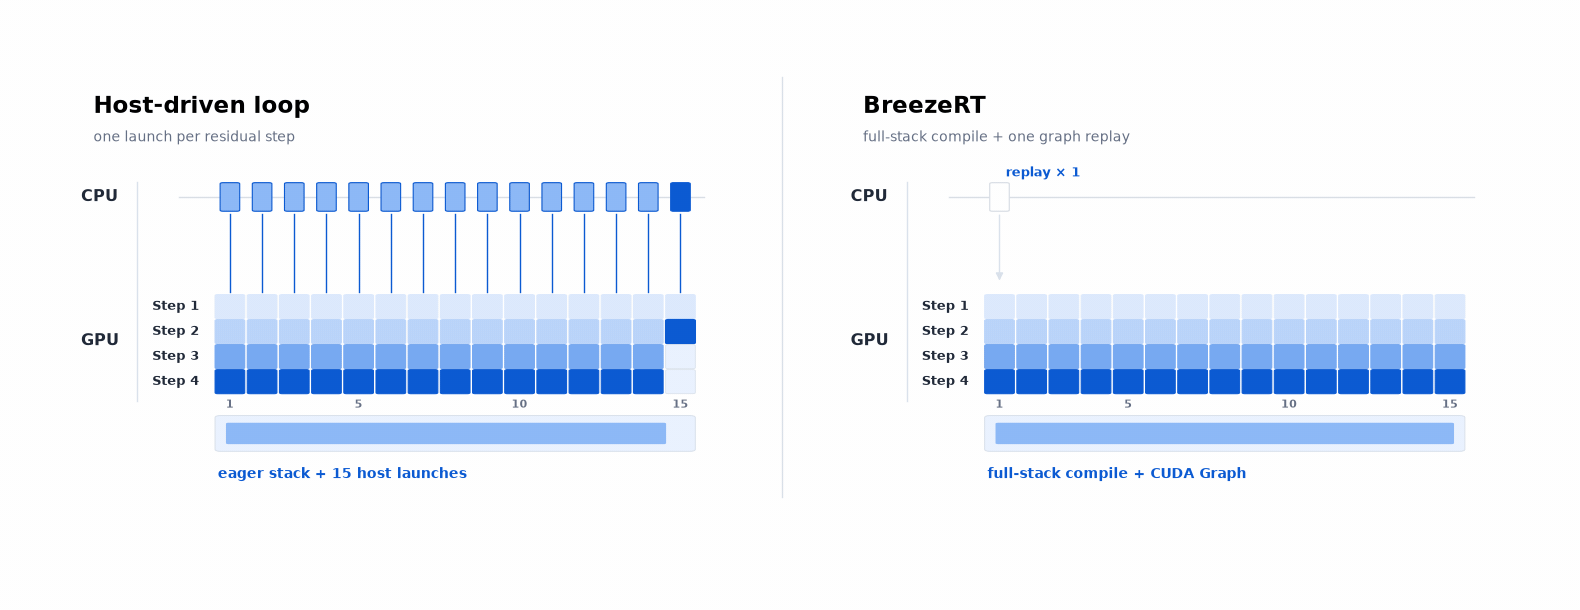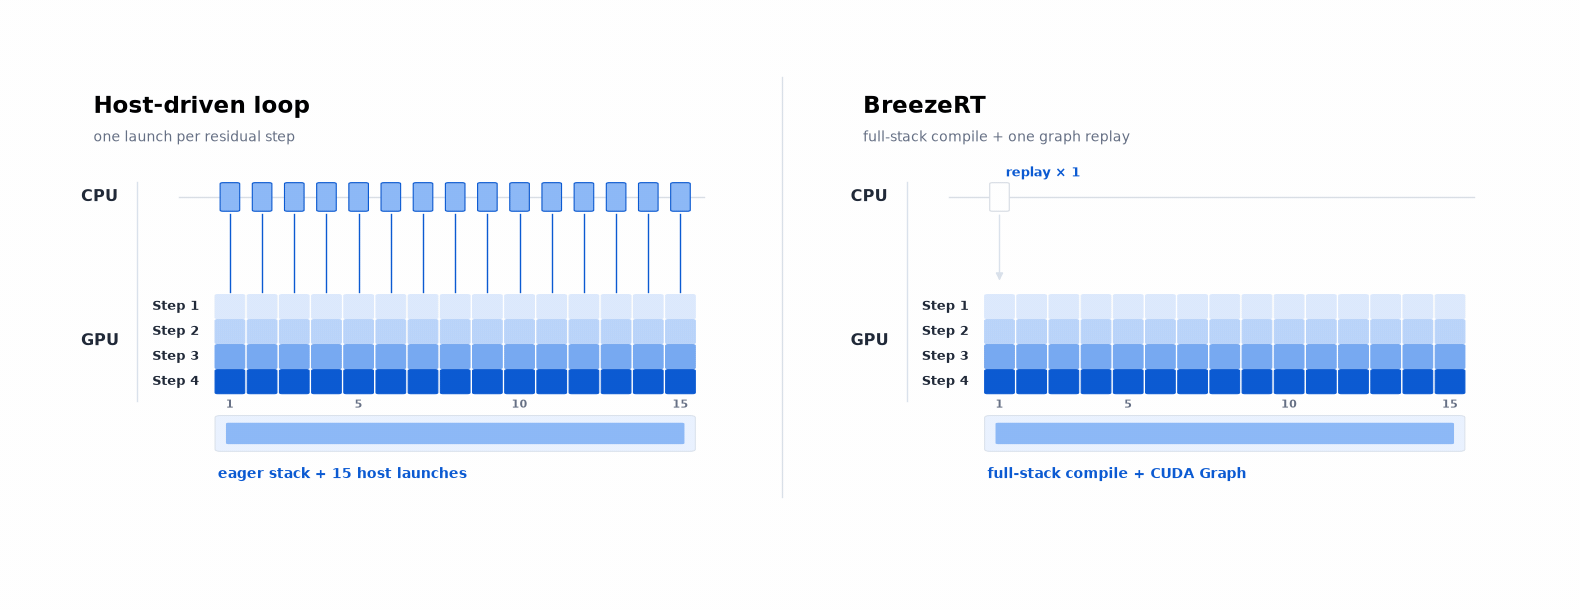
텍스트 인코딩, Backbone, Depth, 오디오 디코딩 모두 그래프를 사용하며, 시작 시 자주 사용하는 형태를 워밍업합니다. 각 요청은 고유한 샘플링 설정과 난수 상태를 유지합니다. 청킹 조건을 동일하게 유지한 비교에서 첫 요청 지연은 약 150 ms였으며, Depth 컴파일을 적용하면 100 ms, 모든 단계에 그래프를 적용하면 35 ms로 줄었습니다.
4. Predictor: 첫 오디오와 재생 기한
새 요청은 발화 시작을 기다리고, 활성 스트림은 다음 청크를 기다립니다. 항상 새 요청부터 처리하면 재생이 끊길 수 있습니다. 활성 스트림의 오디오를 너무 앞서 생성하면 새 요청이 기다려야 합니다. Predictor는 재생 기한을 기준으로 먼저 처리할 작업을 결정합니다.
새 요청에는 시작 우선순위를 부여합니다. 활성 스트림은 첫 출력 시각과 전체 오디오 길이로 재생 기한을 추정합니다. Predictor는 배치 크기별로 최근 단계 실행 시간을 기록하고, 남은 Backbone, Depth, Codec 작업이 제시간에 끝날지 추정할 때 여유 시간을 반영합니다.
예를 들어 A는 디코딩 준비가 끝났고, B는 같은 배치에 합류하려면 생성 단계가 한 번 더 필요하다고 가정합니다. 배치로 묶으면 시간을 절약하면서 A의 재생 기한도 지킬 수 있다면 스케줄러는 B를 기다립니다. 그렇지 않으면 A를 먼저 실행합니다. 목표 청크를 제시간에 완성할 수 없다면 런타임은 플레이어를 기다리게 하지 않고 이미 생성된 프레임을 보낼 수 있습니다.
Predictor는 가벼운 실행 시간 추정 방식을 사용합니다. 300개 요청 비교에서 재생 공백이 발생할 가능성이 있는 요청은 14개에서 0개로 줄었습니다. 공백을 방지하는 데 필요한 추가 버퍼의 최대치는 약 330 ms에서 0 ms로 줄었습니다.