O BreezeRT mantém baixa a latência do primeiro pacote do Breeze TTS 2 sob alta concorrência. Reduzimos a espera no escalonamento de solicitações, na divisão do áudio em blocos e na execução na GPU, e usamos o Predictor para escalonar o primeiro áudio e os blocos seguintes. Novas solicitações começam rapidamente, enquanto a fala em andamento continua sendo reproduzida.
Visão geral das otimizações do BreezeRT
| Otimização | Efeito |
|---|---|
| 1. Escalonamento unificado de múltiplas etapas | Menos espera |
| 2. Blocos progressivos e decodificação incremental | C16 TTFB p50: 1626 → 136 ms |
| 3. Compilação do Depth e CUDA Graphs | C16 TTFB p50: 136 → 85 → 38 ms |
| 4. Predictor: prazos do primeiro áudio e da reprodução | Solicitações com possíveis pausas em um total de 300: 14 → 0 |
Comparação de frameworks de inferência
Todos os testes deste artigo foram realizados em uma única GPU H100. Testamos novamente PyTorch, vLLM-Omni e SGLang-Omni usando os textos originais test-en do Seed-TTS, sem áudio de referência. O gráfico compara essas implementações com o BreezeRT, usando o mesmo modelo Breeze TTS 2 com 1–16 solicitações simultâneas. Com 16 solicitações simultâneas, o BreezeRT atinge uma latência do primeiro pacote de 38 / 52 ms em p50 / p95.
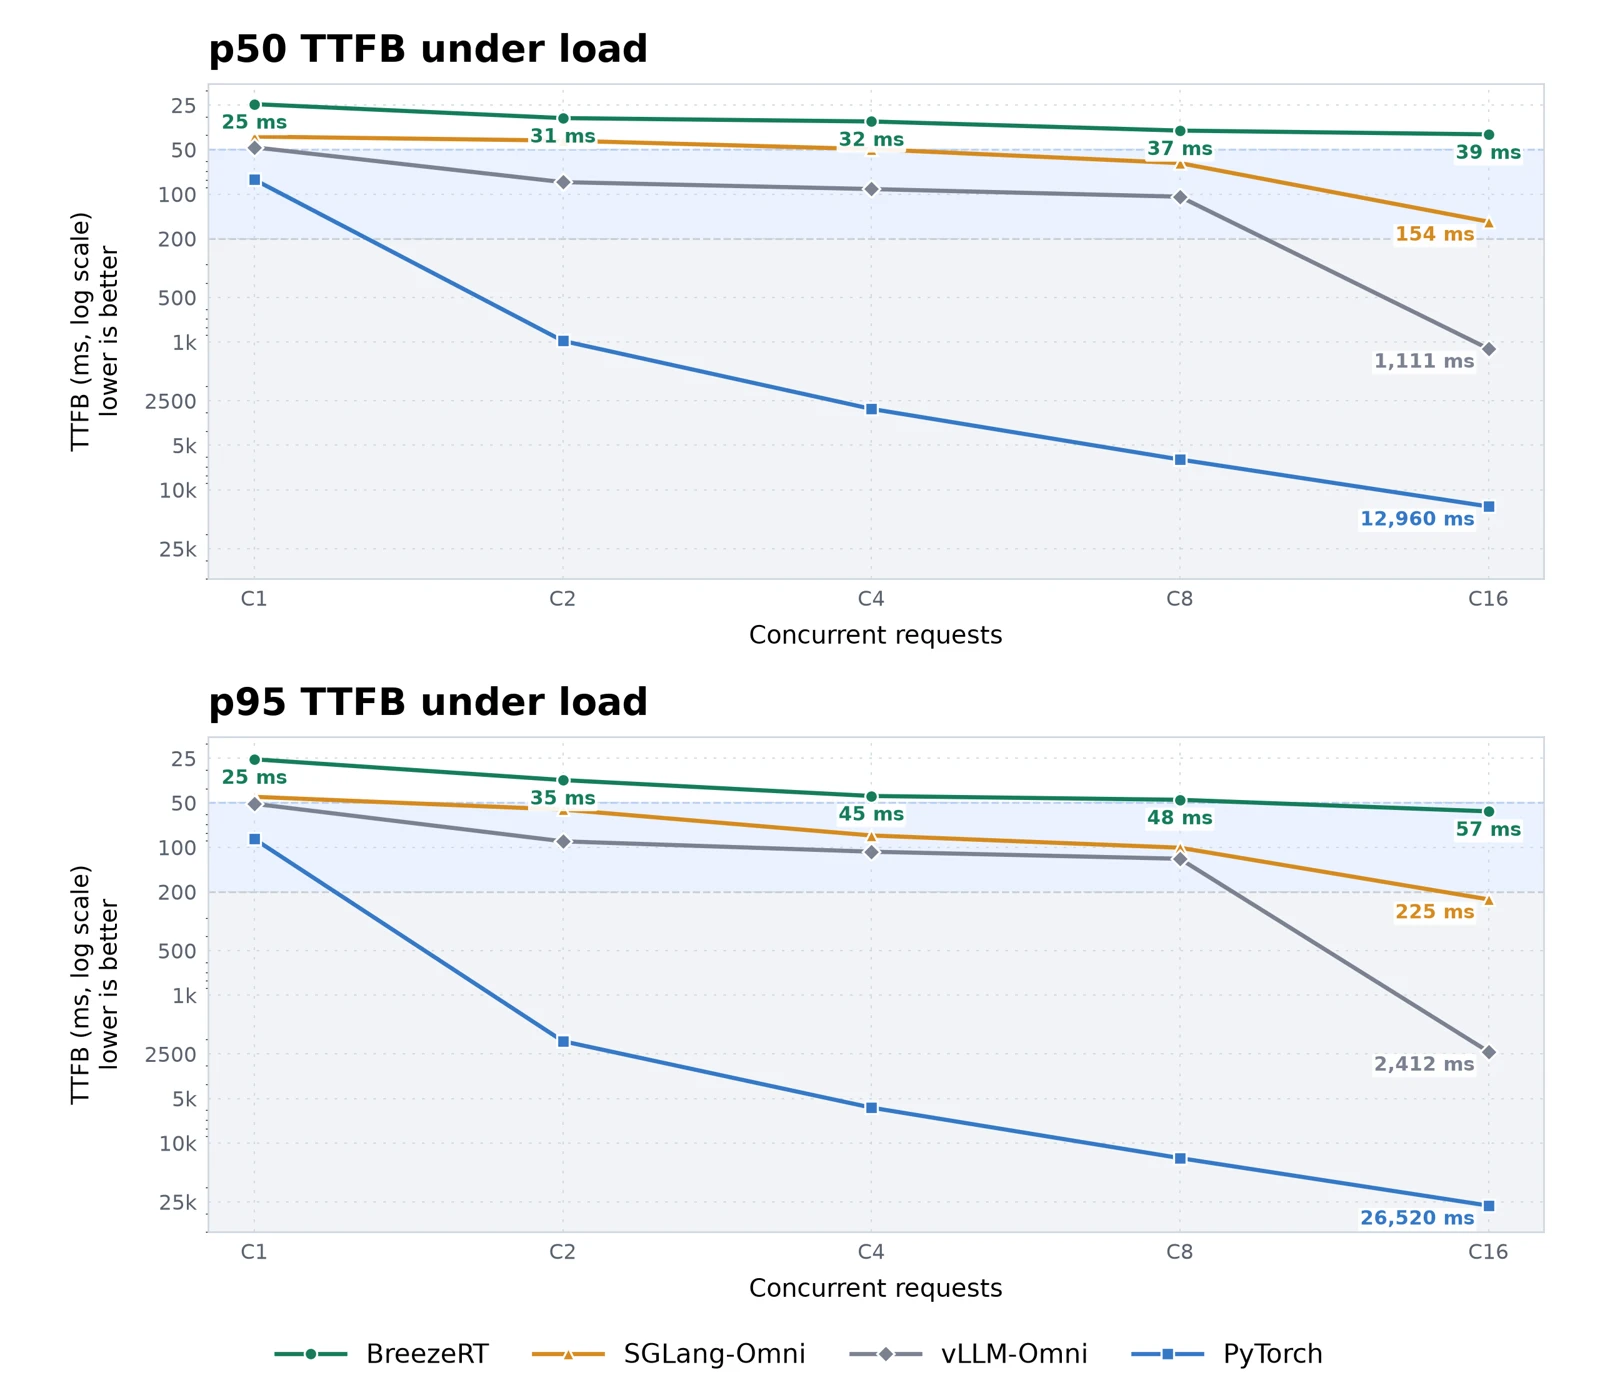
Adaptamos e ajustamos PyTorch, vLLM-Omni e SGLang-Omni para o Breeze TTS 2. O gráfico mostra a latência do primeiro pacote dessas implementações. Nossas adaptações ainda não foram incorporadas aos respectivos repositórios de código aberto.
As quatro otimizações do BreezeRT
1. Escalonamento unificado de múltiplas etapas
O Breeze TTS 2 primeiro codifica o texto e executa o Backbone Prefill. Para cada quadro de fala, o Backbone prevê o primeiro código de áudio, o Depth Decoder gera os 15 códigos restantes e o Codec produz as amostras da forma de onda. Cada etapa tem diferentes requisitos de processamento, frequências de execução e tamanhos de lote adequados.
Solicitações simultâneas costumam estar em etapas diferentes: A tem códigos de áudio prontos para decodificar, B está gerando seu próximo quadro e C acabou de chegar e espera pelo primeiro áudio. Continuar com A deixaria B e C esperando. O escalonador precisa alternar entre solicitações antes que uma frase inteira seja concluída.
O BreezeRT escalona separadamente o processamento de texto, Backbone Prefill, Backbone Decode, Depth e a decodificação de áudio. Um único ambiente de execução gerencia o progresso das solicitações, os caches e o áudio pendente. Após cada etapa, escolhe qual etapa e quais solicitações executar em seguida.
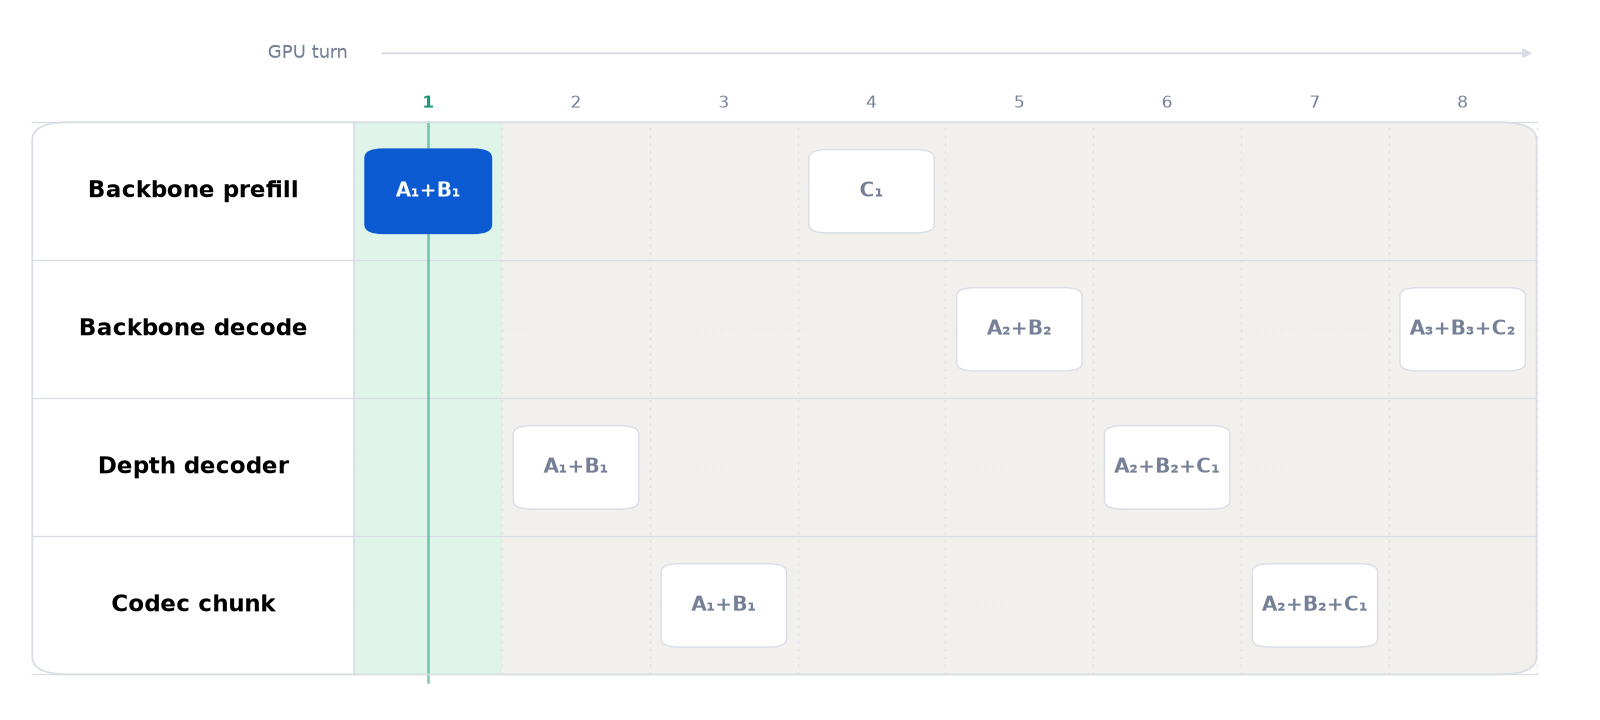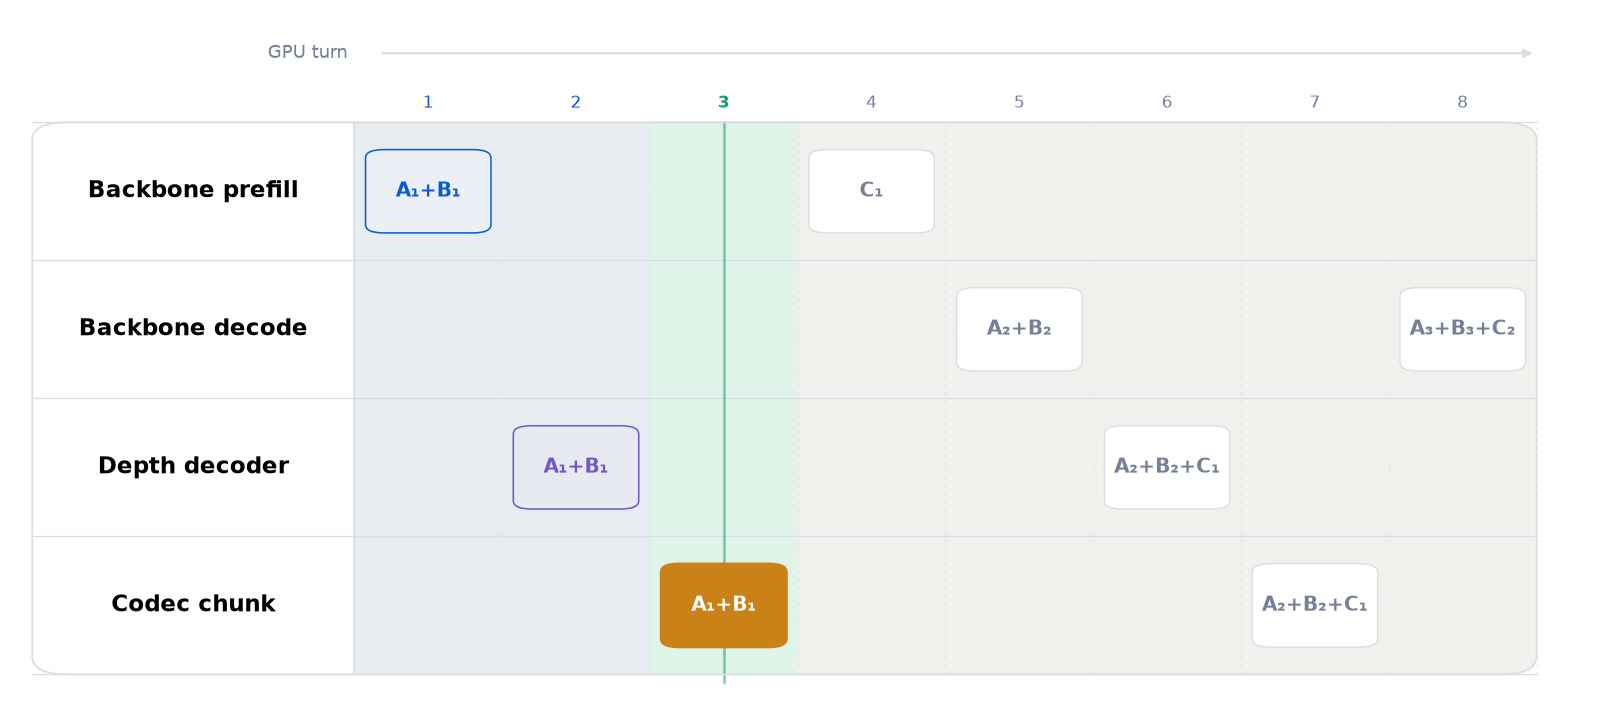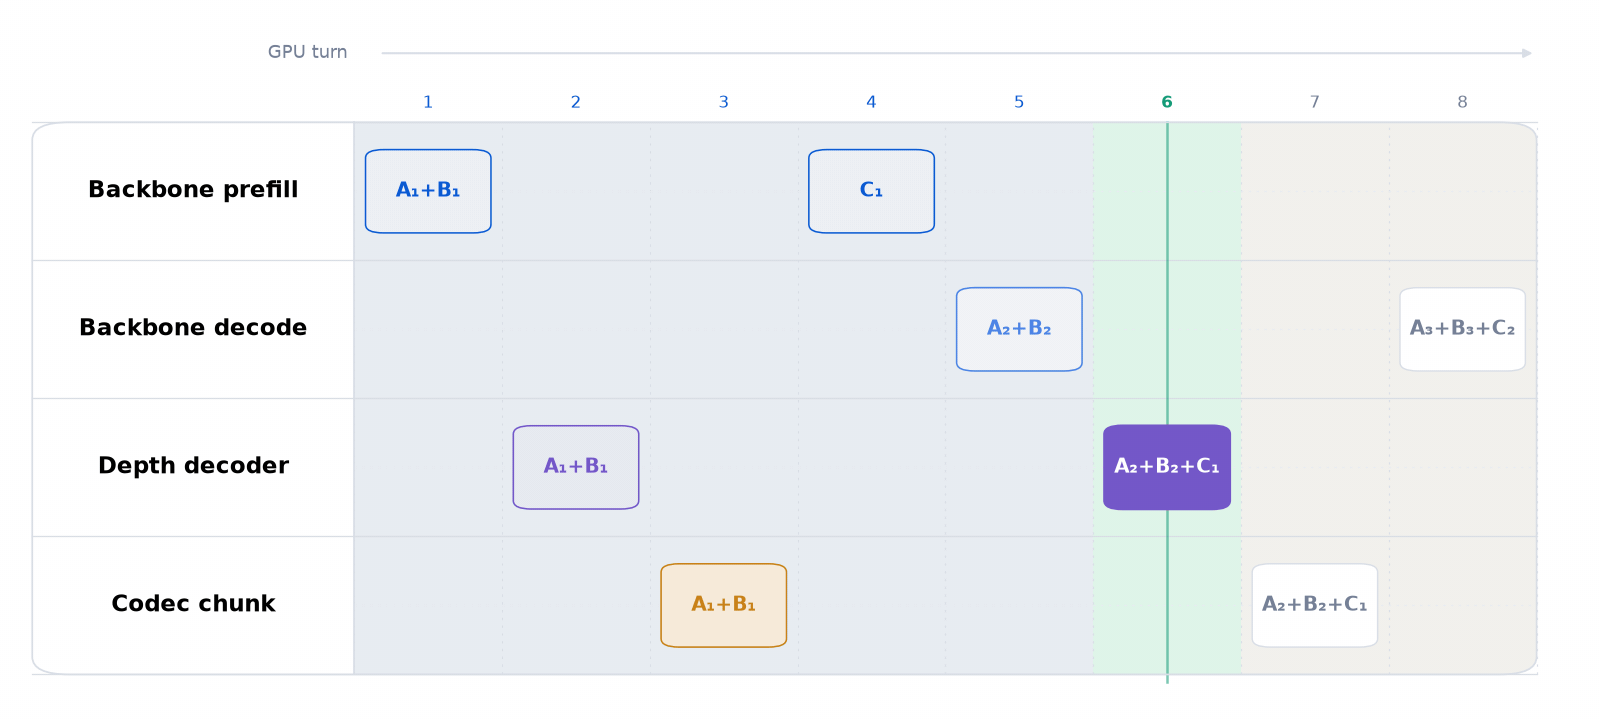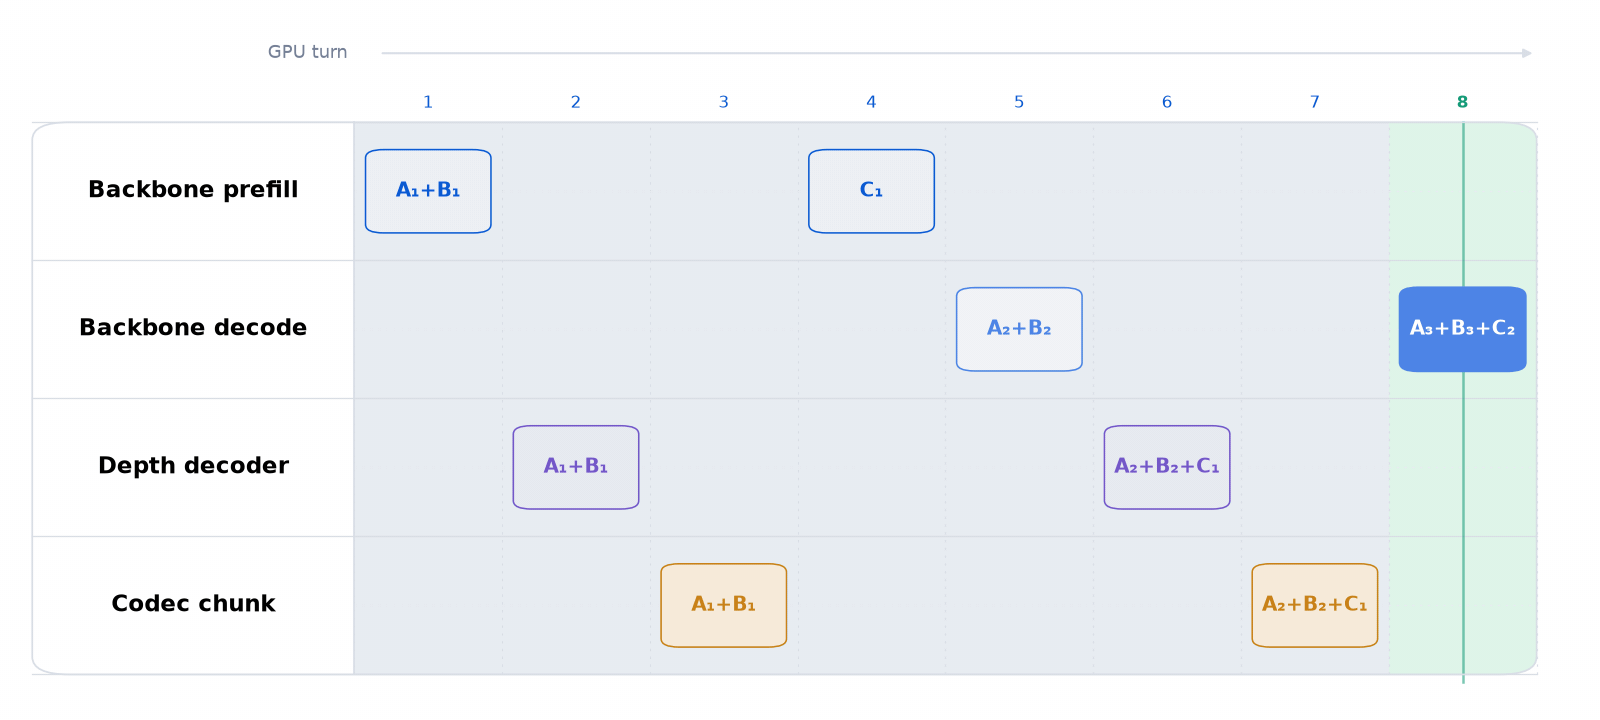
O escalonador seleciona solicitações por prioridade e depois agrupa o trabalho em lotes dentro da etapa escolhida. Cada etapa tem seu próprio limite de lote, permitindo que Codec e Backbone usem tamanhos de lote diferentes. Novas solicitações podem entrar entre etapas, e fluxos ativos recebem tempo para decodificar. O mesmo ambiente de execução cuida da divisão em blocos, da execução de grafos capturados e do escalonamento por prazos.
2. Blocos progressivos e decodificação incremental
Um primeiro bloco maior faz o usuário esperar por mais quadros antes de ouvir áudio. Porém, enviar um quadro por vez exige executar o Codec e o escalonador com mais frequência. Esse custo se acumula à medida que as solicitações aumentam.
O BreezeRT aumenta gradualmente o tamanho dos blocos, usando, por exemplo, 1, 2, 4, 8 e 16 quadros. Blocos pequenos iniciam a reprodução rapidamente. Quando já há algum áudio no buffer, blocos maiores reduzem o número de chamadas de decodificação.
O Codec também precisa lembrar o trabalho anterior para não decodificar o mesmo áudio novamente. O BreezeRT armazena, para cada solicitação, os KV do Transformer com janela deslizante, o histórico de convolução causal e a cauda de sobreposição da convolução transposta, e então processa apenas os novos quadros. Esses caches preservam o contexto e suavizam as transições entre blocos quando seus tamanhos mudam.
A ablação é executada em uma única GPU H100 com 16 solicitações simultâneas, medindo a latência do primeiro pacote p50 em 300 solicitações por configuração. Um primeiro bloco fixo de 16 quadros resulta em 1626 ms; os blocos progressivos reduzem esse valor para 136 ms.
3. Compilação do Depth e CUDA Graphs
Com um primeiro bloco menor, o custo de lançamento pela CPU fica mais evidente. Gerar um quadro de fala exige muitas operações do modelo. Mesmo uma GPU rápida pode ficar ociosa entre envios. O BreezeRT reduz o custo de processamento por meio de compilação e usa CUDA Graphs para enviar operações de GPU capturadas em uma única execução do grafo.
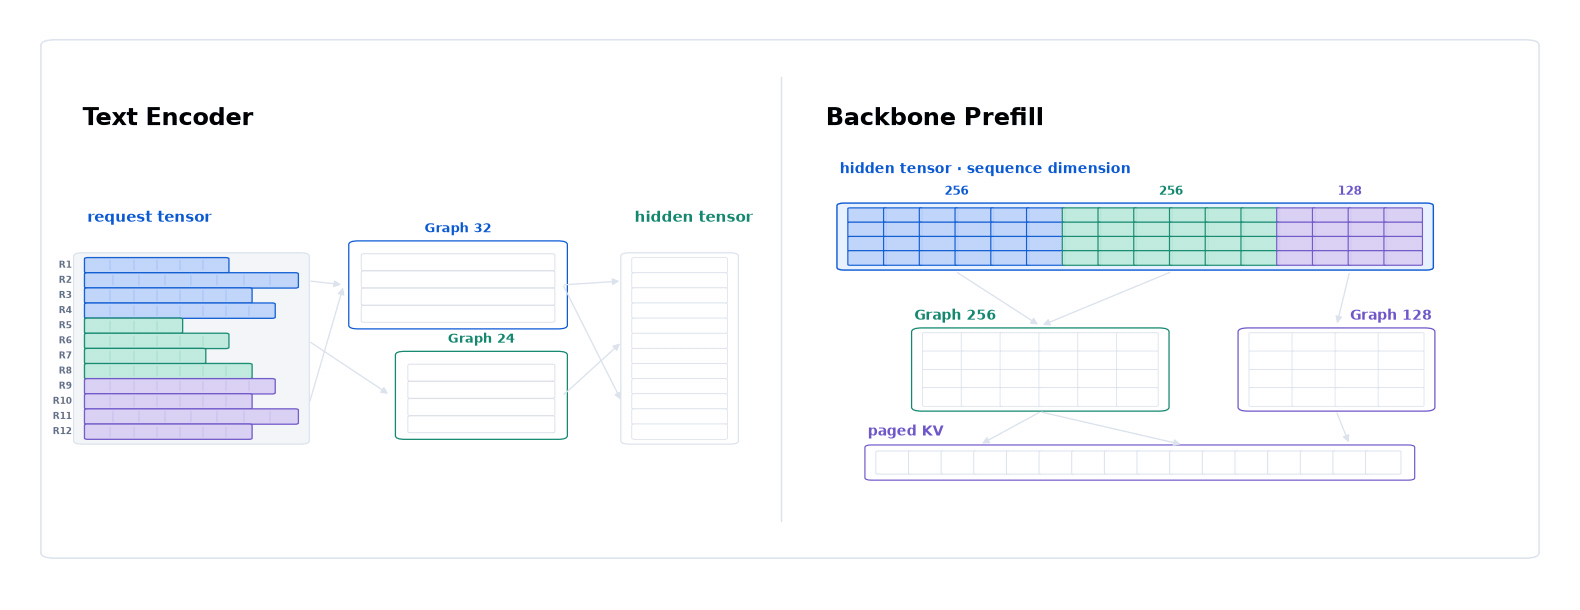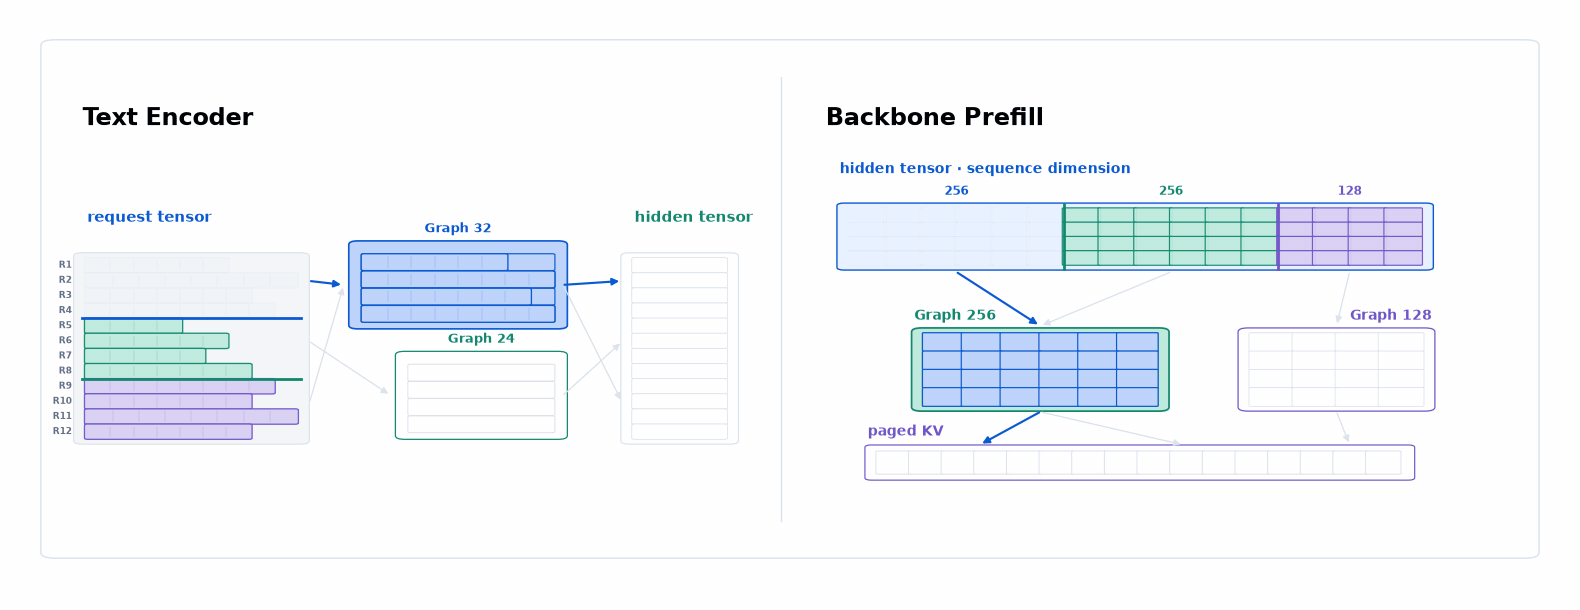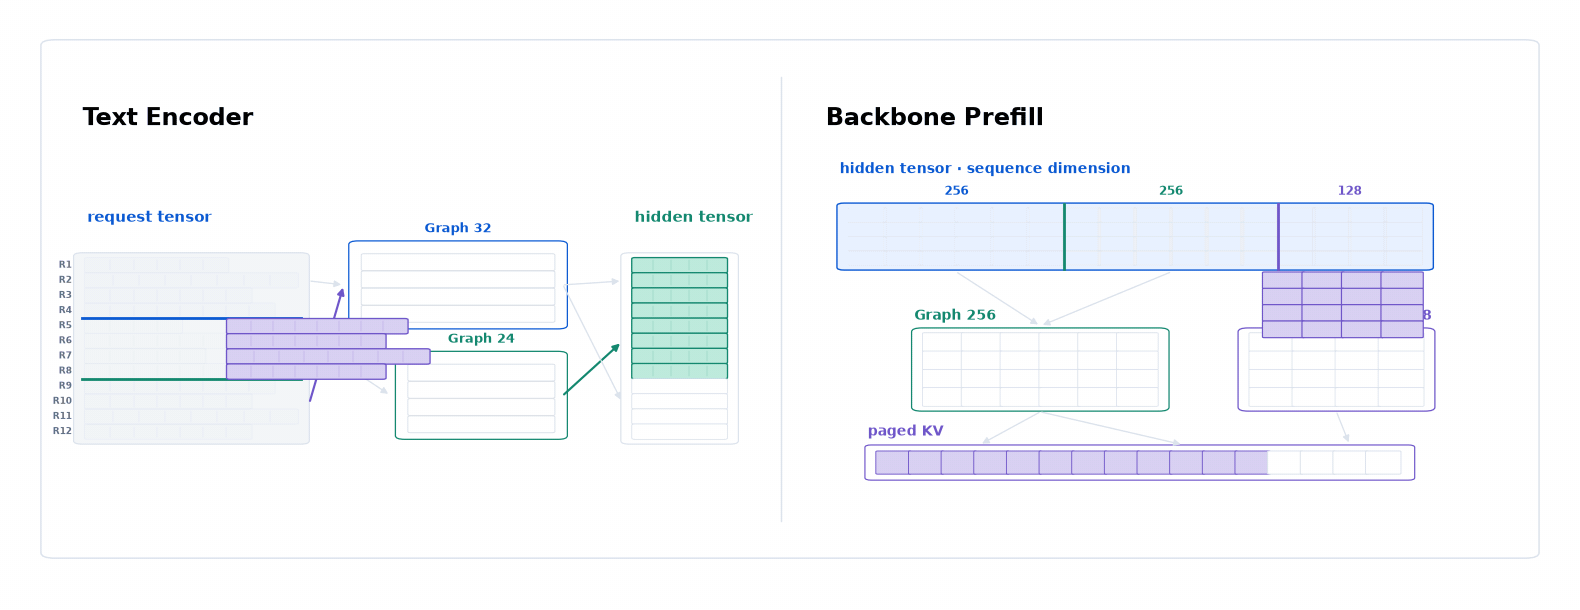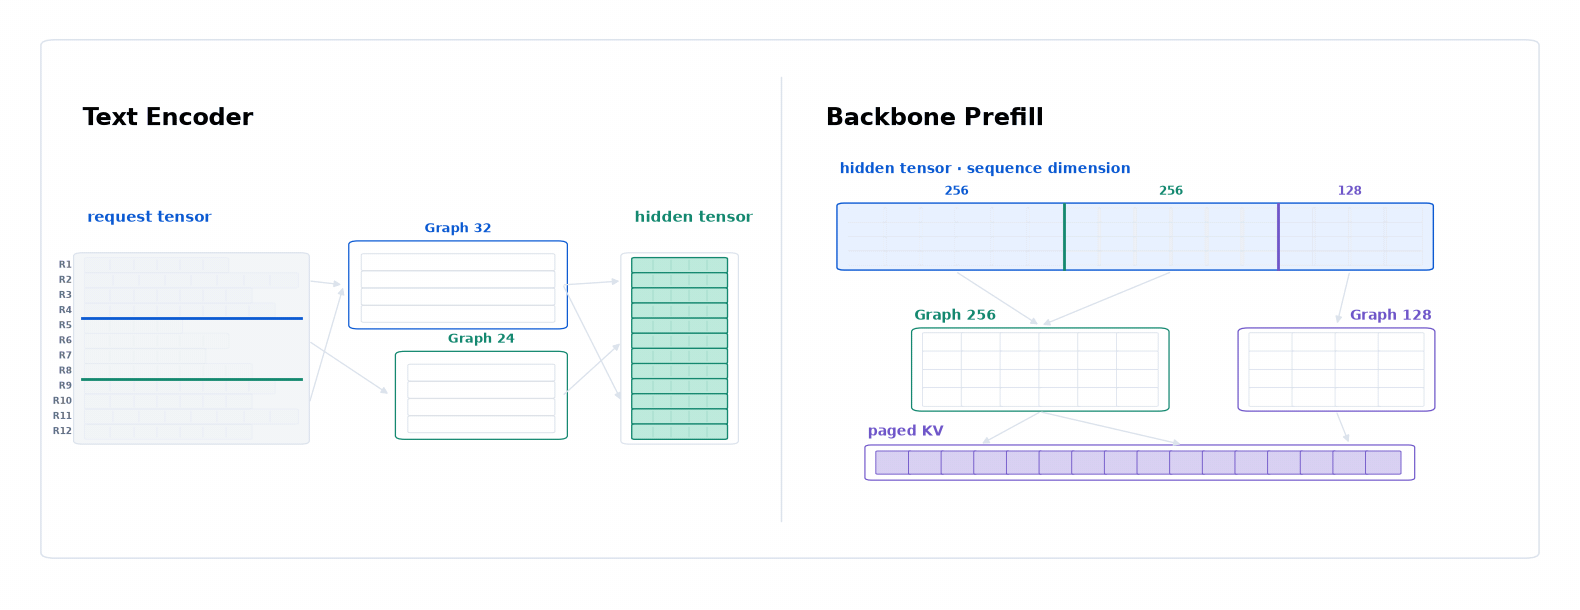
A execução de CUDA Graphs exige formatos fixos de tensores, mas os comprimentos de texto, os tamanhos de lote e os tamanhos dos blocos de áudio variam. Capturar todas as combinações consumiria memória demais. O BreezeRT mantém um conjunto de formatos comuns e divide ou preenche as entradas para ajustá-las a eles.
O Text Encoder compacta tokens e divide o trabalho por quantidade de solicitações e capacidade de tokens para reduzir o preenchimento. A atenção permanece separada para cada solicitação. O Backbone Prefill trabalha em blocos de tokens, com KV paginados armazenando o histórico de geração de cada solicitação para reutilizar grafos e buffers existentes.
O Depth Decoder gera mais 15 códigos de áudio por quadro. O BreezeRT compila a pilha do decodificador e as cabeças de saída como unidades completas, fundindo operações compatíveis elemento a elemento em menos kernels. Isso reduz leituras e gravações de tensores intermediários e lançamentos de kernels, um trabalho repetido que se acumula entre solicitações simultâneas. Os buffers de KV, posição e entrada/saída são alocados antecipadamente. O laço autorregressivo completo é capturado em um único grafo, de modo que uma execução realiza todos os 15 passos na ordem de dependência.
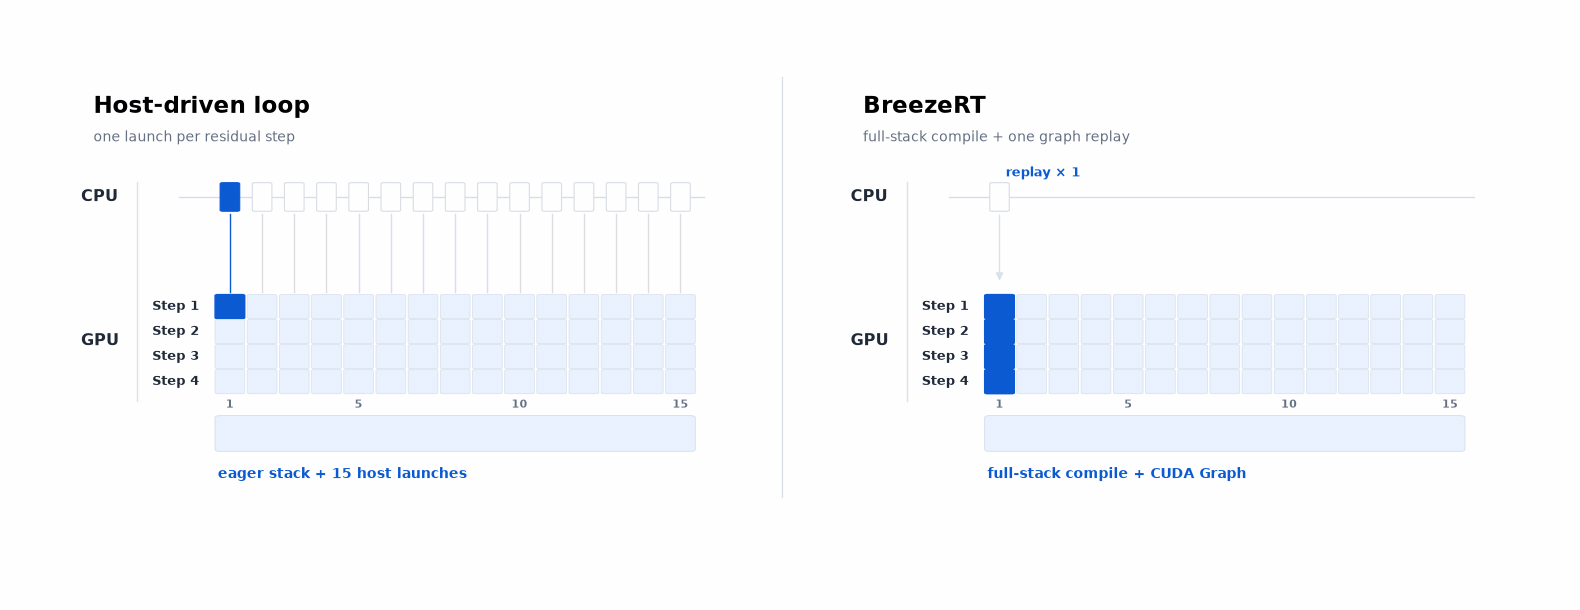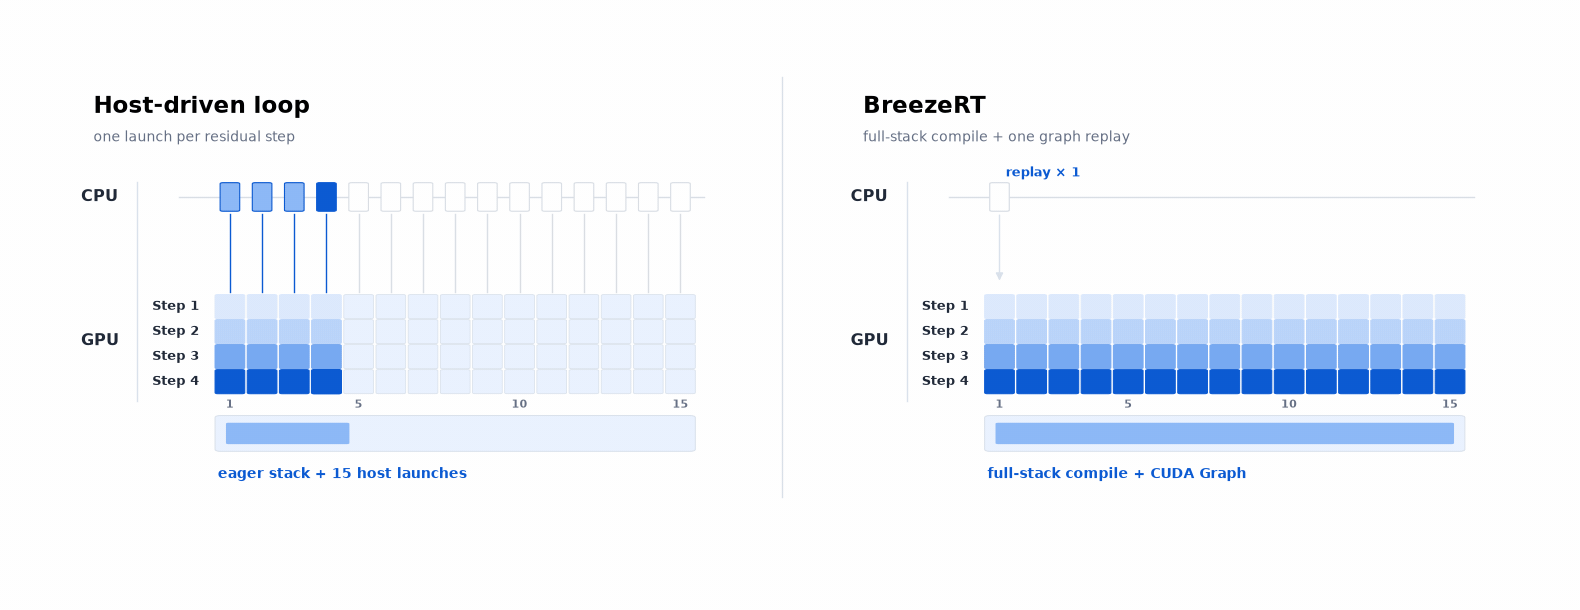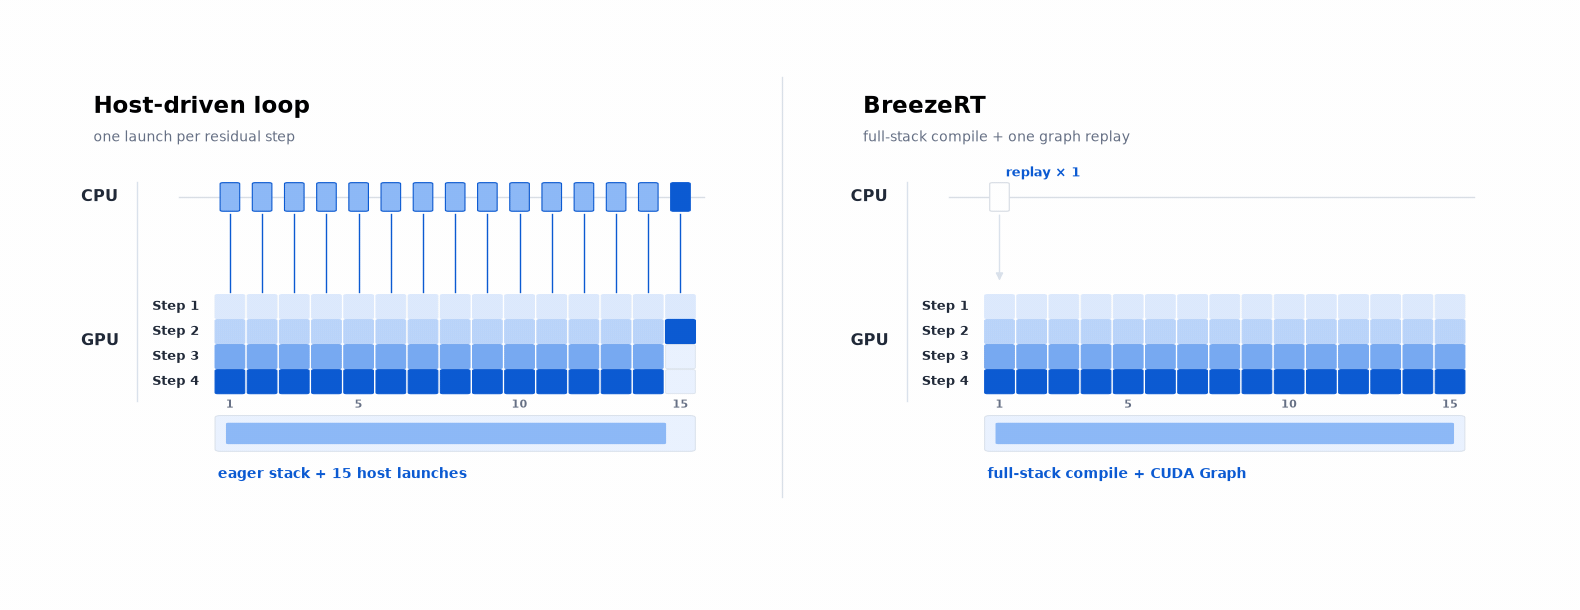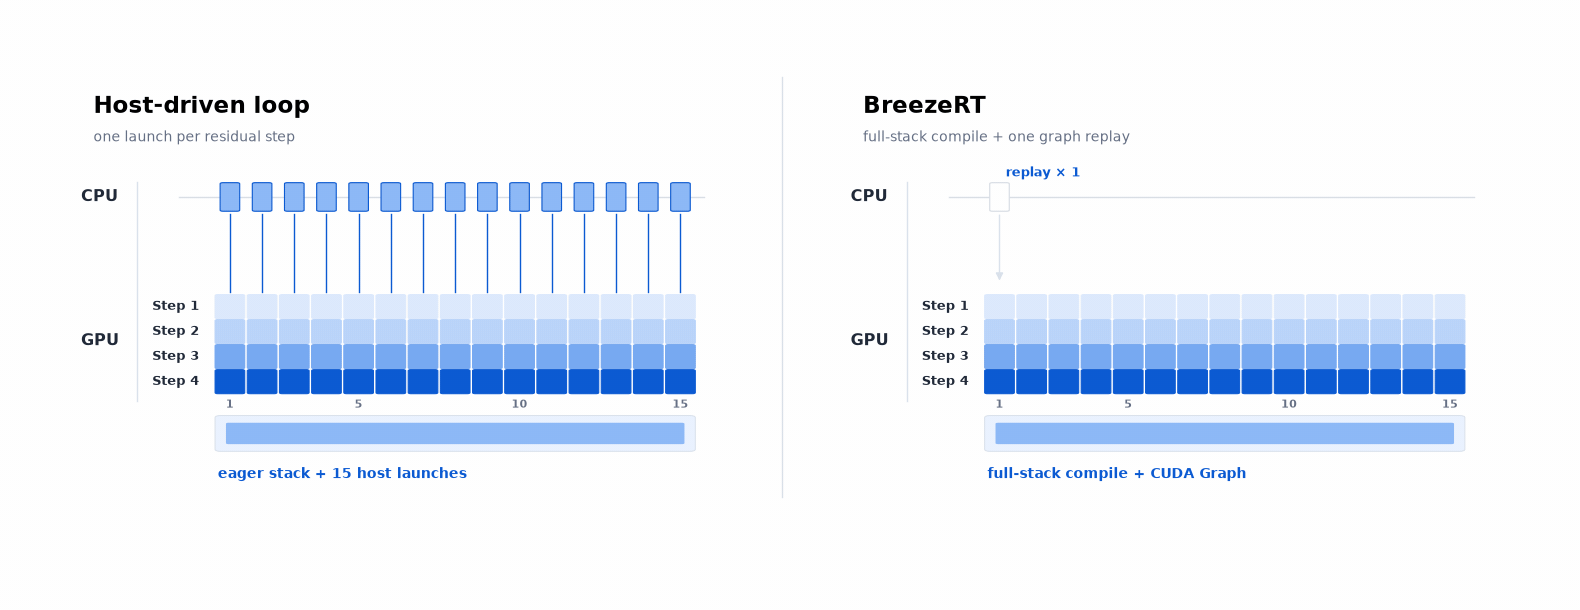
A codificação de texto, Backbone, Depth e a decodificação de áudio usam grafos, com os formatos comuns aquecidos na inicialização. Cada solicitação mantém suas próprias configurações de amostragem e estado aleatório. Na mesma ablação C16, sem alterar a divisão em blocos, a latência do primeiro pacote p50 cai de 136 ms para 85 ms com a compilação do Depth e para 38 ms com grafos em todas as etapas.
4. Predictor: prazos do primeiro áudio e da reprodução
Novas solicitações esperam para começar a falar; fluxos ativos esperam pelo próximo bloco. Atender sempre às novas solicitações primeiro pode interromper a reprodução. Gerar com antecedência excessiva para fluxos ativos faz as novas solicitações esperarem. O Predictor usa prazos de reprodução para decidir qual trabalho vem primeiro.
Novas solicitações recebem prioridade de início. Para fluxos ativos, o momento da primeira saída e a duração total do áudio fornecem uma estimativa do prazo de reprodução. O Predictor registra os tempos recentes das etapas por tamanho de lote e inclui uma margem ao estimar se o trabalho restante de Backbone, Depth e Codec pode terminar a tempo.
Por exemplo, A está pronta para decodificar, enquanto B precisa de mais um passo de geração para se juntar ao seu lote. O escalonador espera por B se o processamento em lote economizar tempo e ainda cumprir o prazo de reprodução de A. Caso contrário, A é executada primeiro. Se o bloco desejado não puder ser concluído a tempo, o ambiente de execução pode enviar os quadros já gerados para evitar que o player fique esperando.
O Predictor usa uma estimativa simples de tempo. Em uma comparação com 300 solicitações, as solicitações com possíveis pausas na reprodução caíram de 14 para 0. Com base nos tempos de chegada dos pacotes de áudio, sem o Predictor a reprodução precisaria, no pior caso, de cerca de 330 ms de áudio adicional armazenado antecipadamente para evitar interrupções. Na repetição com o Predictor ativado, a reprodução pôde começar assim que o primeiro pacote chegou e continuar sem nenhuma espera adicional.