BreezeRT は、高い同時実行数でも Breeze TTS 2 の初回パケット遅延を低く保ちます。リクエストのスケジューリング、音声のチャンク化、GPU 実行の待ち時間を減らし、Predictor で初回音声と後続チャンクをスケジュールします。新しいリクエストはすばやく発話を開始し、再生中の音声は途切れずに続きます。
BreezeRT の最適化の概要
| 最適化 | 効果 |
|---|---|
| 1. 複数段階の統合スケジューリング | 待ち時間を短縮 |
| 2. 段階的チャンク化と増分デコード | C16 TTFB p50: 1626 → 136 ms |
| 3. Depth のコンパイルと CUDA Graphs | C16 TTFB p50: 136 → 85 → 38 ms |
| 4. Predictor:初回音声と再生期限 | 300 件中、再生に途切れが生じる可能性のあるリクエスト数: 14 → 0 |
推論フレームワークの比較
この記事のテストはすべて単一の H100 GPU で実施しました。PyTorch、vLLM-Omni、SGLang-Omni は、Seed-TTS のオリジナルの test-en テキストを用い、参照音声なしで再測定しました。グラフでは、同じ Breeze TTS 2 モデルを用い、同時リクエスト数 1–16 の条件でこれらの実装と BreezeRT を比較しています。同時リクエスト数 16 において、BreezeRT の初回パケット遅延は p50 / p95 で 38 / 52 ms です。
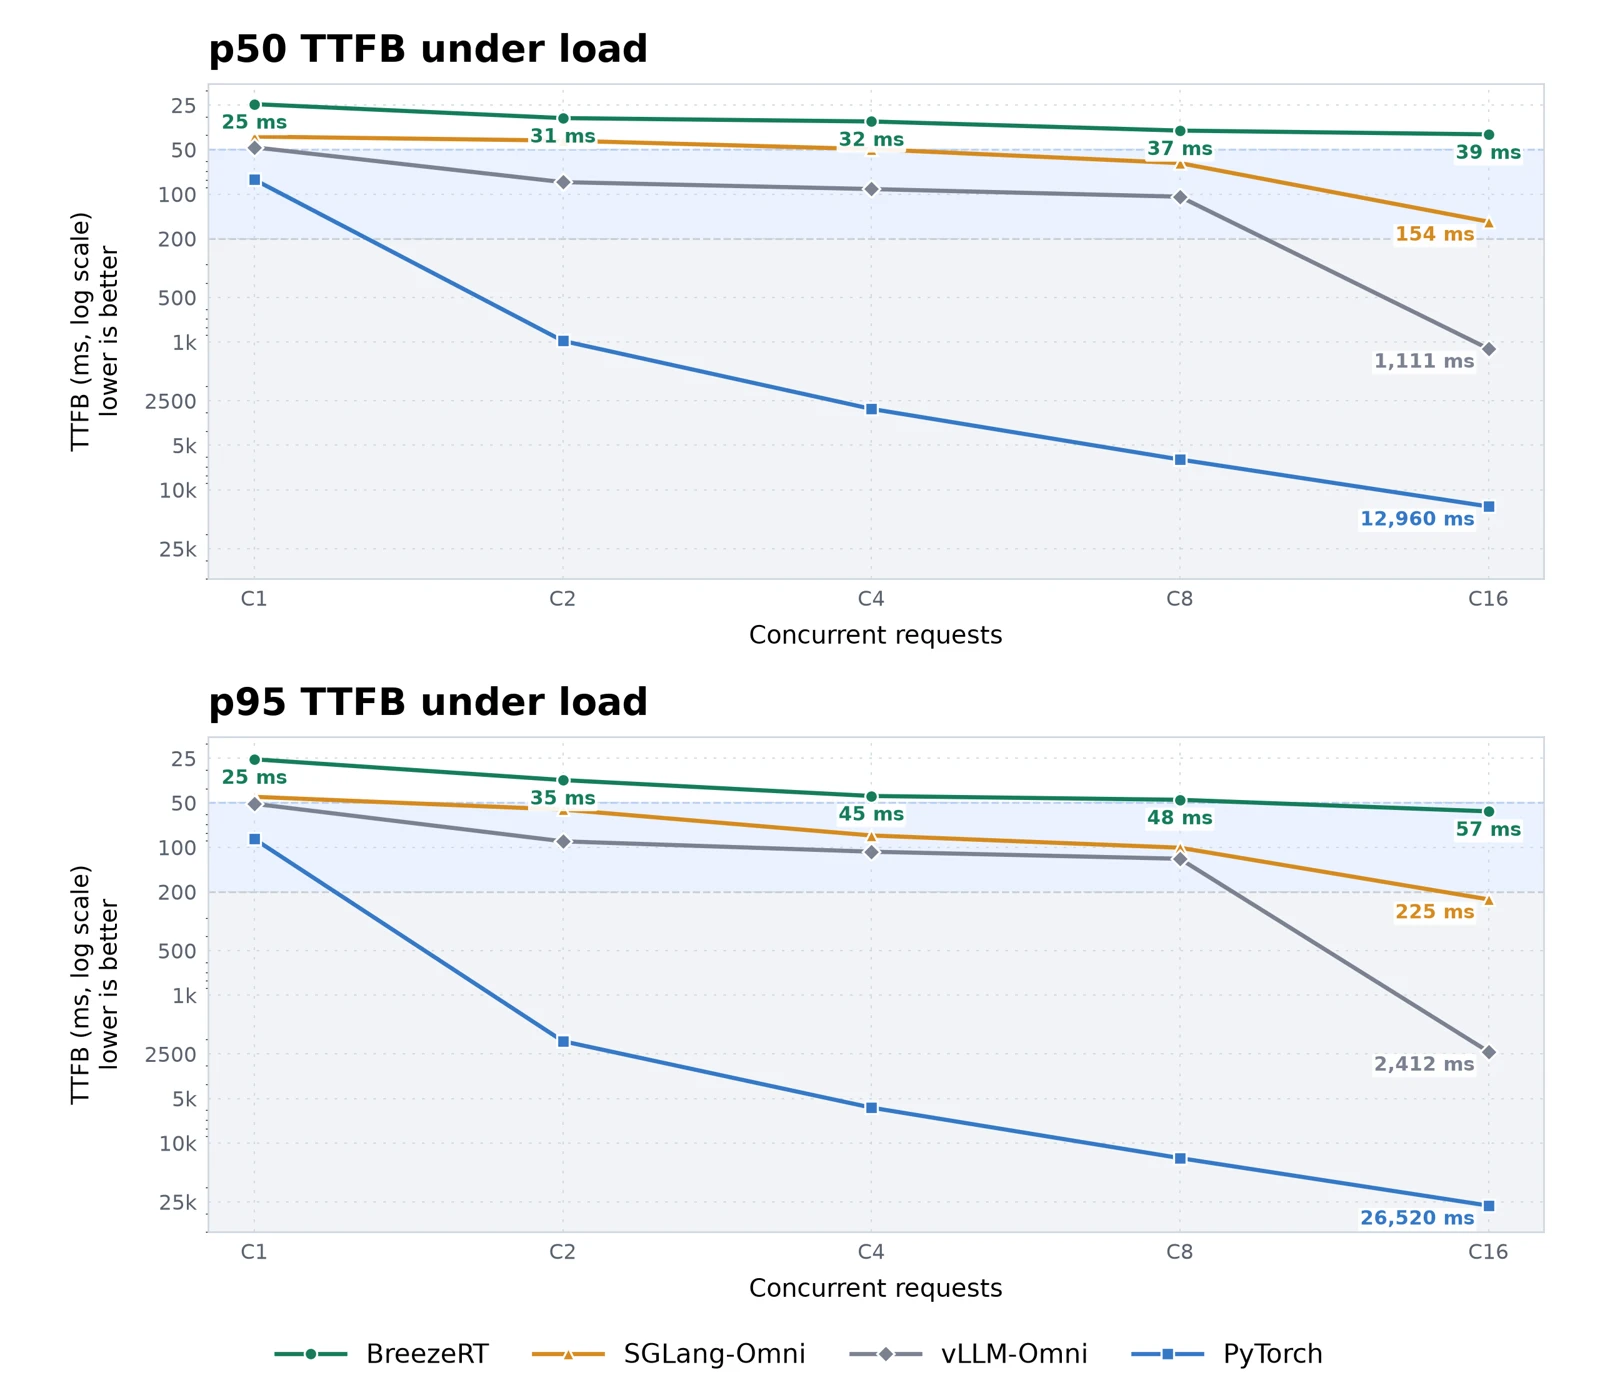
PyTorch、vLLM-Omni、SGLang-Omni を Breeze TTS 2 向けに対応させ、チューニングしました。グラフは、これらの実装の初回パケット遅延を示しています。これらの対応は、各オープンソースリポジトリにはまだマージされていません。
BreezeRT の 4 つの最適化
1. 複数段階の統合スケジューリング
Breeze TTS 2 は、まずテキストをエンコードし、Backbone Prefill を実行します。各音声フレームでは、Backbone が最初の音声コードを予測し、Depth Decoder が残りの 15 コードを生成し、Codec が波形サンプルを出力します。段階ごとに、必要な計算量、実行頻度、適したバッチサイズが異なります。
同時に処理するリクエストは、異なる段階にあることがよくあります。A は音声コードのデコード準備が整い、B は次のフレームを生成中で、C は到着したばかりで初回音声を待っています。A の処理を続けると、B と C は待たされます。スケジューラーは、一文全体が完成する前にリクエストを切り替える必要があります。
BreezeRT は、テキスト処理、Backbone Prefill、Backbone Decode、Depth、音声デコードを個別にスケジュールします。単一のランタイムがリクエストの進行状況、キャッシュ、出力待ちの音声を管理し、各段階の終了後に、次に実行する段階とリクエストを選択します。
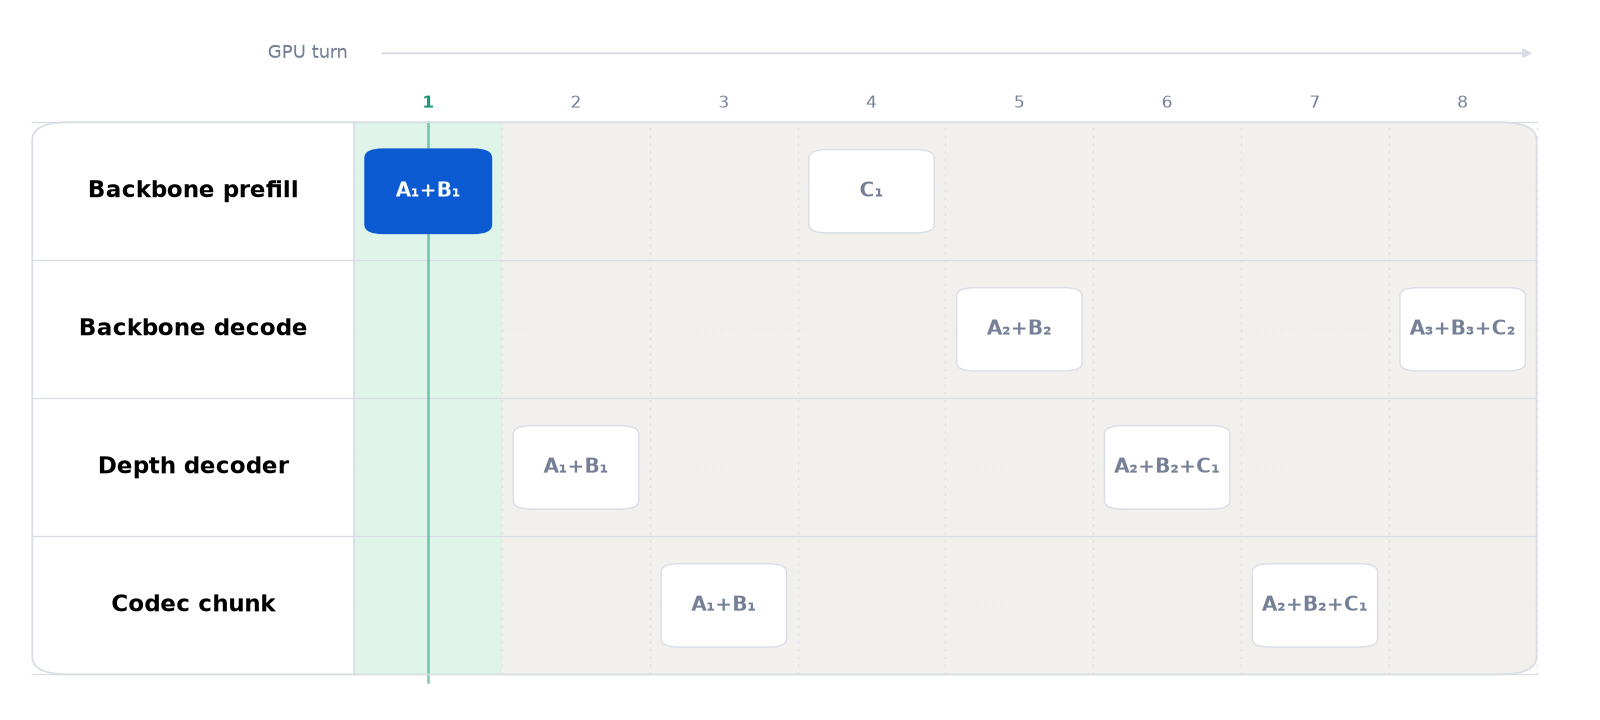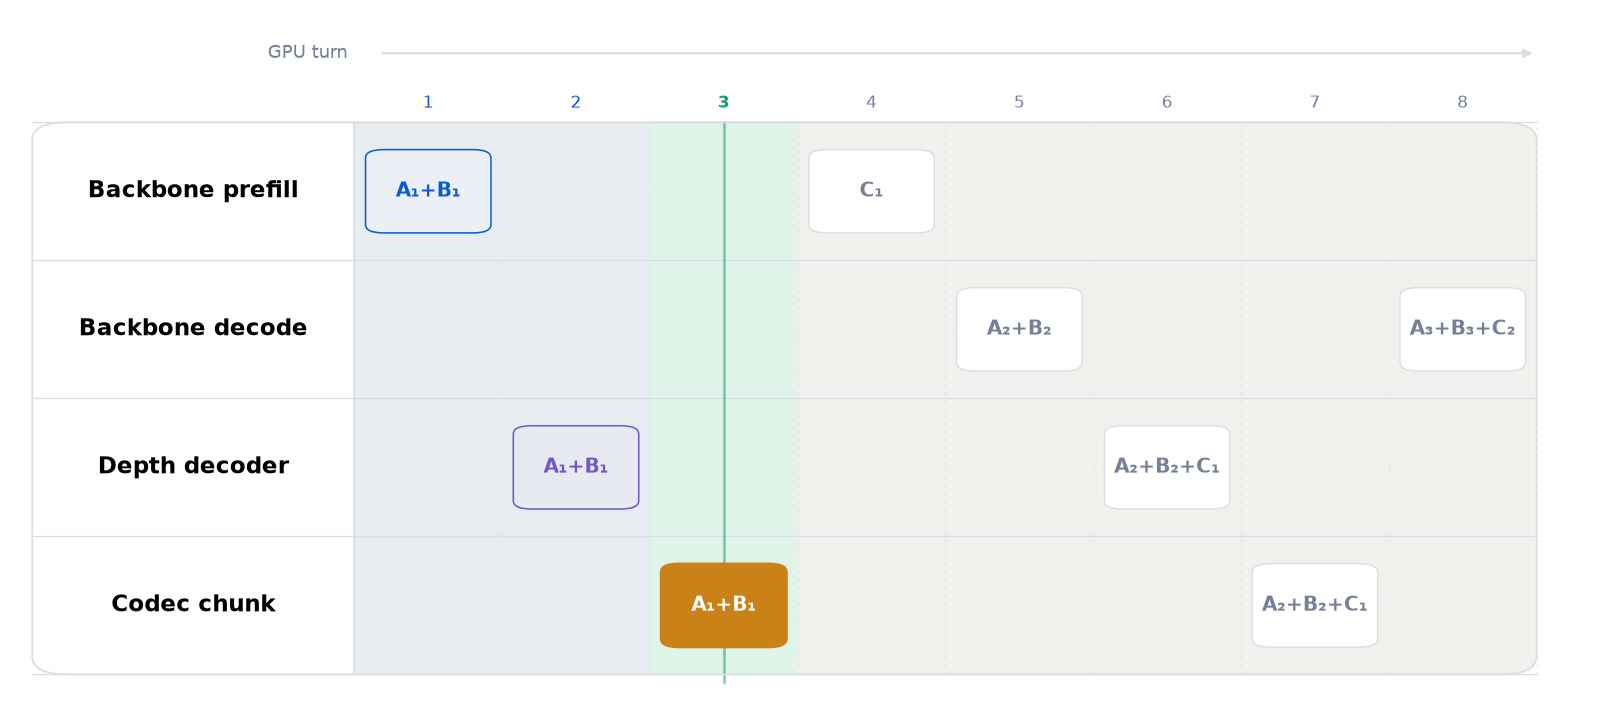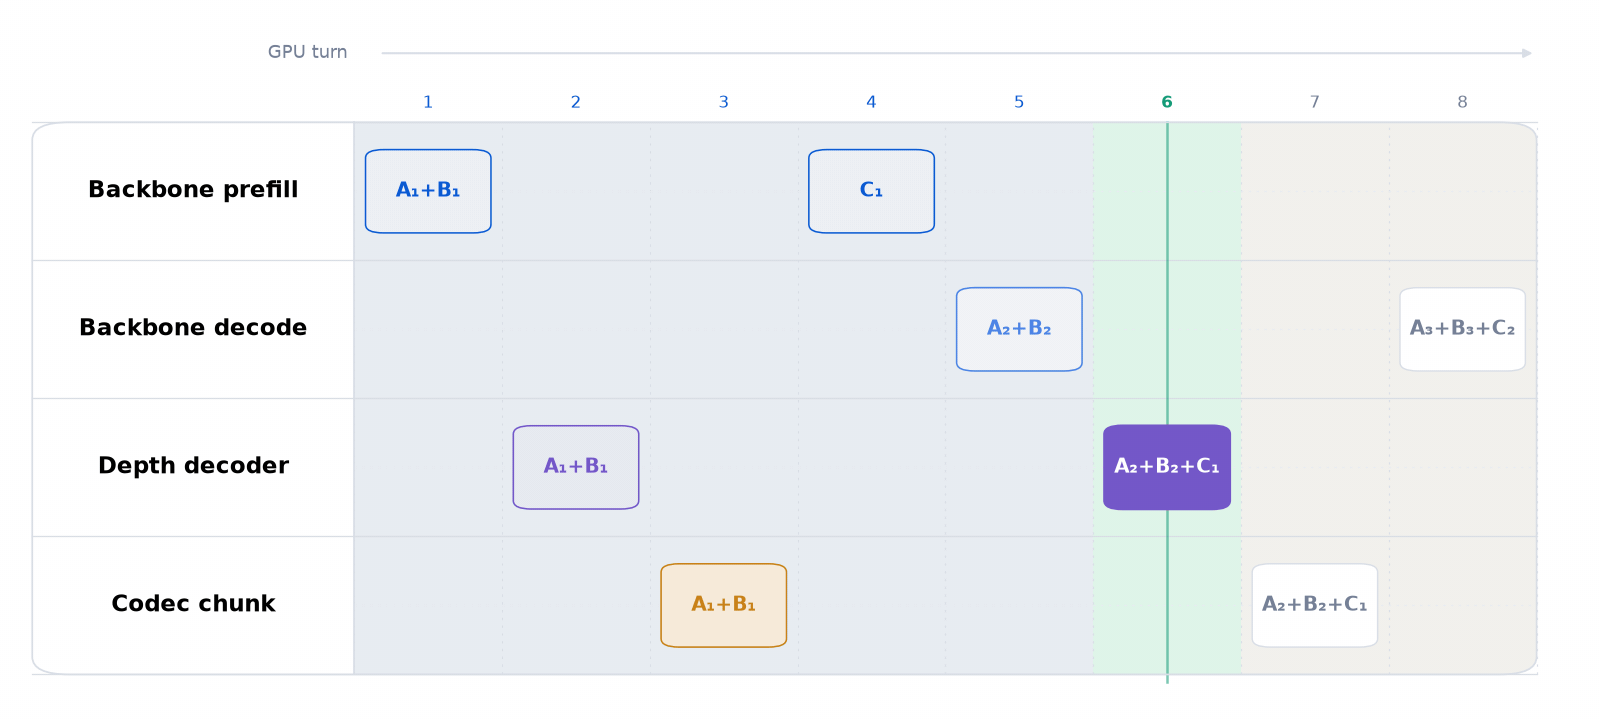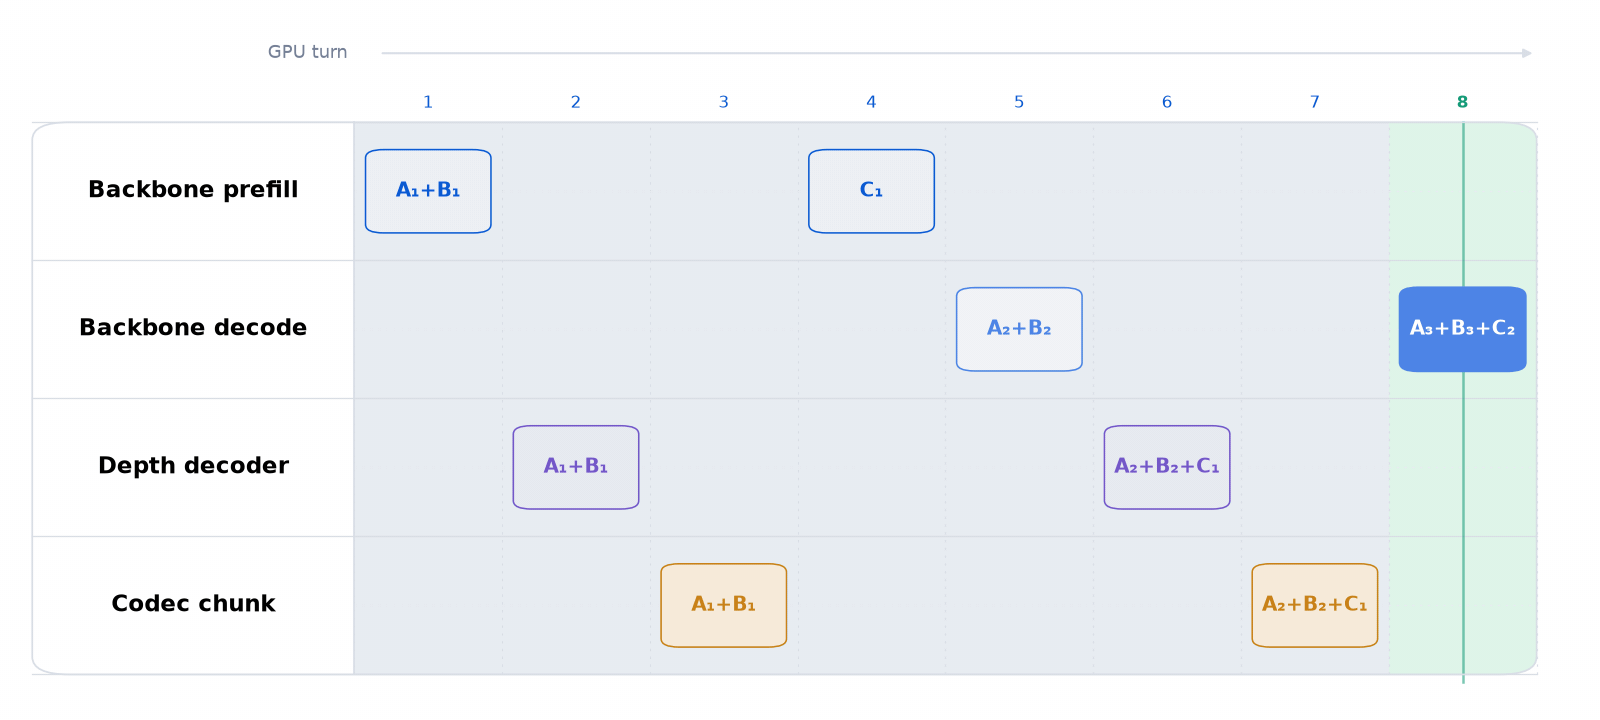
スケジューラーは優先度に応じてリクエストを選び、選択した段階内で処理をバッチ化します。段階ごとにバッチ上限があるため、Codec と Backbone は異なるバッチサイズを使用できます。新しいリクエストは段階の合間に処理へ参加でき、進行中のストリームにもデコードの時間を確保できます。同じランタイムが、チャンク化、グラフのリプレイ、期限に基づくスケジューリングを担います。
2. 段階的チャンク化と増分デコード
最初のチャンクが大きいと、ユーザーはより多くのフレームが揃うまで音声を聞けません。一方、1 フレームずつ送信すると、Codec とスケジューラーの実行頻度が増えます。リクエストが増えるほど、このオーバーヘッドが積み重なります。
BreezeRT は、たとえば 1、2、4、8、16 フレームのように、チャンクサイズを段階的に増やします。小さなチャンクですばやく再生を開始し、音声がある程度バッファーに蓄積された後は、大きなチャンクでデコードの呼び出し回数を減らします。
Codec は、同じ音声を再びデコードしないように、それまでの処理も保持する必要があります。BreezeRT は、リクエストごとにスライディングウィンドウ Transformer の KV、因果畳み込みの履歴、転置畳み込みの重なり部分の末尾を保存し、新しいフレームだけを処理します。これらのキャッシュにより、チャンクサイズが変わっても文脈を保持し、チャンクの境界を滑らかにつなぎます。
アブレーションは単一の H100 GPU 上で同時リクエスト数 16 の条件で実行し、構成ごとに 300 リクエストの初回パケット遅延 p50 を計測しました。最初のチャンクを 16 フレームに固定した場合は 1626 ms、段階的チャンク化では 136 ms に短縮されます。
3. Depth のコンパイルと CUDA Graphs
最初のチャンクを小さくすると、CPU の起動オーバーヘッドが目立つようになります。1 つの音声フレームの生成には、多数のモデル演算が必要です。高速な GPU でも、処理の投入と投入の間にアイドル状態になり得ます。BreezeRT はコンパイルによって計算のオーバーヘッドを減らし、CUDA Graphs を使ってキャプチャ済みの GPU 演算を 1 回のリプレイで投入します。
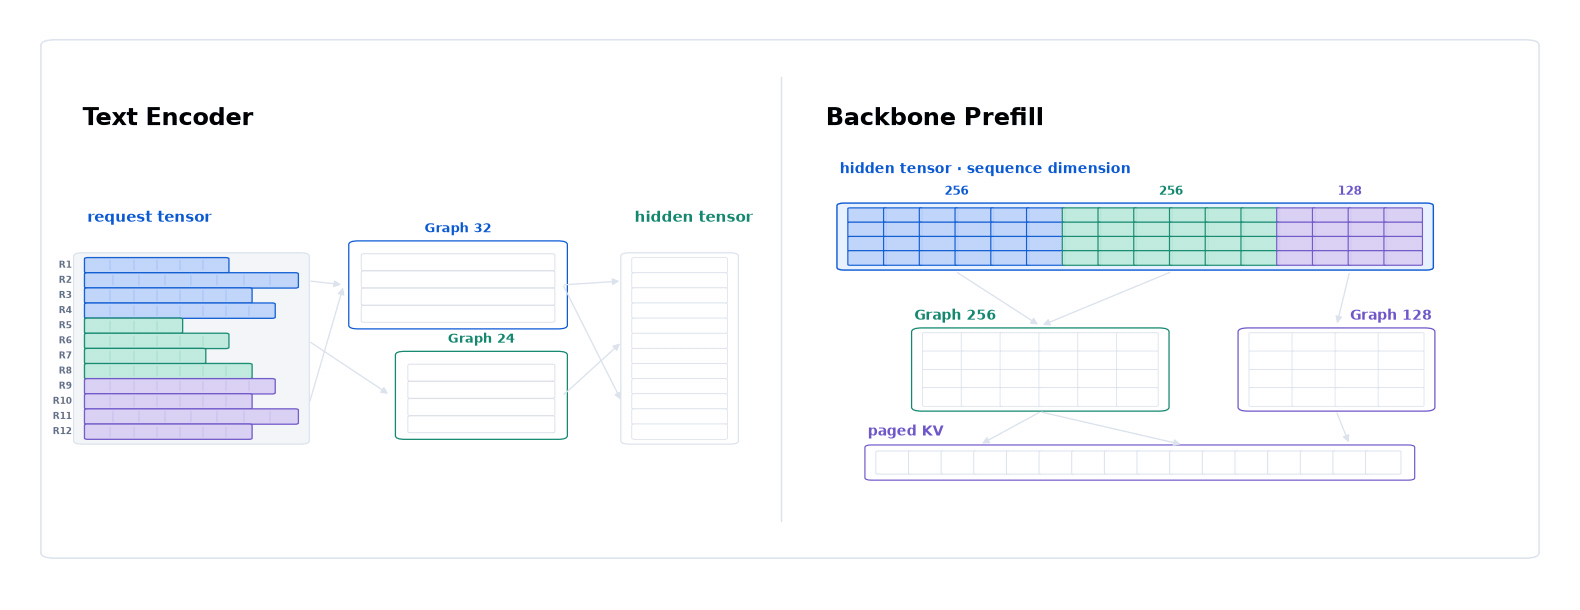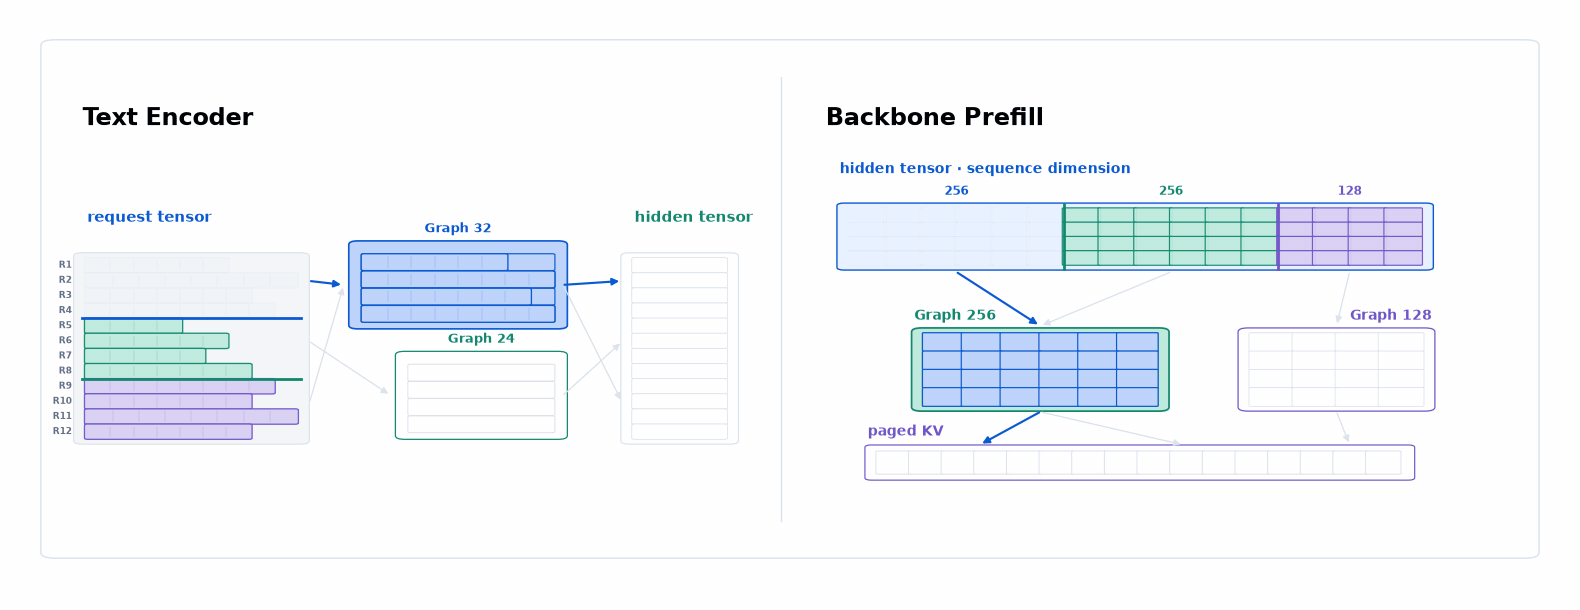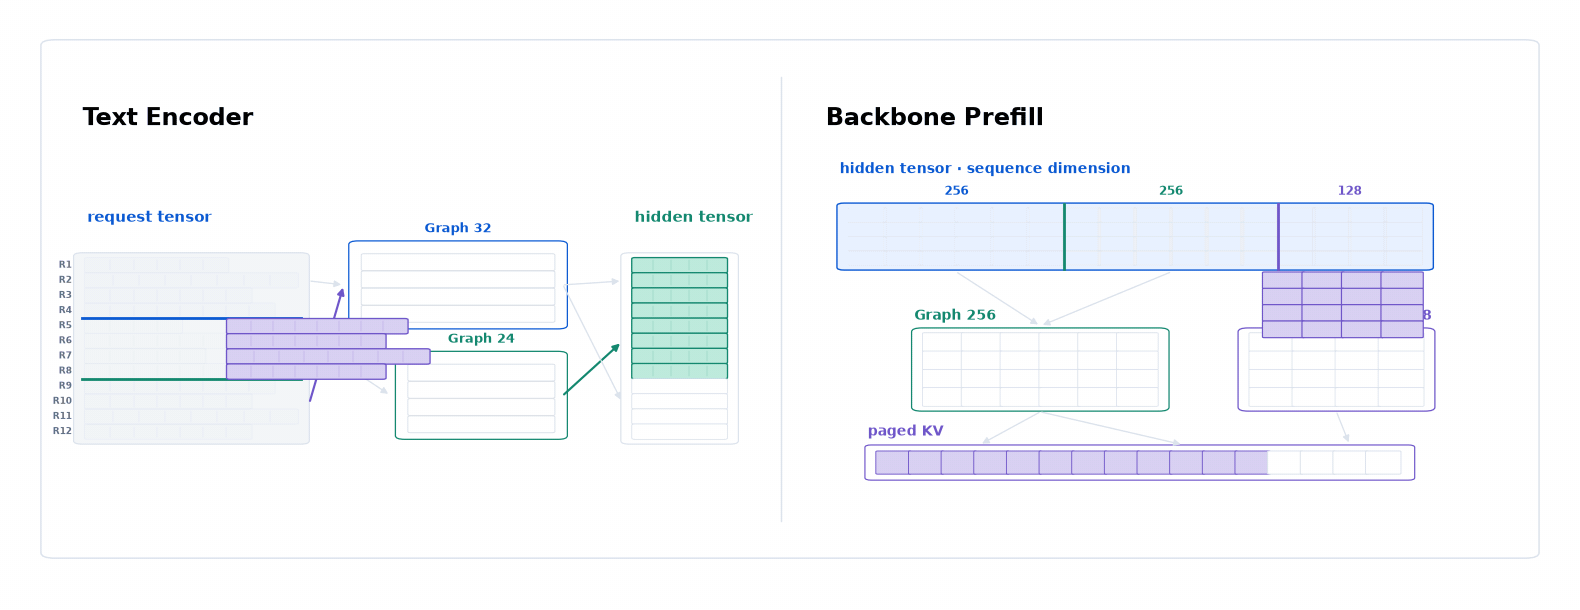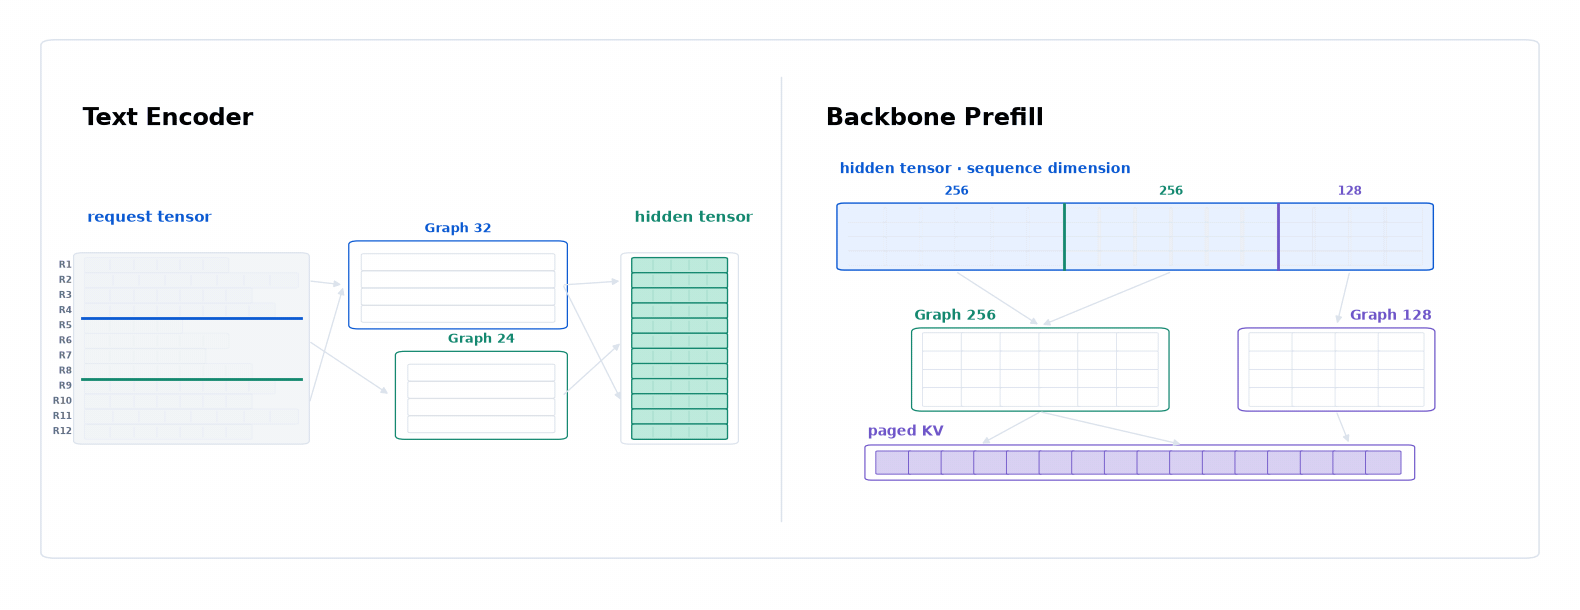
CUDA Graph のリプレイには固定のテンソル形状が必要ですが、テキスト長、バッチサイズ、音声チャンクサイズは変化します。すべての組み合わせをキャプチャすると、メモリを消費しすぎます。BreezeRT はよく使う形状を一式保持し、それに合わせて入力を分割またはパディングします。
Text Encoder はトークンを詰め合わせ、リクエスト数とトークン容量に応じて処理を分割することで、パディングを減らします。Attention はリクエストごとに独立したままです。Backbone Prefill はトークン単位のチャンクで動作し、ページ化された KV が各リクエストの生成履歴を保存するため、既存のグラフとバッファーを再利用できます。
Depth Decoder は、フレームごとに追加の 15 音声コードを生成します。BreezeRT はデコーダースタックと出力ヘッドをそれぞれ全体としてコンパイルし、融合可能な要素単位の演算をまとめてカーネル数を減らします。これにより、中間テンソルの読み書きとカーネル起動を削減できます。これらの反復処理は、同時リクエスト間で積み重なります。KV、位置、入出力のバッファーは事前に確保します。自己回帰ループ全体を 1 つのグラフにキャプチャするため、1 回のリプレイで全 15 ステップを依存関係の順に実行できます。
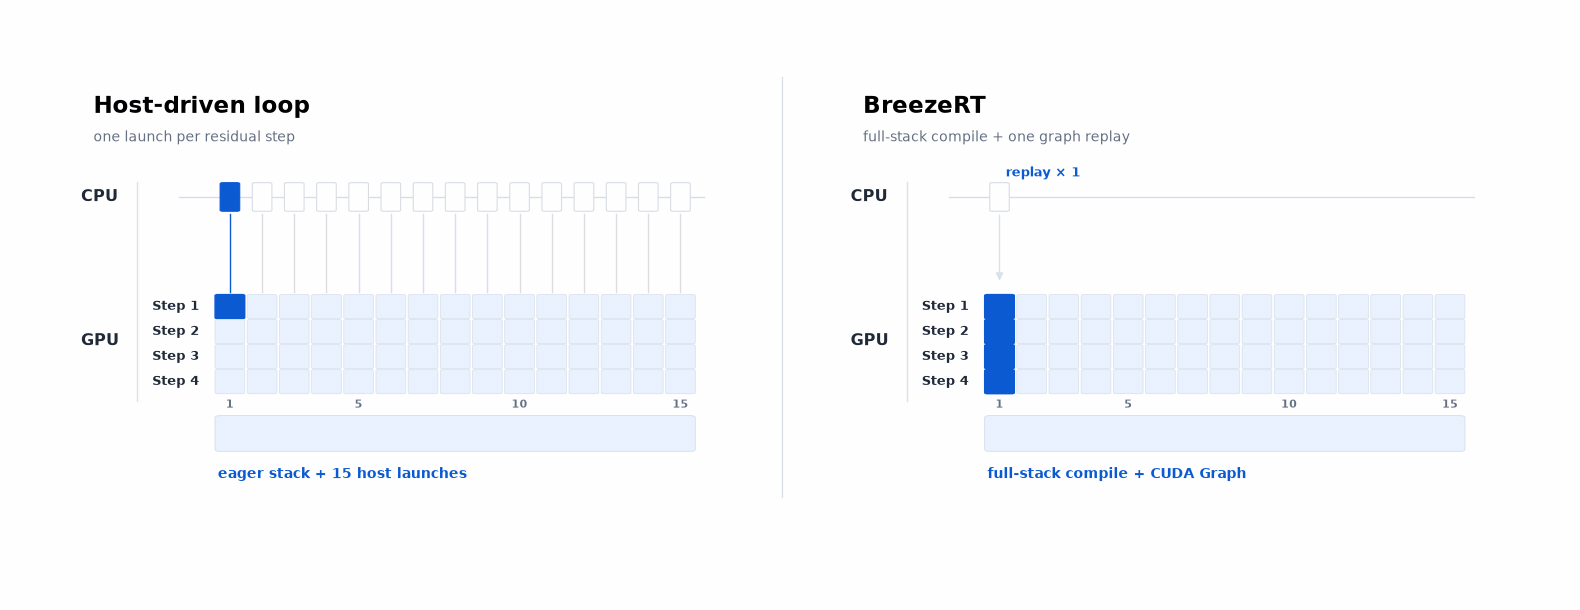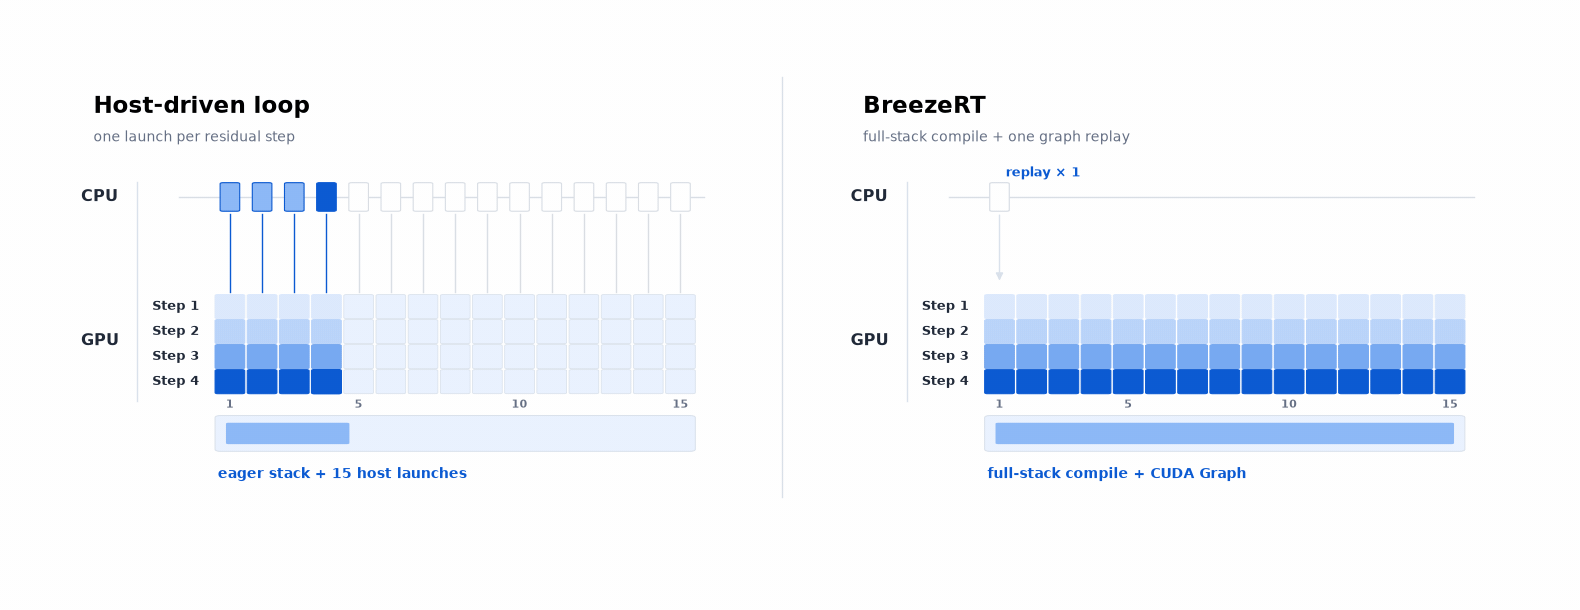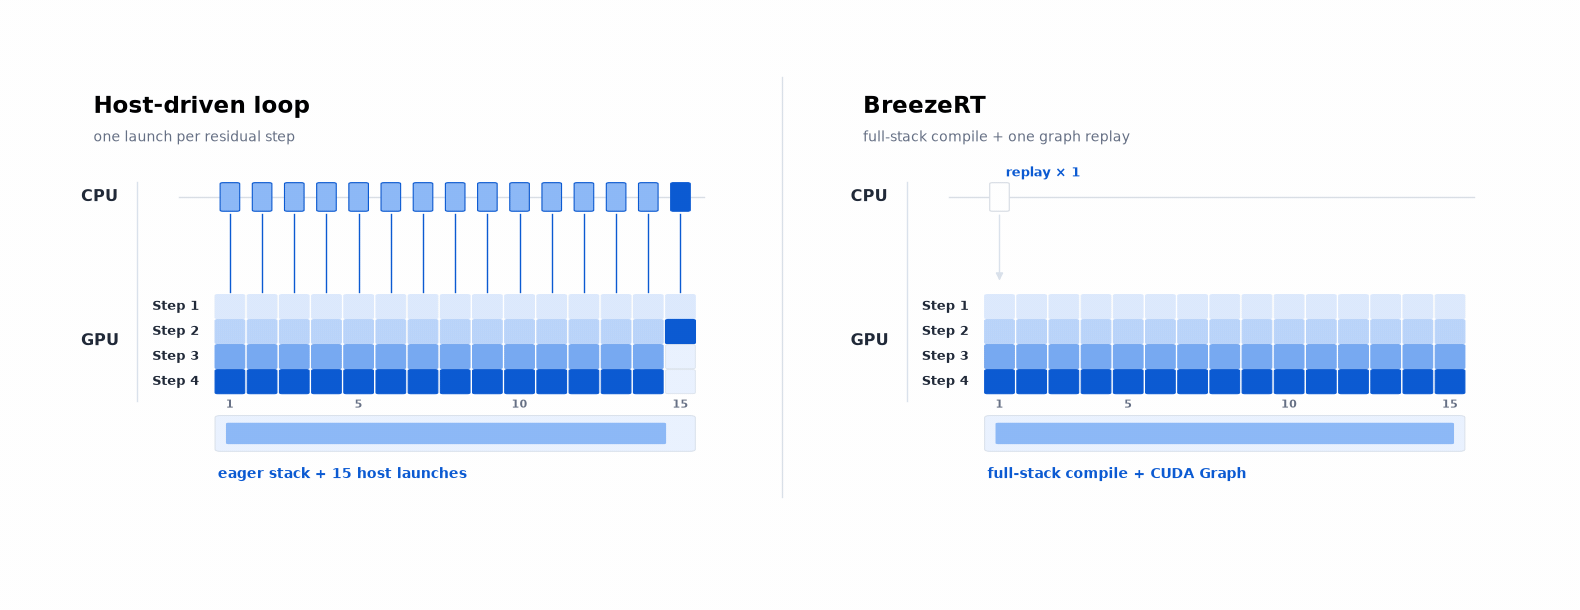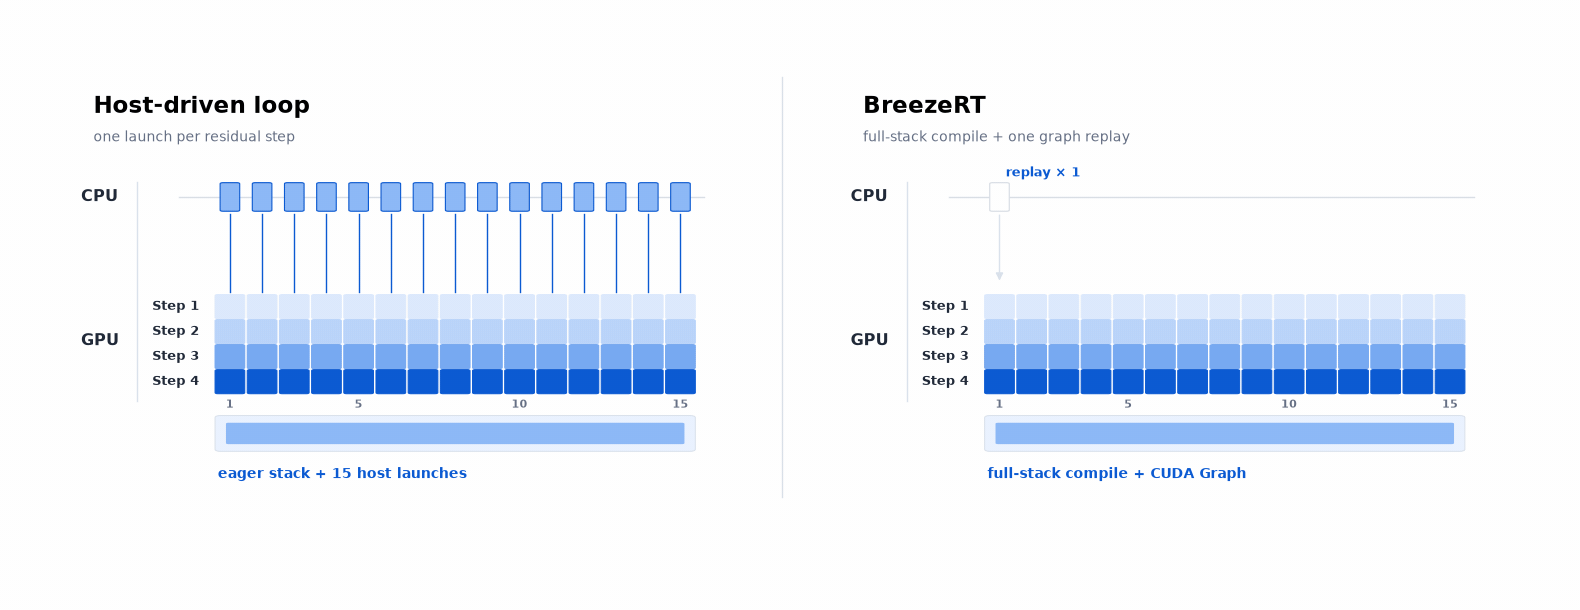
テキストのエンコード、Backbone、Depth、音声デコードのすべてでグラフを使用し、起動時によく使う形状をウォームアップします。各リクエストは固有のサンプリング設定と乱数状態を保持します。同じ C16 アブレーションにおいて、チャンク化の条件を変えないまま、初回パケット遅延 p50 は 136 ms から、Depth のコンパイルにより 85 ms、全段階へのグラフ適用により 38 ms に短縮されます。
4. Predictor:初回音声と再生期限
新しいリクエストは発話開始を待ち、進行中のストリームは次のチャンクを待っています。新しいリクエストを常に優先すると、再生が途切れる可能性があります。進行中のストリームの音声を先まで生成しすぎると、新しいリクエストが待たされます。Predictor は再生期限を使って、どの処理を先に実行するかを決めます。
新しいリクエストには開始時の優先度を与えます。進行中のストリームでは、初回出力時刻と音声の総時間から再生期限を推定します。Predictor はバッチサイズごとに各段階の直近の実行時間を記録し、残りの Backbone、Depth、Codec の処理が期限に間に合うかを見積もる際に余裕を持たせます。
たとえば、A はデコード可能な状態ですが、B が同じバッチに入るには、あと 1 回の生成ステップが必要だとします。バッチ化によって時間を節約でき、A の再生期限にも間に合うなら、スケジューラーは B を待ちます。そうでなければ、A を先に実行します。目標のチャンクを期限内に完成できない場合、ランタイムはプレーヤーを待たせず、生成済みのフレームを送信できます。
Predictor は軽量な実行時間推定を用います。300 リクエストの比較では、再生が途切れる可能性のあるリクエストが 14 件から 0 件に減りました。音声パケットの到着時刻に基づくと、Predictor なしでは、途切れを防ぐために最悪の場合で約 330 ms の音声を事前に追加でバッファーする必要がありました。Predictor を有効にした再測定では、最初のパケットの到着と同時に再生を開始し、追加の待ち時間なしで再生を継続できました。