BreezeRT 让 Breeze TTS 2 在高并发下也能快速输出首包。我们从请求调度、音频分块和 GPU 执行三处减少等待,再用 Predictor 安排首音和后续音频的输出时机:新请求尽快开口,正在播放的语音也能接得上。
BreezeRT 优化概览
| 优化 | 效果 |
|---|---|
| 1. 统一多阶段调度 | 减少等待 |
| 2. 渐进分块与增量解码 | C16 首包 p50: 1626 → 136 ms |
| 3. Depth 编译与 CUDA Graph | C16 首包 p50: 136 → 85 → 38 ms |
| 4. Predictor:首音与播放期限调度 | 300 个请求中存在潜在播放缺口的请求数: 14 → 0 |
推理框架对比
本文测试均在单张 H100 GPU 上完成。我们用 Seed-TTS test-en 的原始文本复测了 PyTorch、vLLM-Omni 和 SGLang-Omni,不提供参考音频。图中比较同一个 Breeze TTS 2 模型在各框架及 BreezeRT 上、1–16 路并发下的首包延迟。BreezeRT 在 16 路并发下的首包 p50 / p95 为 38 / 52 ms。
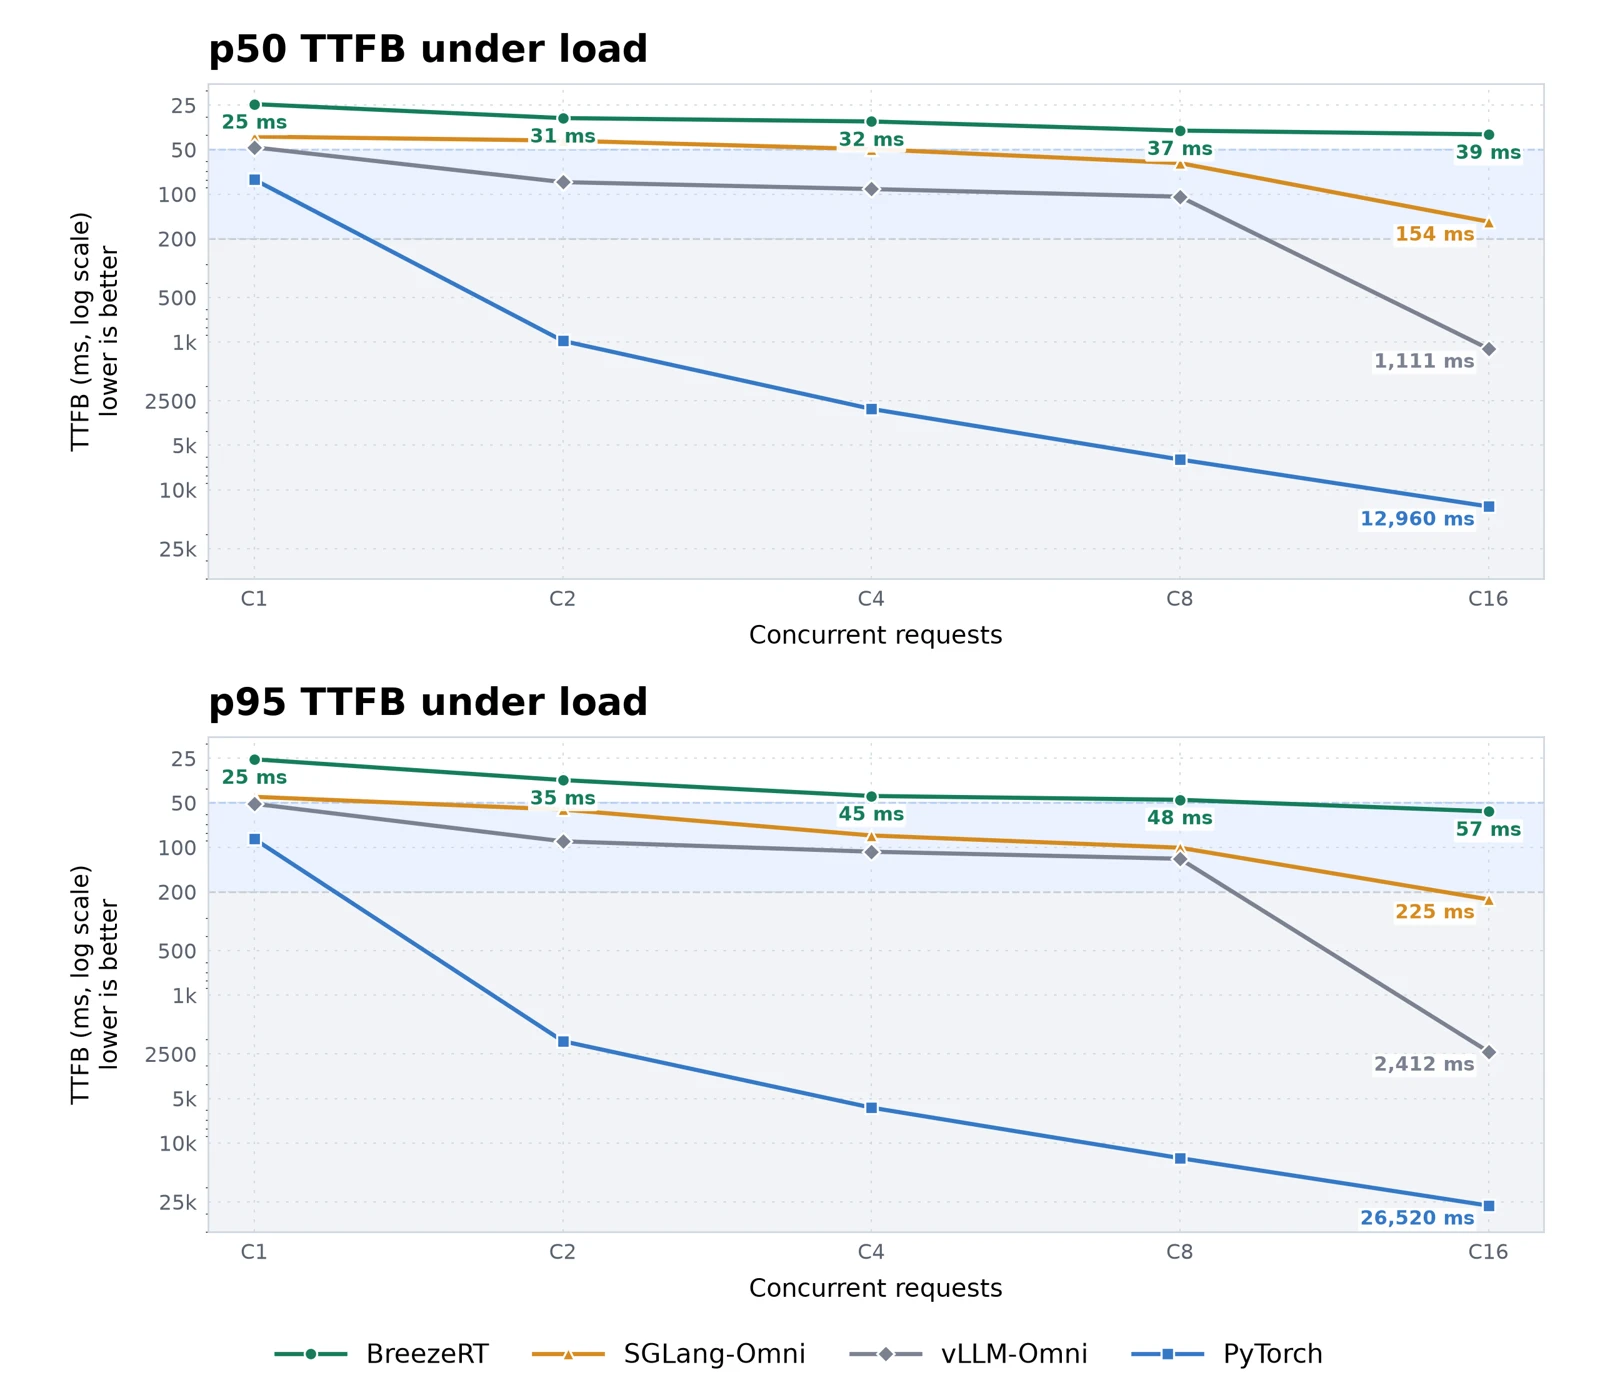
我们为 Breeze TTS 2 适配并调优了 PyTorch、vLLM-Omni 和 SGLang-Omni,图中展示这些适配版本的首包延迟。这些适配尚未合入对应的开源仓库。
BreezeRT 的四项优化
1. 统一多阶段调度
Breeze TTS 2 先执行文本编码和 Backbone Prefill。生成每帧语音时,Backbone 预测第一个音频码,Depth Decoder 补齐其余 15 个码,Codec 再将音频码转换为波形。各阶段的计算量、执行频率和适合的批量大小不同。
并发请求往往处于不同阶段:A 已有音频码,解码后就能播放;B 还在生成下一帧;C 刚到达,等着首音。如果一直处理 A,B 和 C 就只能等。调度器需要在这些请求之间切换,而不是等一句话全部生成完。
BreezeRT 将文本处理、Backbone Prefill、Backbone Decode、Depth 和音频解码分开调度。一个运行时统一管理请求进度、缓存和待输出音频;每完成一个阶段,就重新选择接下来执行的阶段和请求。
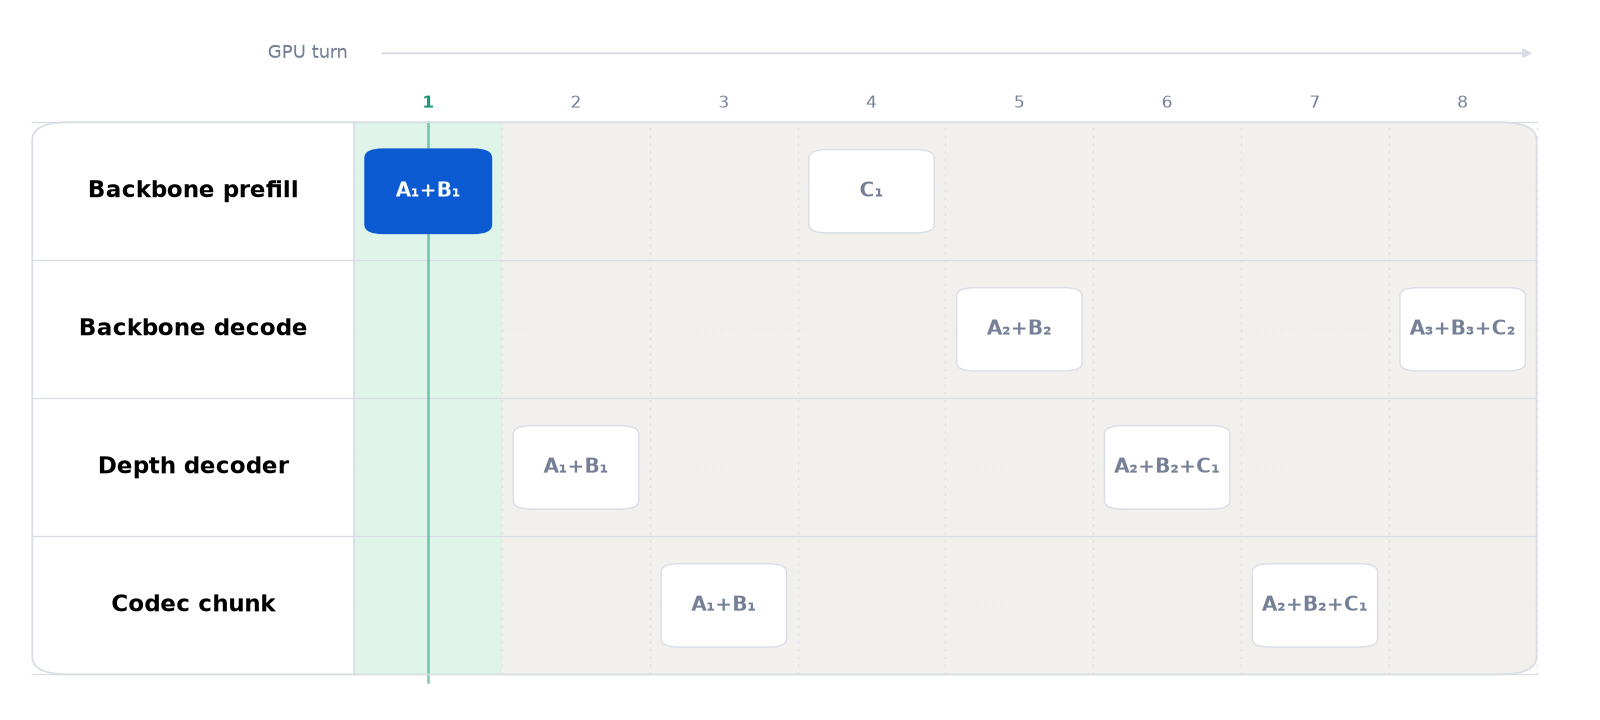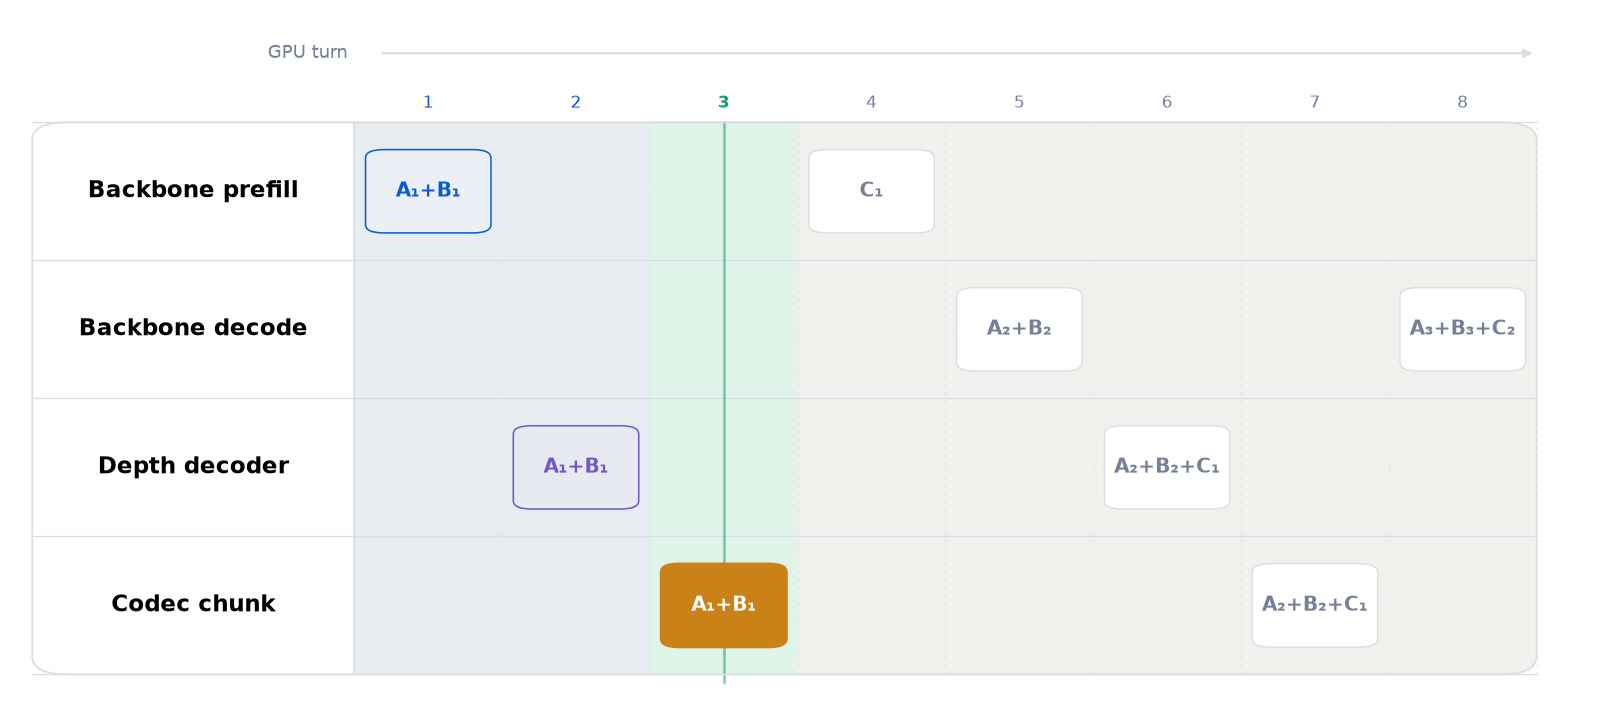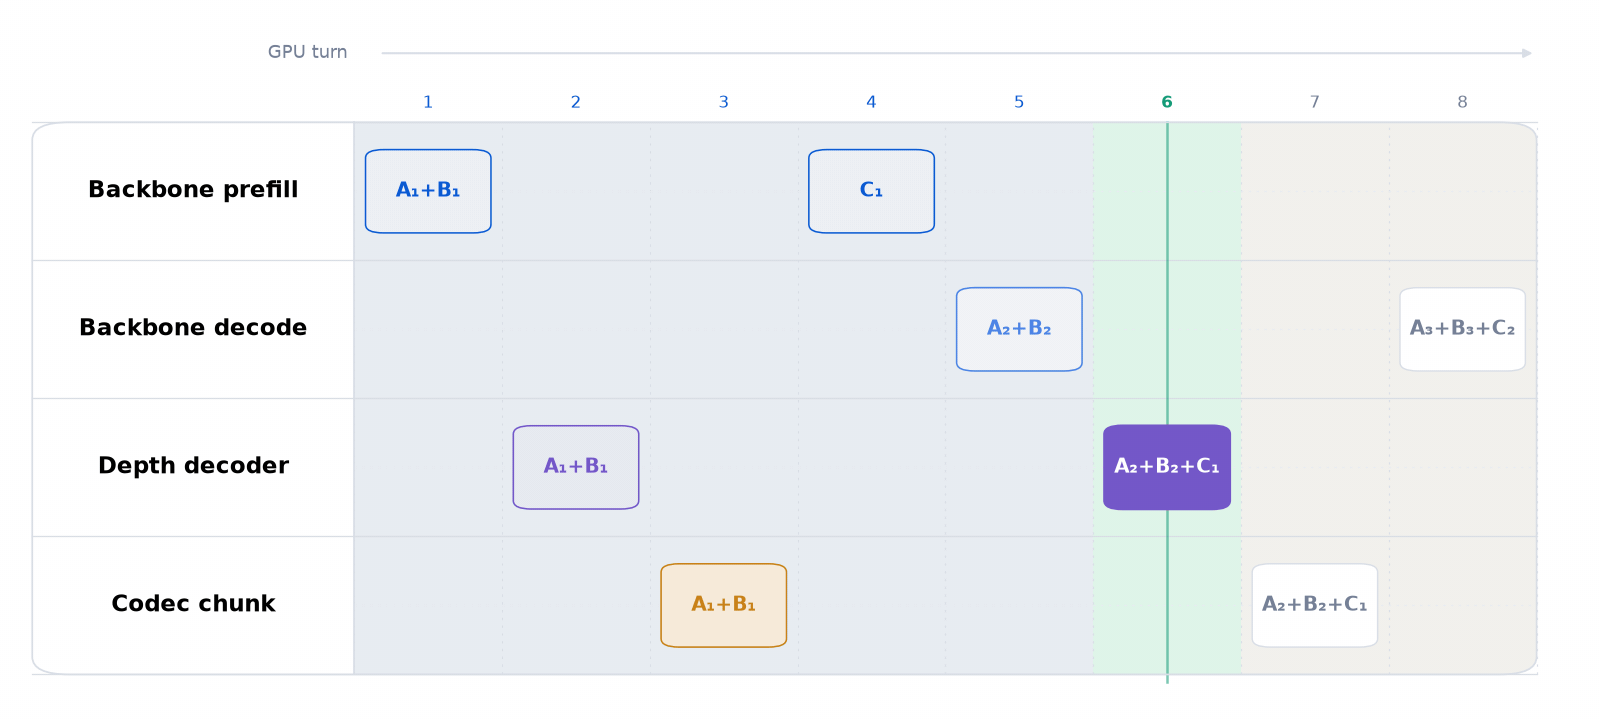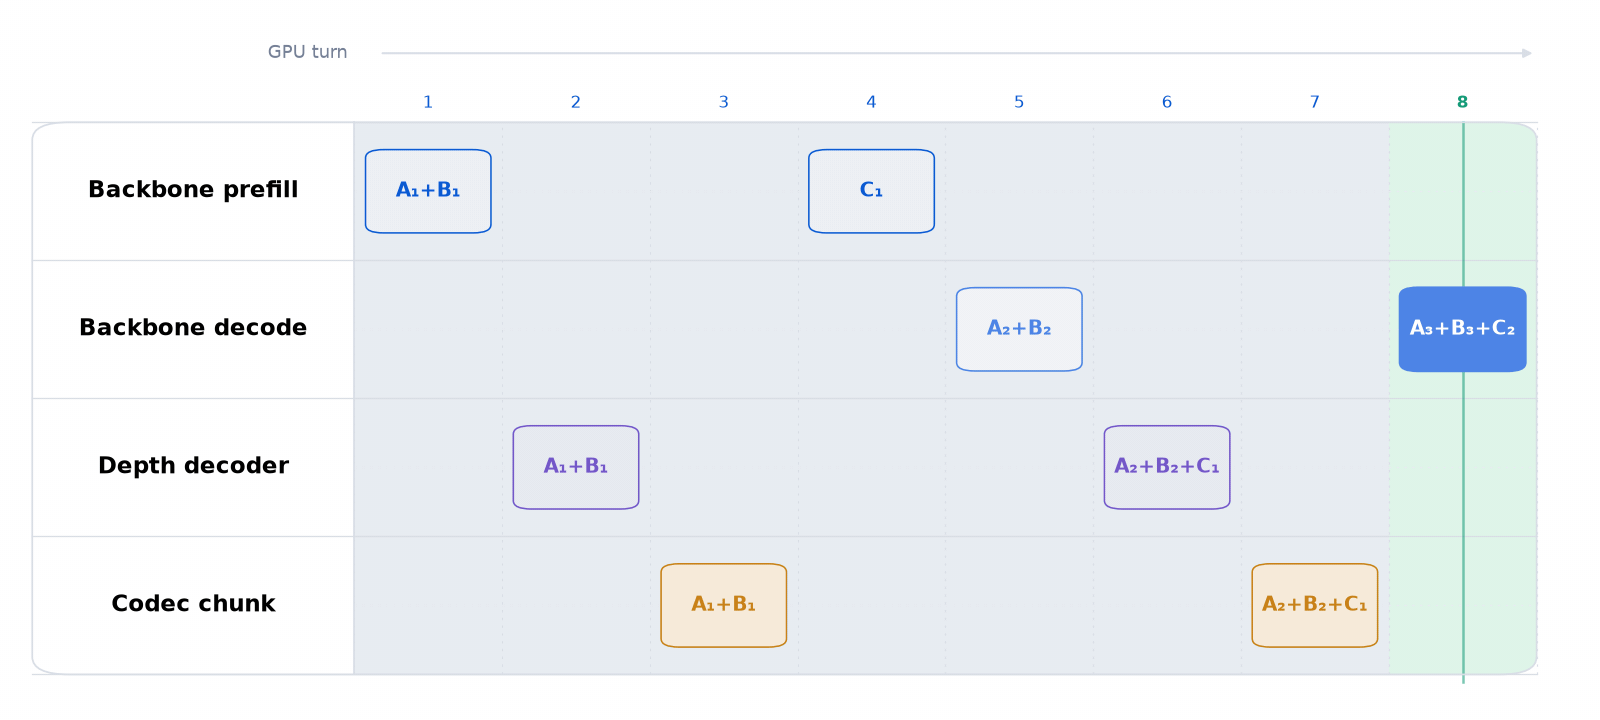
调度器先按优先级选请求,再将同一阶段的工作合批。各阶段独立设置批量上限,Codec 和 Backbone 不必使用相同的批量大小。新请求可以穿插处理,已有流也能及时解码。后面的分块、Graph 重放和期限调度都由这个运行时执行。
2. 渐进分块与增量解码
首块音频越大,用户就要等越多帧生成后才能听到声音。但如果每次只输出一帧,Codec 和调度器又得频繁执行。请求一多,这部分开销就不能忽略。
BreezeRT 让音频块逐步增大,例如 1、2、4、8、16 帧。开头用小块尽快开始播放,积累一定音频缓冲后,再用大块减少解码次数。
Codec 也需要记住之前处理过的内容,避免每次输出都重算历史音频。BreezeRT 为每个请求保存 Transformer 的滑动窗口 KV、因果卷积历史和转置卷积的重叠尾部,只处理新增的帧。分块大小改变时,这些缓存仍能保留上下文,让相邻音频块平滑衔接。
消融实验在单张 H100 GPU 上以 16 路并发运行,每档统计 300 条请求的首包延迟 p50。首块固定为 16 帧时为 1626 ms,改为渐进分块后降至 136 ms。
3. Depth 编译与 CUDA Graph
首块缩小后,CPU 提交计算的开销就更显眼了。生成一帧语音要执行很多次模型操作,GPU 算得快,也可能在两次提交之间空等。BreezeRT 用编译减少计算开销,再用 CUDA Graph 一次提交已捕获的 GPU 操作。
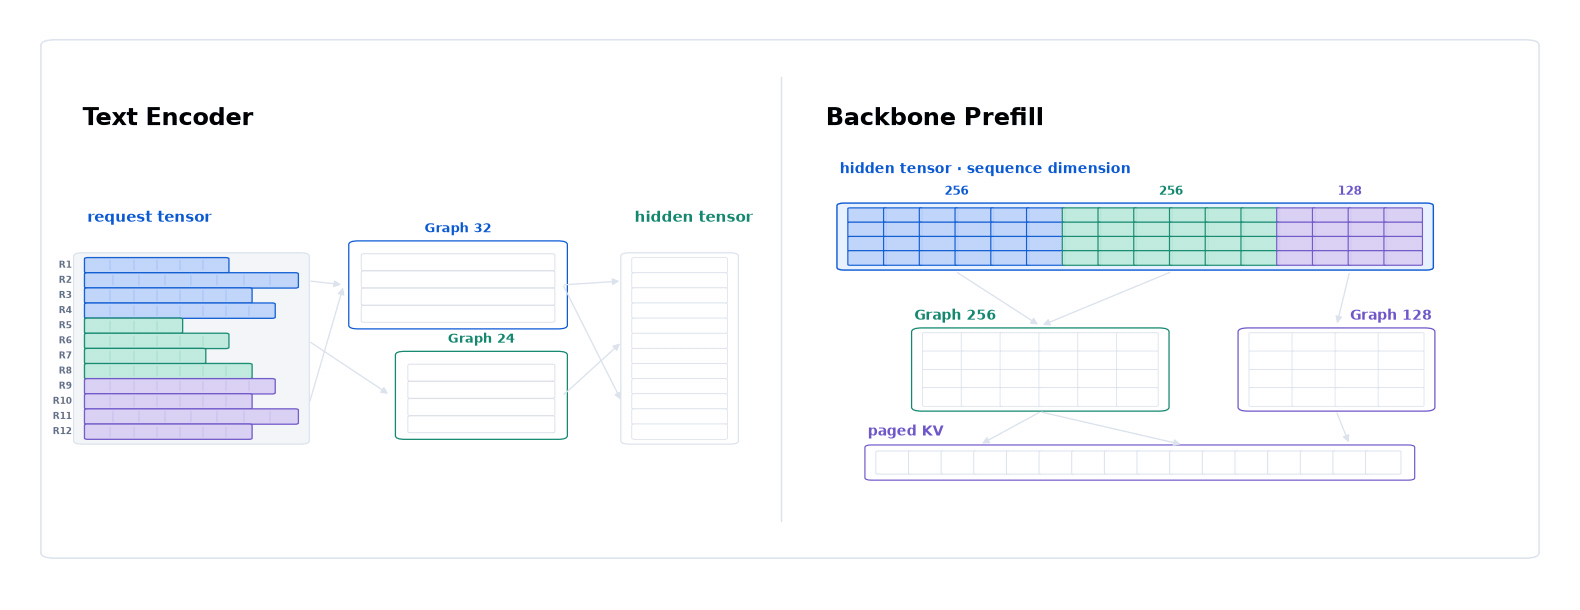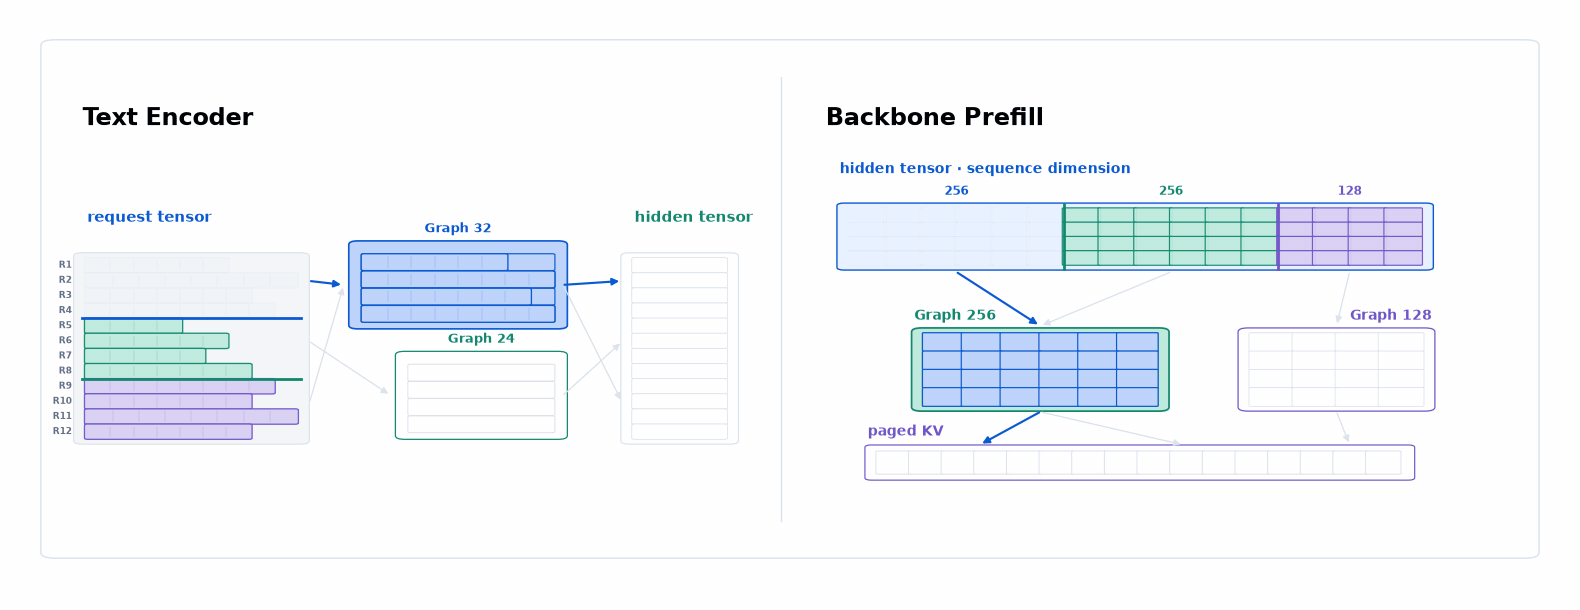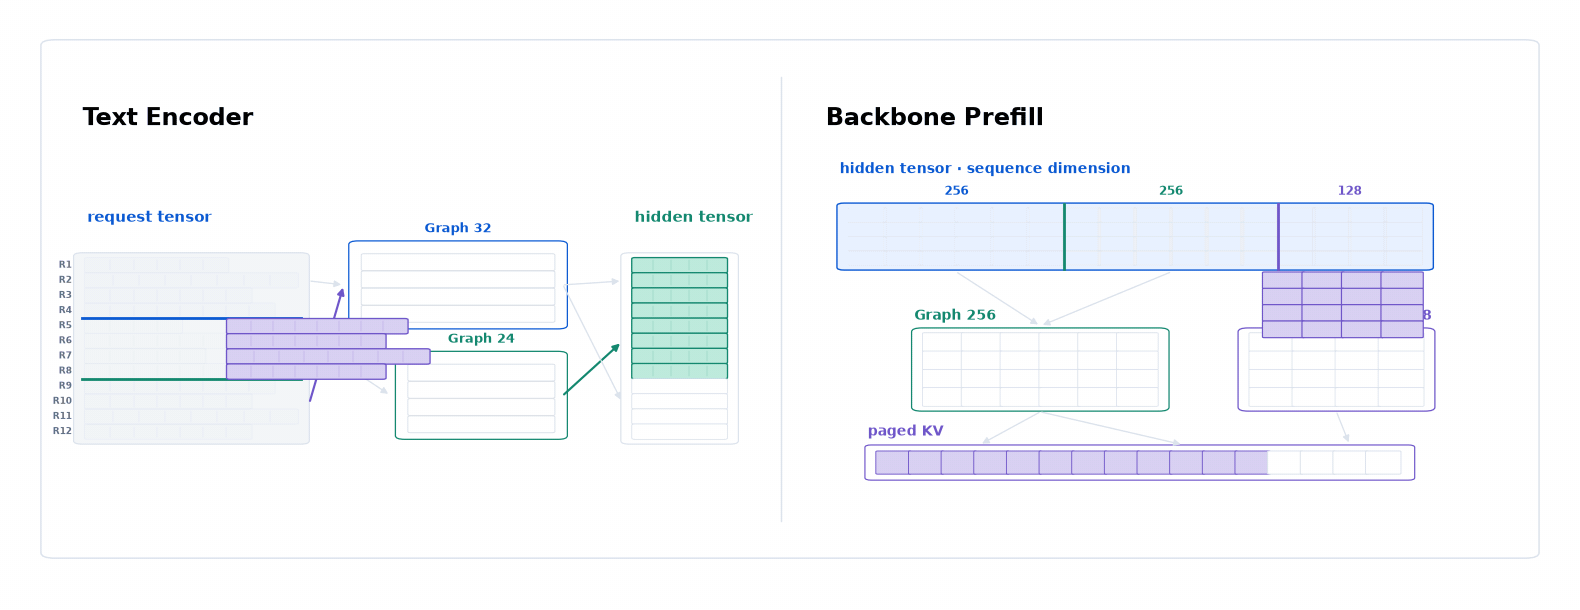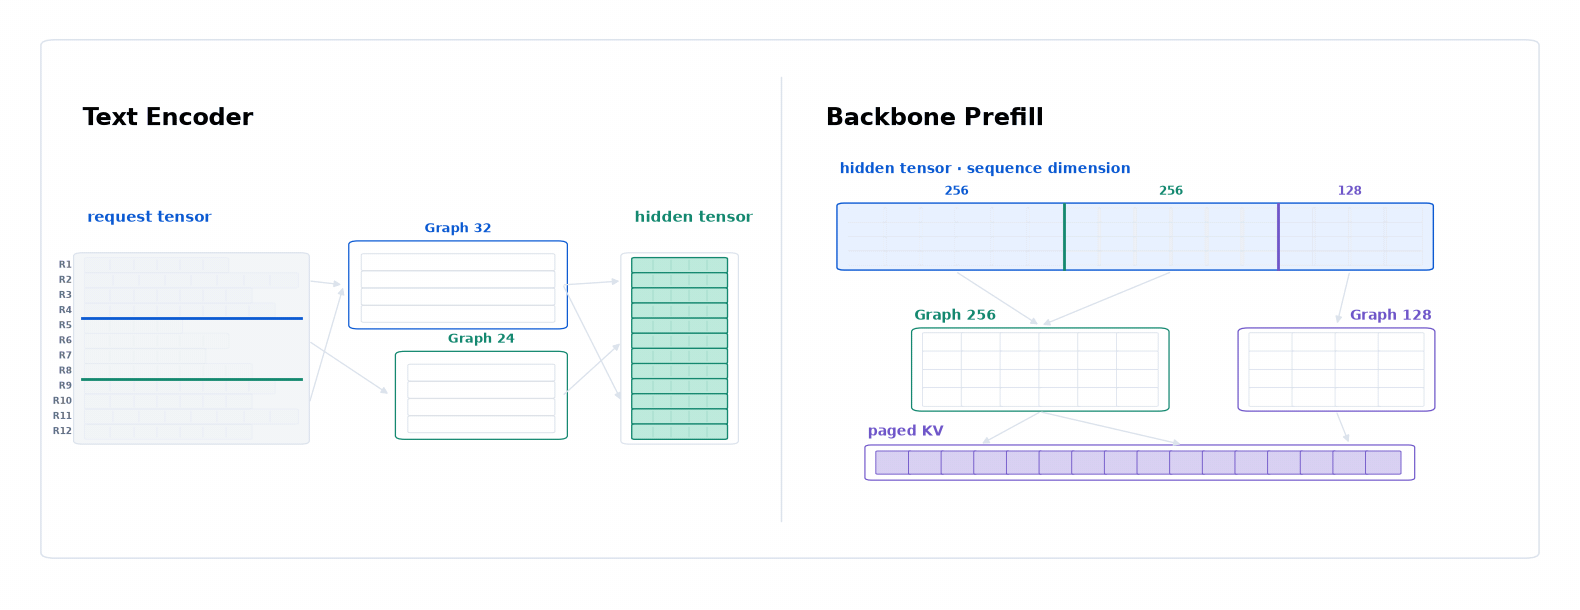
CUDA Graph 重放要求张量形状固定,但请求的文本长度、批量大小和音频块大小并不固定。为所有组合抓图会占用大量显存,因此 BreezeRT 只保留一组常用形状,把输入拆分或填充到这些形状后执行。
Text Encoder 将实际 token 打包,再按请求行数和 token 容量拆分,减少填充;不同请求之间的注意力仍然隔离。Backbone Prefill 按 token 分块,用分页 KV 保存各请求的生成历史,从而复用已有的 Graph 和缓冲。
Depth Decoder 每帧要补齐 15 个音频码。BreezeRT 整体编译 Decoder 堆栈和输出头,将可合并的逐元素计算融合为更少的 Kernel,减少中间张量读写和 Kernel 启动次数。并发请求越多,这些重复操作的开销越值得优化。KV、位置和输入输出缓冲预先分配,完整自回归循环则捕获为一张图,一次重放按依赖顺序执行全部 15 步。
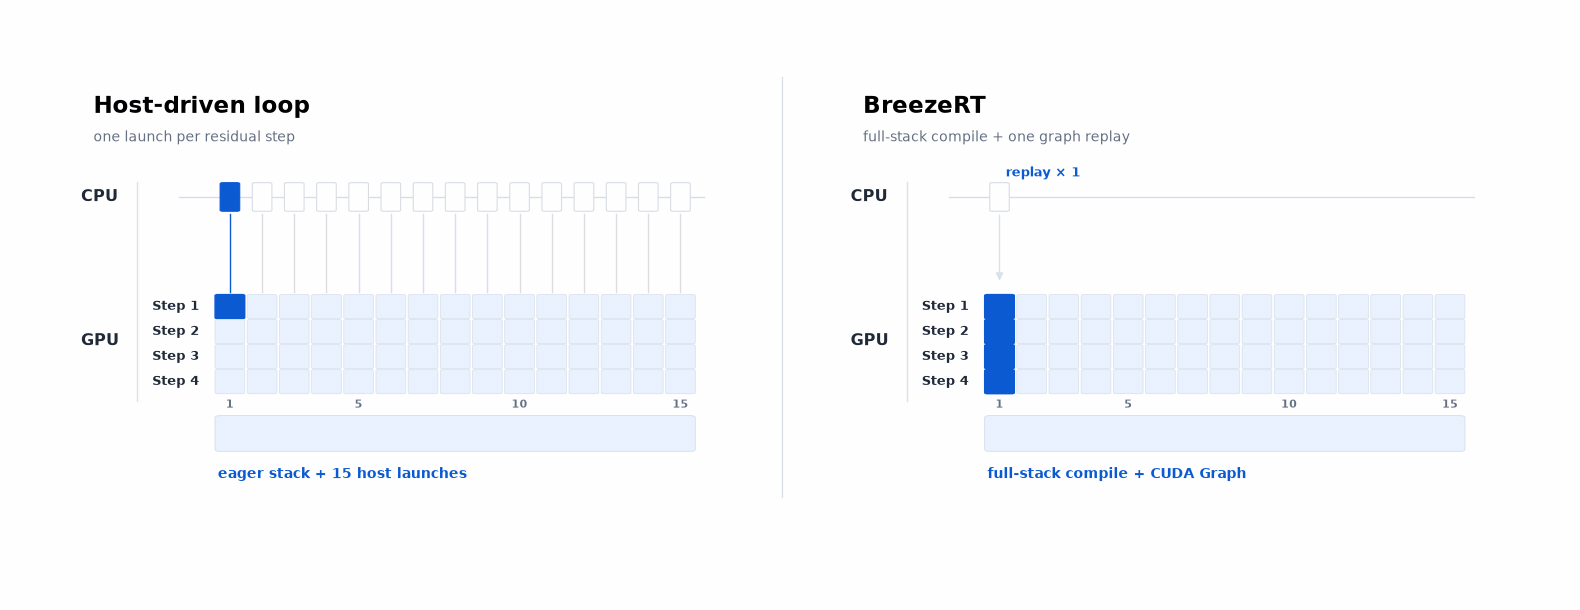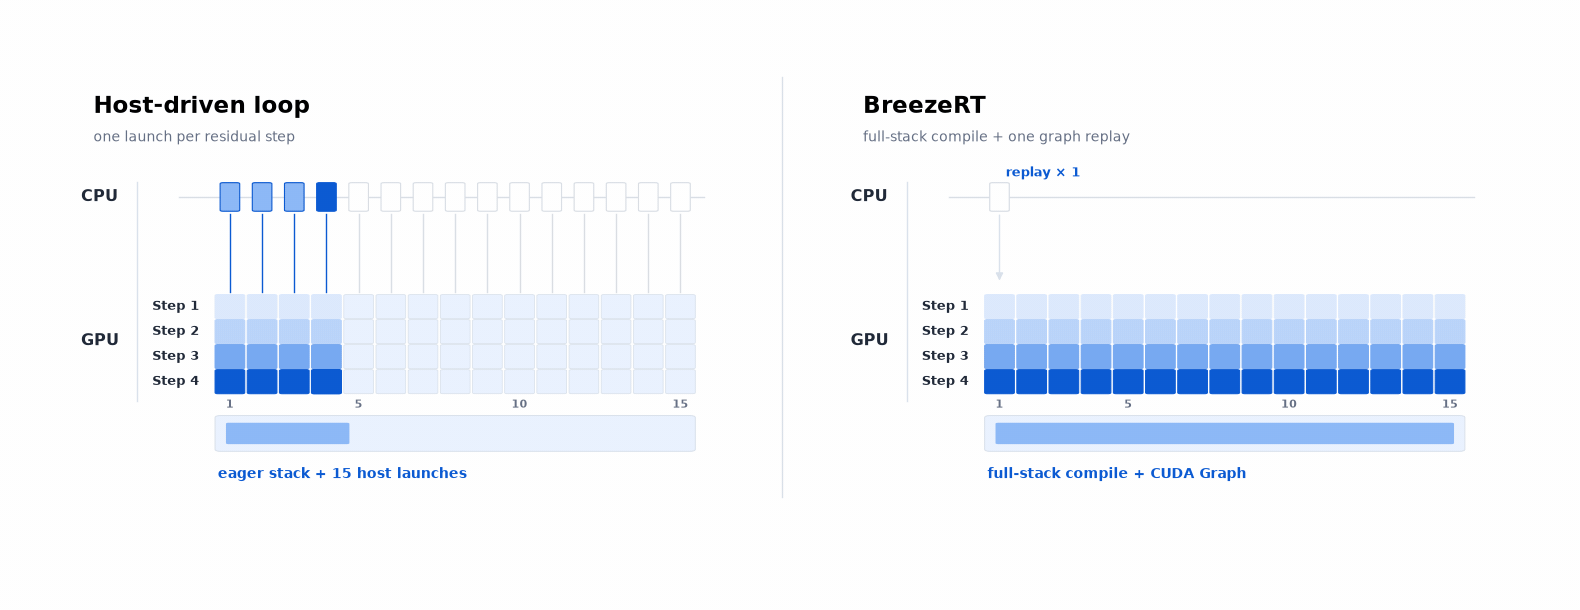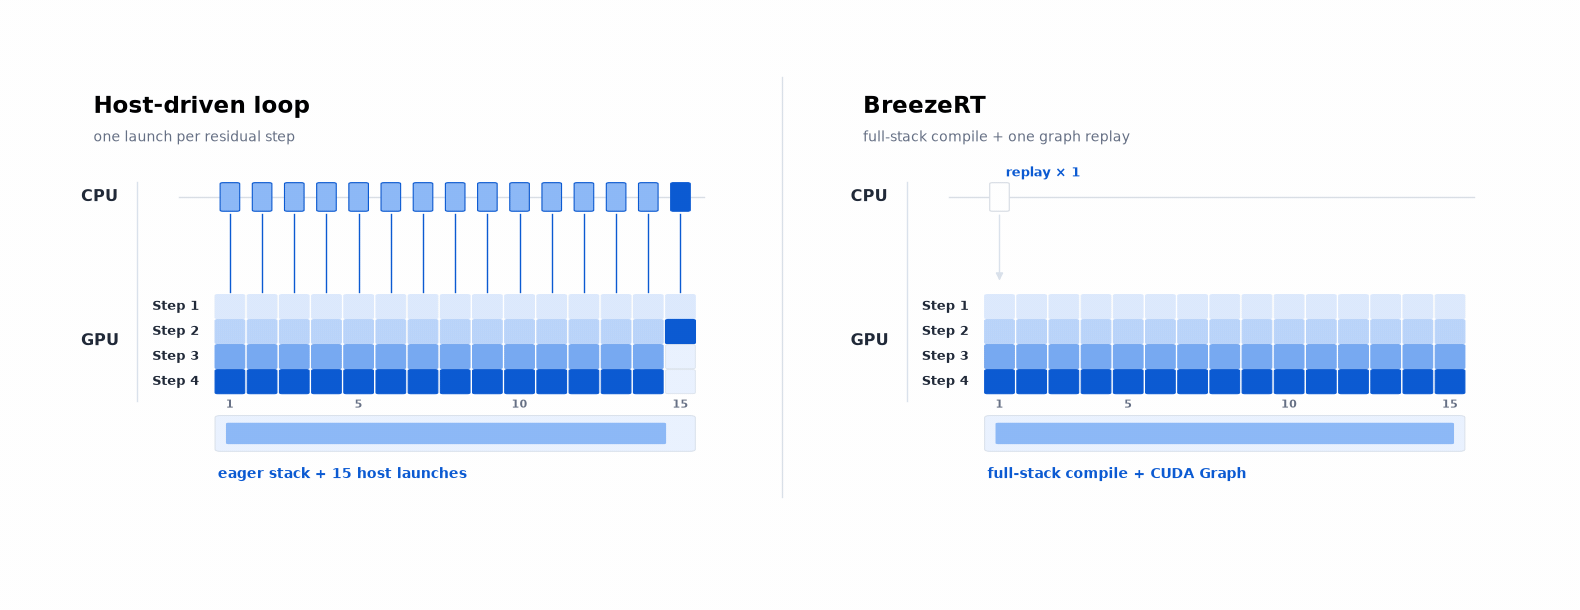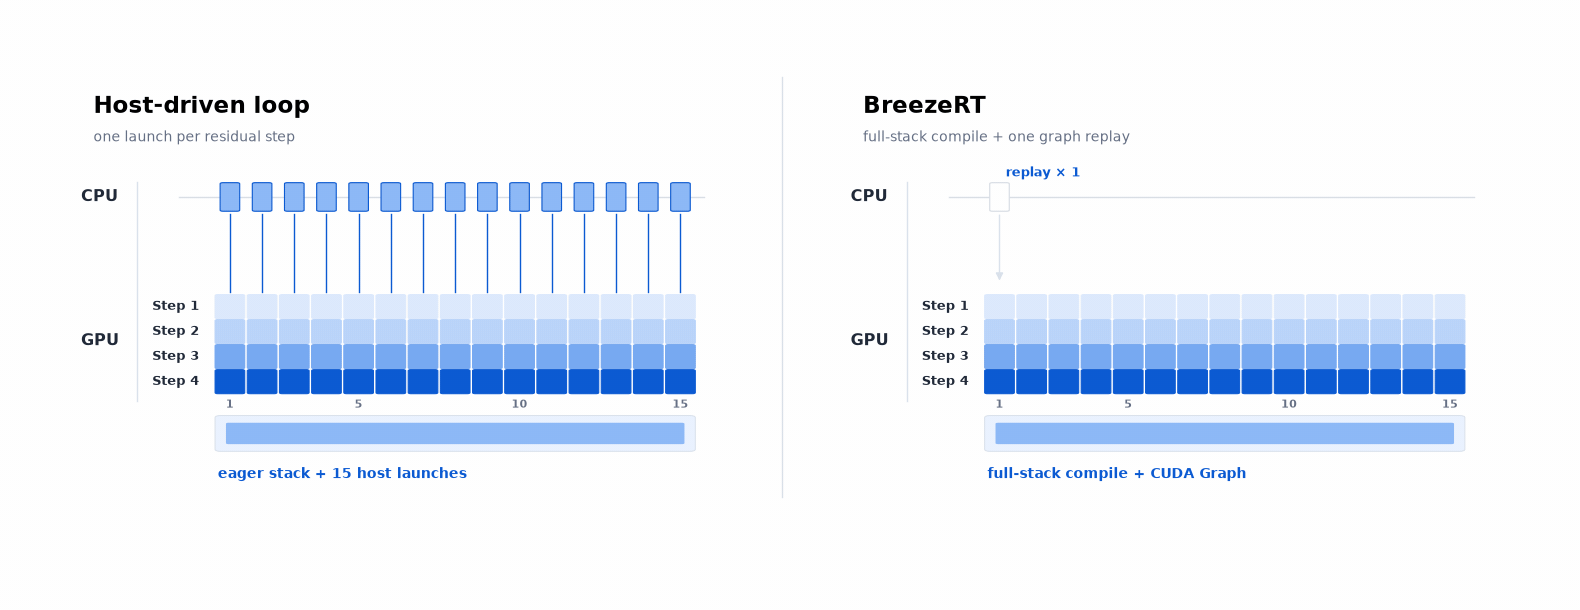
文本编码、Backbone、Depth 和音频解码都使用 Graph,常用形状在启动时预热。每个请求仍保留独立的采样参数和随机状态。在同一 16 路并发消融中,保持分块不变,首包延迟 p50 从 136 ms,经 Depth 编译降至 85 ms,再经全阶段抓图降至 38 ms。
4. Predictor:首音与播放期限调度
新请求等着开口,已有流等着下一块音频。只优先处理新请求,正在播放的语音可能断流;为已有流提前生成太多,又会让新请求排队。Predictor 根据播放期限决定先处理谁。
新请求优先启动。已有流的播放期限由首块输出时间和累计音频时长估算。Predictor 按批量大小记录各阶段近期耗时,并留出余量,判断剩余的 Backbone、Depth 和 Codec 工作能否按时完成。
例如,A 已经可以解码,B 再生成一步就能和 A 合批。如果合批能节省时间,且不会错过 A 的播放期限,调度器就等 B;否则先处理 A。如果来不及凑齐目标音频块,也可以先输出已生成的帧,避免播放器空等。
Predictor 只做轻量的耗时估计。在一组 300 请求的对照中,有潜在播放缺口的请求从 14 个减少到 0 个。按音频到达时间估算,未开启 Predictor 时,为避免播放中断,最差情况下需要先缓冲约 330 ms 的音频;在开启后的这轮复测中,首包到达后即可连续播放,无需额外等待。