BreezeRT mantiene baja la latencia del primer paquete de Breeze TTS 2 con alta concurrencia. Reducimos la espera en la planificación de solicitudes, la división del audio en fragmentos y la ejecución en GPU, y usamos Predictor para planificar el primer audio y los fragmentos siguientes. Las nuevas solicitudes comienzan rápidamente, mientras el habla en curso sigue reproduciéndose.
Resumen de optimizaciones de BreezeRT
| Optimización | Efecto |
|---|---|
| 1. Planificación unificada de múltiples etapas | Menos espera |
| 2. Fragmentación progresiva y decodificación incremental | TTFB de la primera solicitud: ~2500 → 150 ms |
| 3. Compilación de Depth y CUDA Graphs | TTFB de la primera solicitud: ~150 → 100 → 35 ms |
| 4. Predictor: plazos del primer audio y de reproducción | Solicitudes con posibles pausas de un total de 300: 14 → 0 |
Comparación de frameworks de inferencia
Todas las pruebas de este artículo se realizaron en H100. Comparamos PyTorch, vLLM-Omni, SGLang-Omni y BreezeRT con el mismo modelo Breeze TTS 2 y entre 1 y 16 solicitudes simultáneas, centrándonos en la latencia del primer paquete.
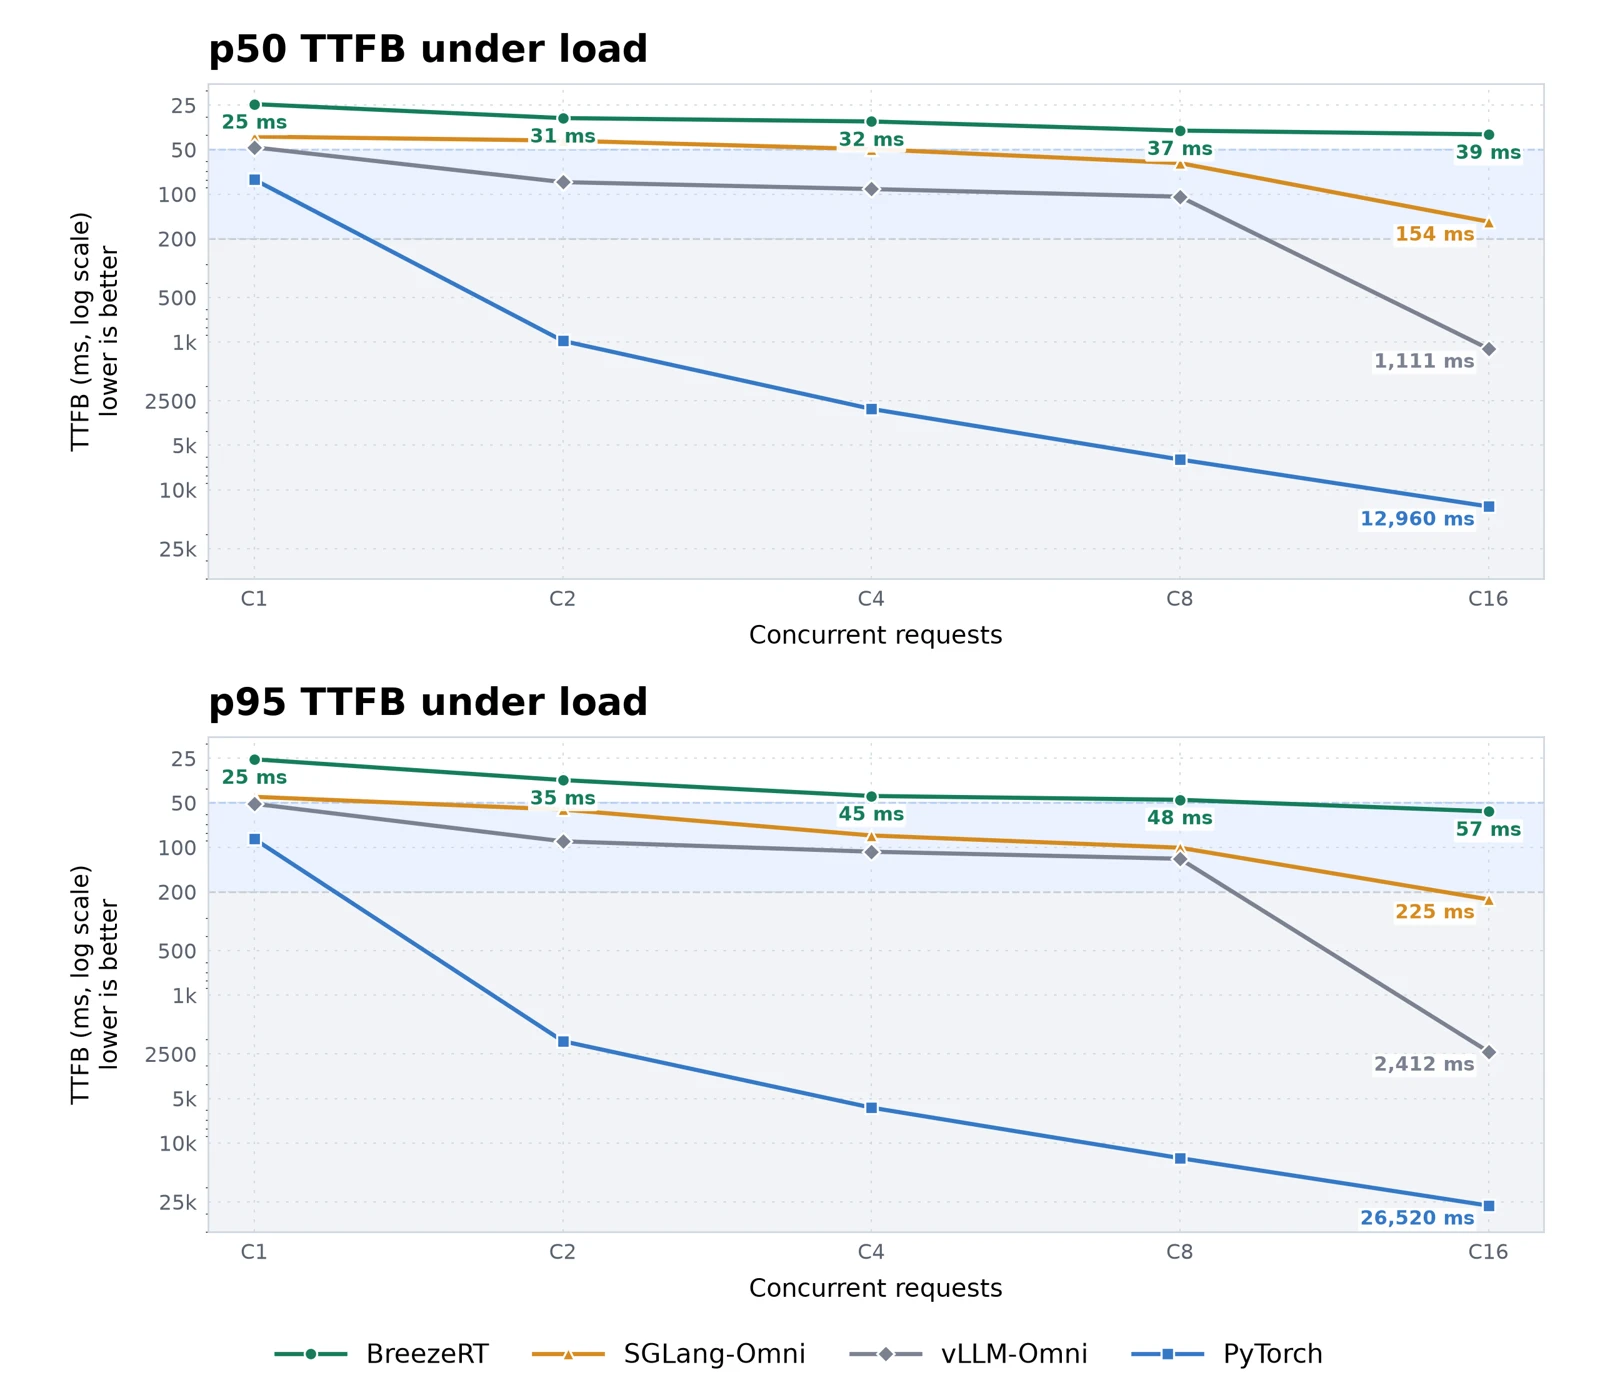
Adaptamos y ajustamos PyTorch, vLLM-Omni y SGLang-Omni para Breeze TTS 2. El gráfico muestra los mejores resultados que hemos medido con cada framework. Nuestras adaptaciones aún no se han integrado en sus repositorios de código abierto.
1. Planificación unificada de múltiples etapas
Breeze TTS 2 primero codifica el texto y ejecuta Backbone Prefill. Para cada trama de voz, Backbone predice el primer código de audio, Depth Decoder genera los 15 códigos restantes y Codec produce las muestras de la forma de onda. Cada etapa tiene distintos requisitos de cómputo, frecuencias de ejecución y tamaños de lote adecuados.
Las solicitudes simultáneas suelen encontrarse en etapas diferentes: A tiene códigos de audio listos para decodificar, B está generando su siguiente trama y C acaba de llegar y espera el primer audio. Continuar con A dejaría a B y C esperando. El planificador debe alternar entre solicitudes antes de que se complete una frase entera.
BreezeRT planifica por separado el procesamiento de texto, Backbone Prefill, Backbone Decode, Depth y la decodificación de audio. Un único entorno de ejecución gestiona el progreso de las solicitudes, las cachés y el audio pendiente. Después de cada etapa, elige qué etapa y qué solicitudes ejecutar a continuación.
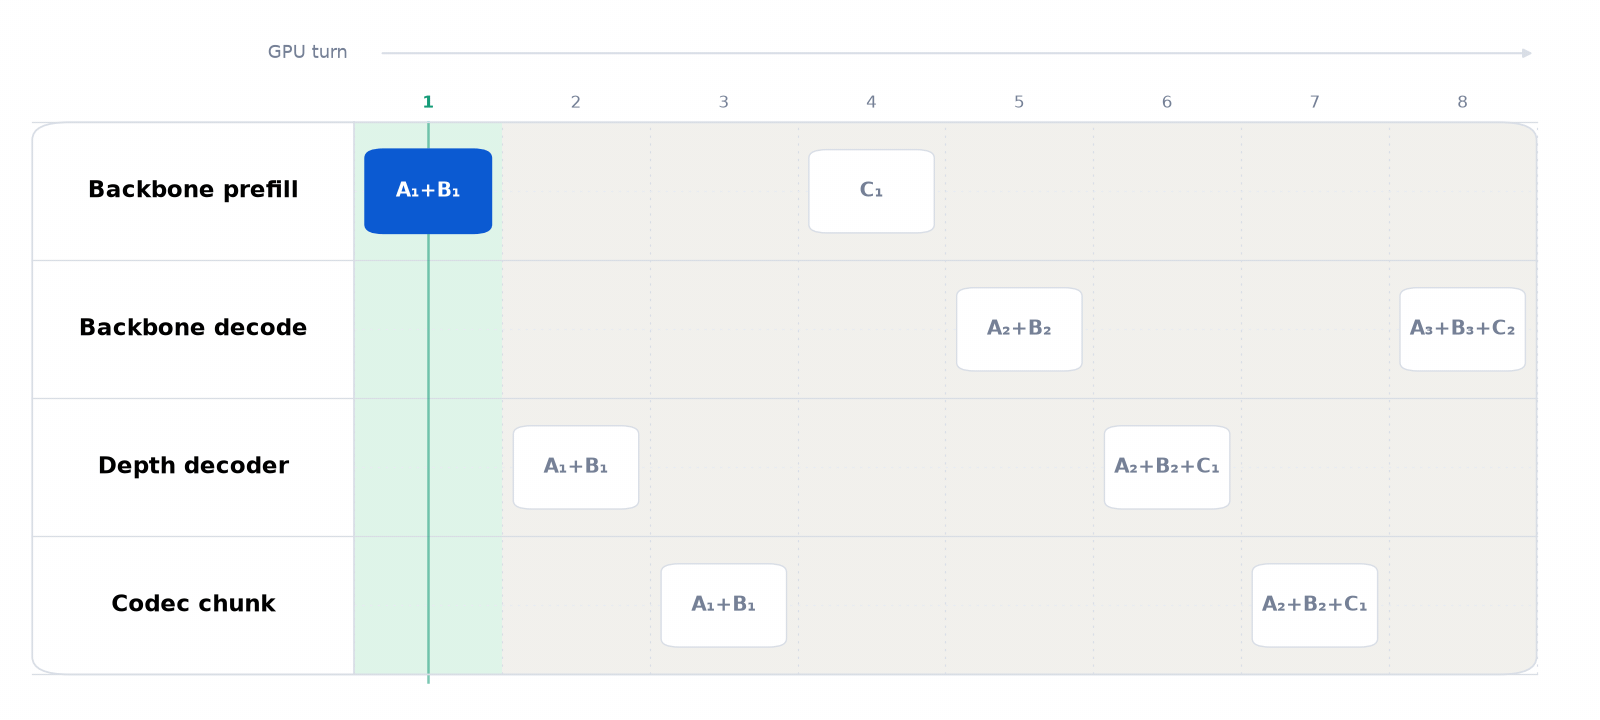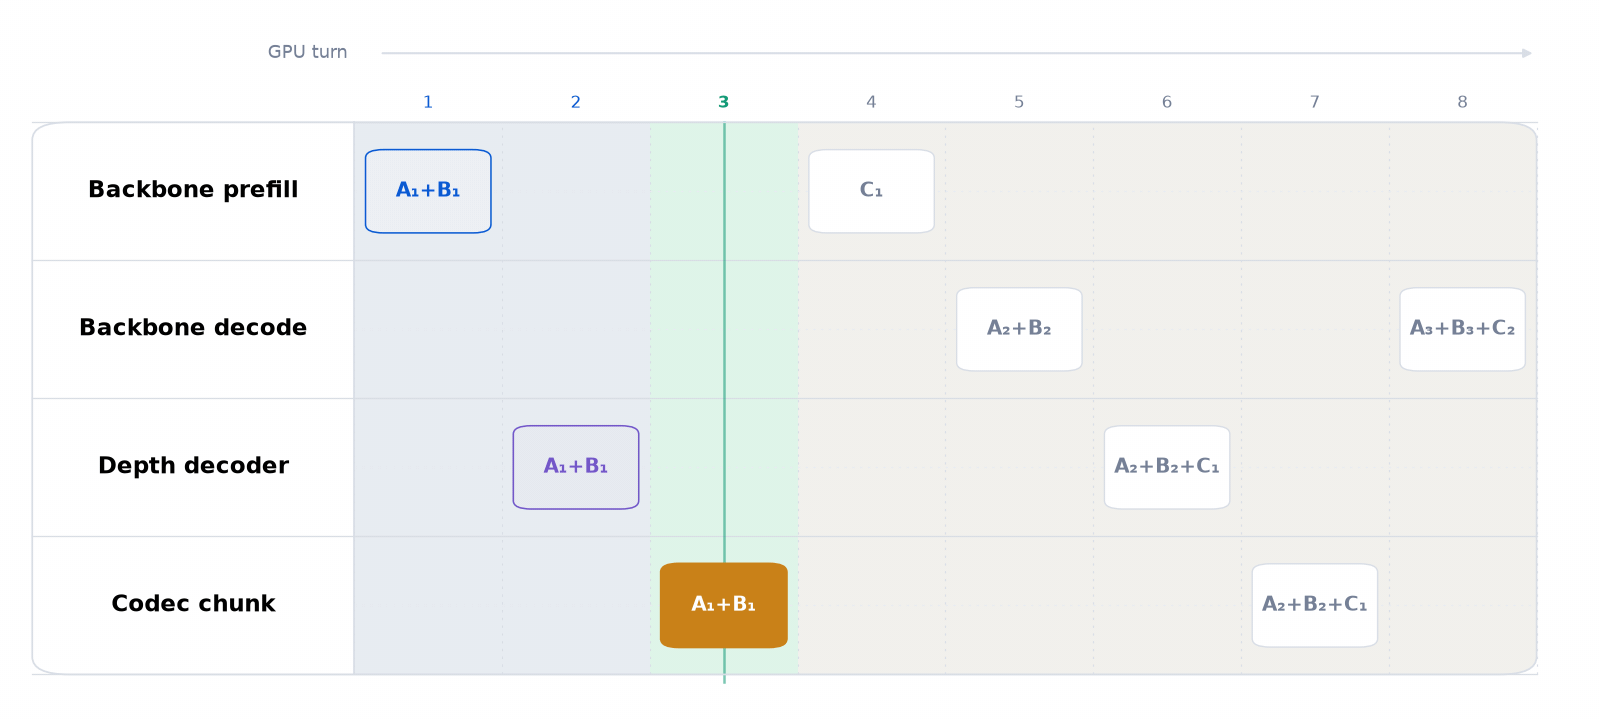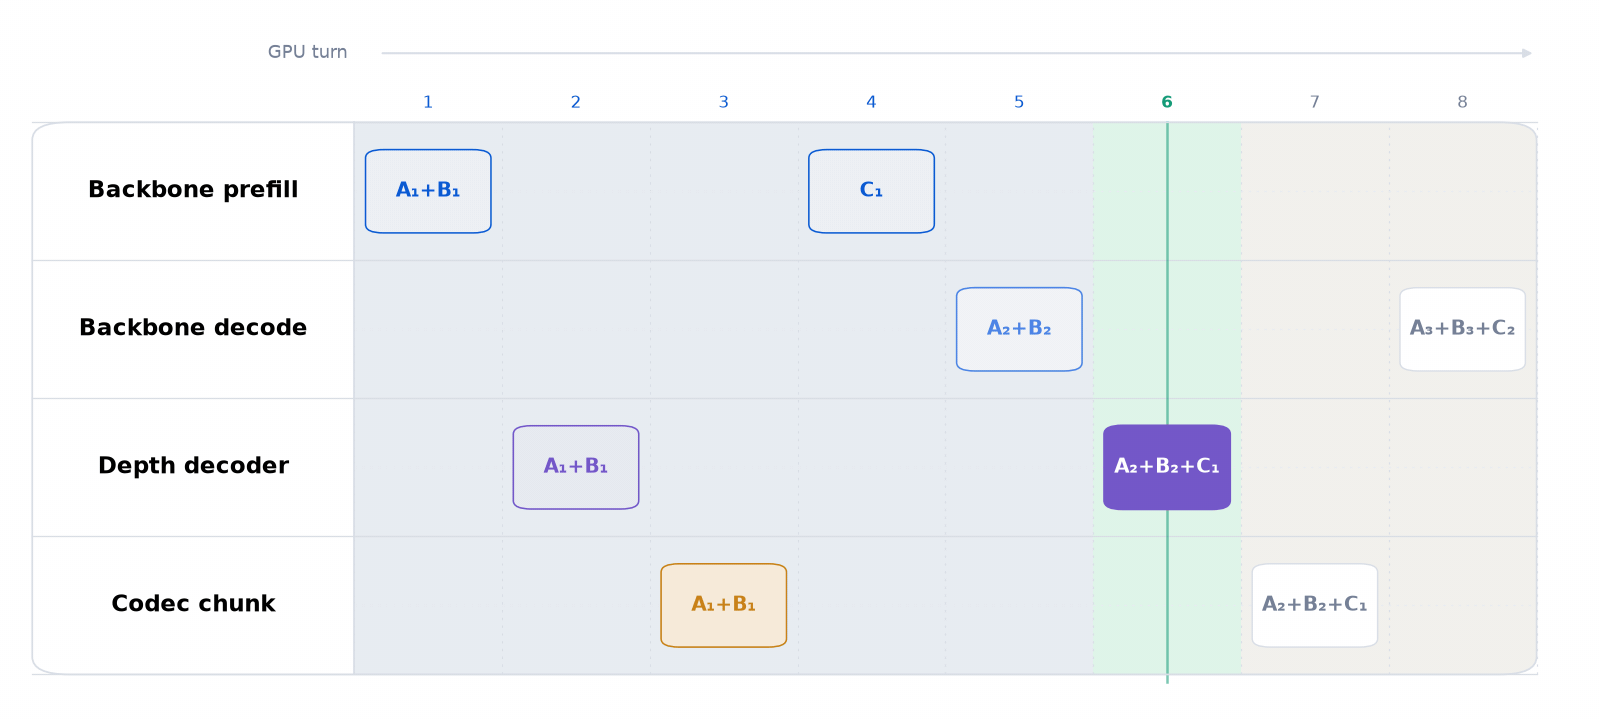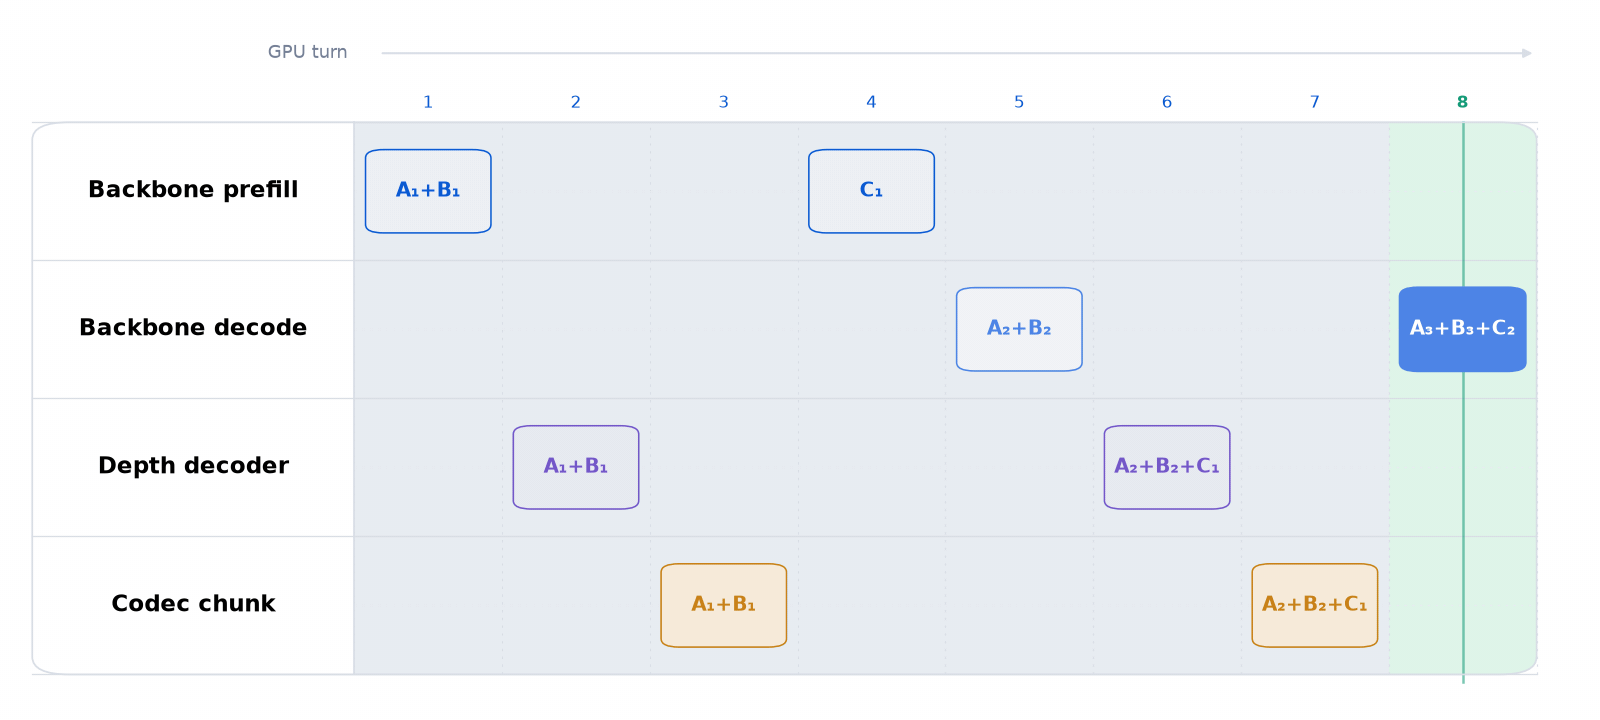
El planificador elige las solicitudes por prioridad y luego agrupa el trabajo en lotes dentro de la etapa seleccionada. Cada etapa tiene su propio límite de lote, por lo que Codec y Backbone pueden usar tamaños de lote diferentes. Las nuevas solicitudes pueden incorporarse entre etapas y los flujos activos disponen de tiempo para decodificarse. El mismo entorno de ejecución gestiona la fragmentación, la ejecución de grafos capturados y la planificación basada en plazos.
2. Fragmentación progresiva y decodificación incremental
Un primer fragmento más grande obliga al usuario a esperar más tramas antes de escuchar audio. Sin embargo, enviar una trama cada vez implica ejecutar Codec y el planificador con más frecuencia. Esa sobrecarga se acumula a medida que aumentan las solicitudes.
BreezeRT aumenta gradualmente el tamaño de los fragmentos, usando, por ejemplo, 1, 2, 4, 8 y 16 tramas. Los fragmentos pequeños permiten iniciar la reproducción rápidamente. Una vez que hay algo de audio en el búfer, los fragmentos más grandes reducen el número de llamadas de decodificación.
Codec también necesita recordar el trabajo anterior para no volver a decodificar el mismo audio. BreezeRT almacena, para cada solicitud, los KV del Transformer con ventana deslizante, el historial de convolución causal y la cola de solapamiento de convolución transpuesta, y procesa únicamente las tramas nuevas. Estas cachés conservan el contexto y suavizan los límites entre fragmentos cuando cambia su tamaño.
En la comparación de apoyo, la primera solicitud recibió audio después de aproximadamente 2500 ms con un primer fragmento fijo de 16 tramas y de unos 150 ms con fragmentos progresivos.
3. Compilación de Depth y CUDA Graphs
Con un primer fragmento más pequeño, la sobrecarga de lanzamiento desde la CPU se hace más visible. Generar una trama de voz requiere muchas operaciones del modelo. Incluso una GPU rápida puede quedar inactiva entre envíos. BreezeRT reduce la sobrecarga de cómputo mediante compilación y utiliza CUDA Graphs para enviar las operaciones de GPU capturadas en una sola ejecución del grafo.
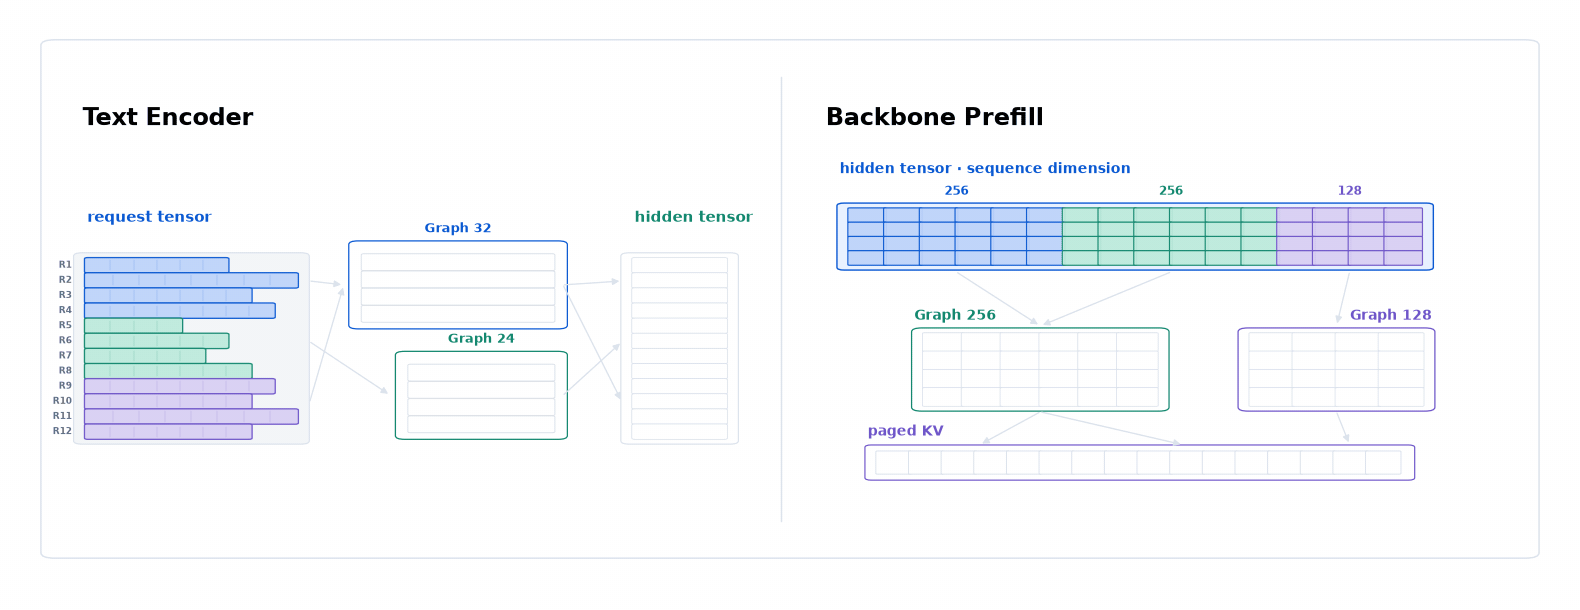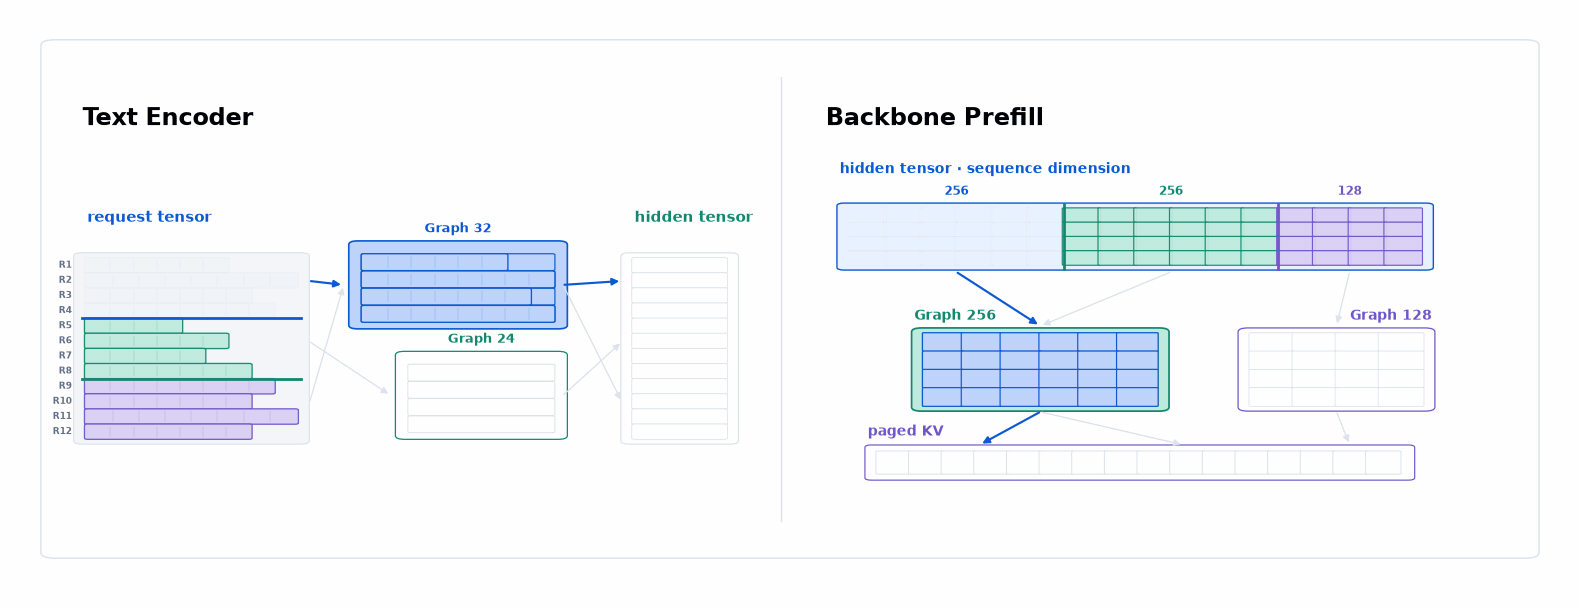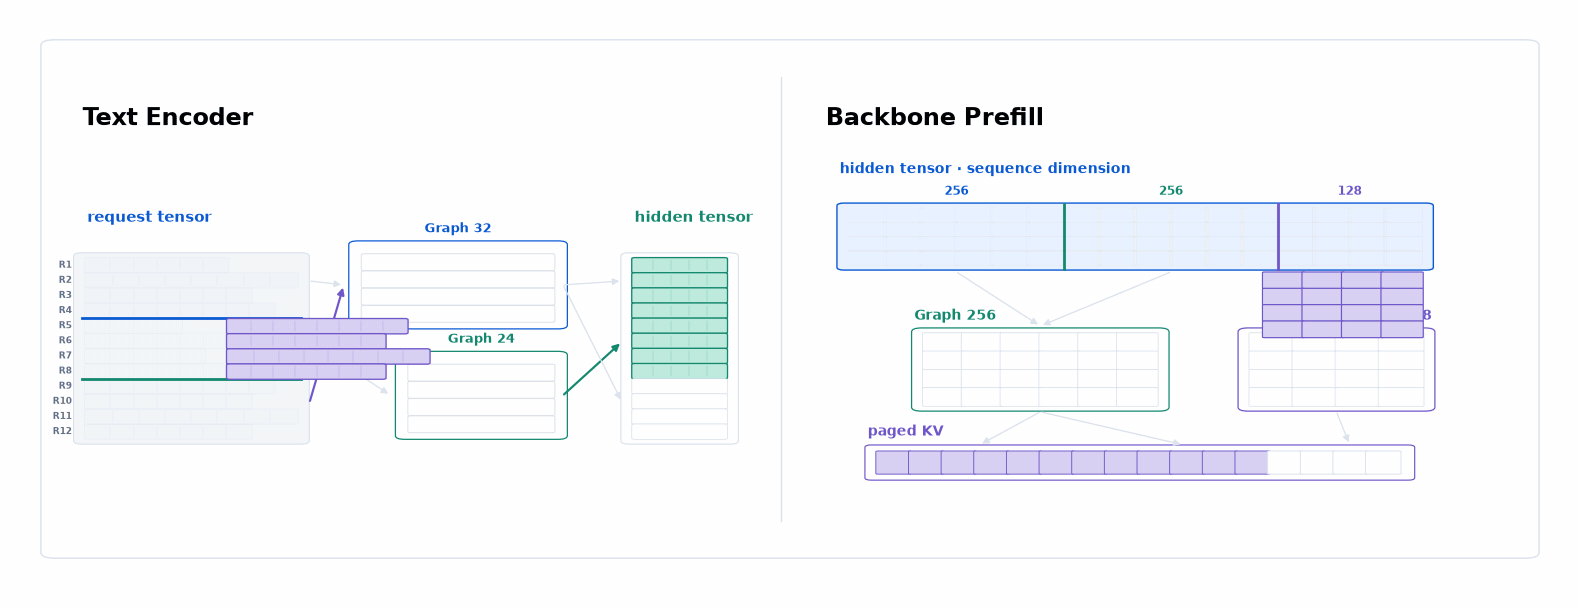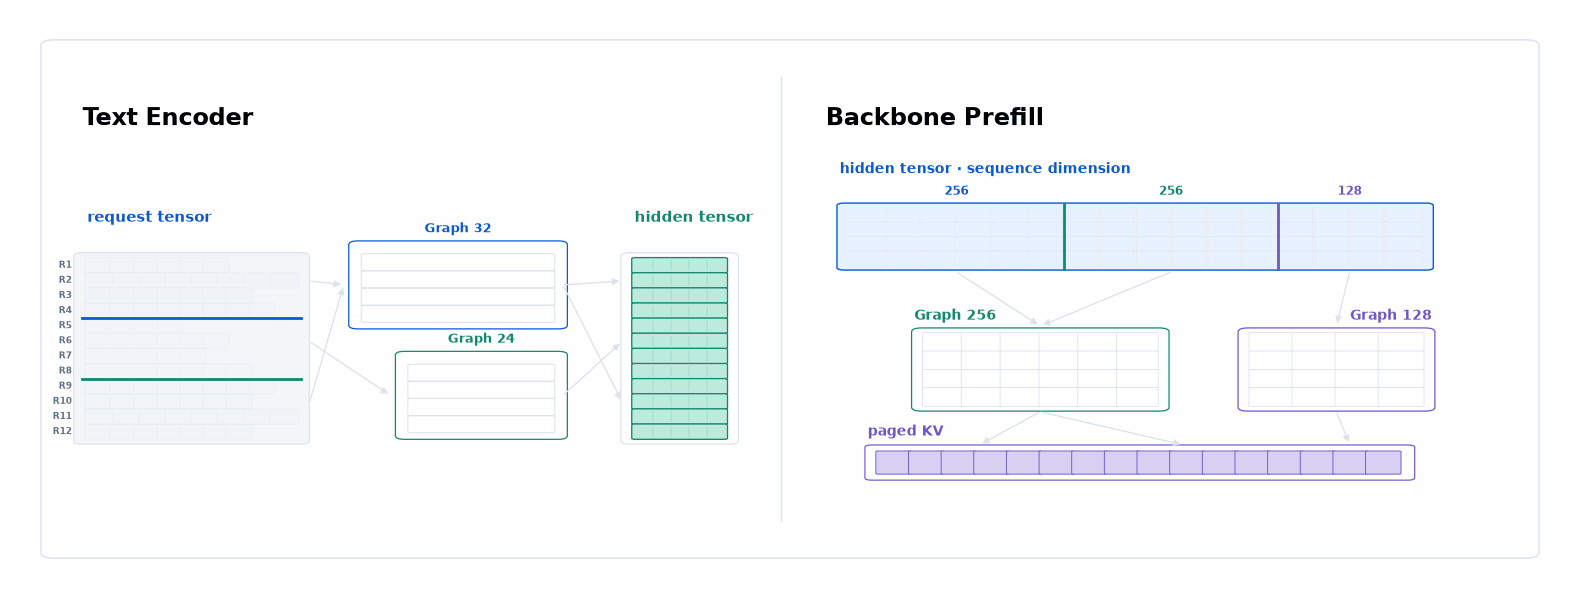
La ejecución de CUDA Graphs requiere formas de tensor fijas, pero las longitudes de texto, los tamaños de lote y los tamaños de fragmento de audio varían. Capturar todas las combinaciones consumiría demasiada memoria. BreezeRT mantiene un conjunto de formas comunes y divide o rellena las entradas para ajustarlas.
Text Encoder empaqueta tokens y divide el trabajo según el número de solicitudes y la capacidad de tokens para reducir el relleno. La atención permanece separada para cada solicitud. Backbone Prefill trabaja en fragmentos de tokens, con KV paginados que almacenan el historial de generación de cada solicitud para reutilizar los grafos y búferes existentes.
Depth Decoder genera 15 códigos de audio adicionales por trama. BreezeRT compila la pila del decodificador y las cabezas de salida como unidades completas, fusionando operaciones compatibles elemento a elemento en menos kernels. Esto reduce las lecturas y escrituras de tensores intermedios y los lanzamientos de kernels, un trabajo repetitivo que se acumula entre solicitudes simultáneas. Los búferes de KV, posición y entrada/salida se asignan de antemano. El bucle autorregresivo completo se captura en un solo grafo, de modo que una ejecución recorre los 15 pasos en orden de dependencia.
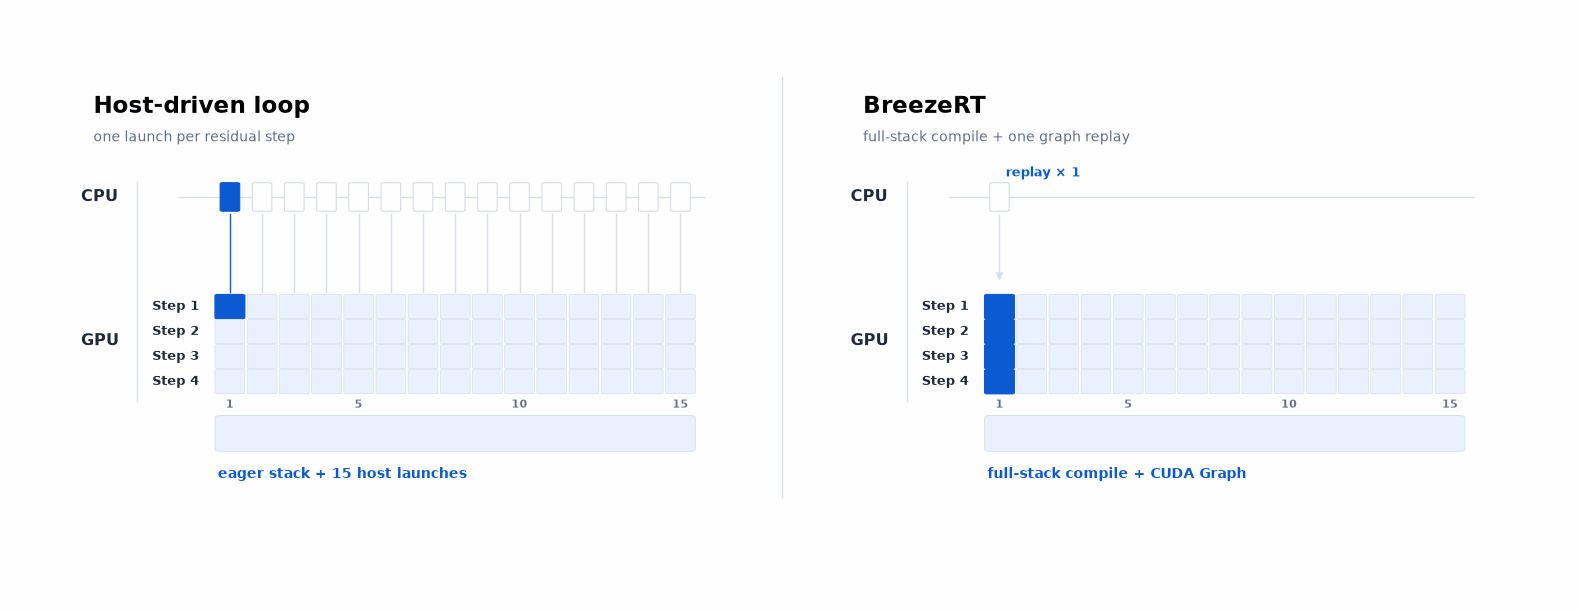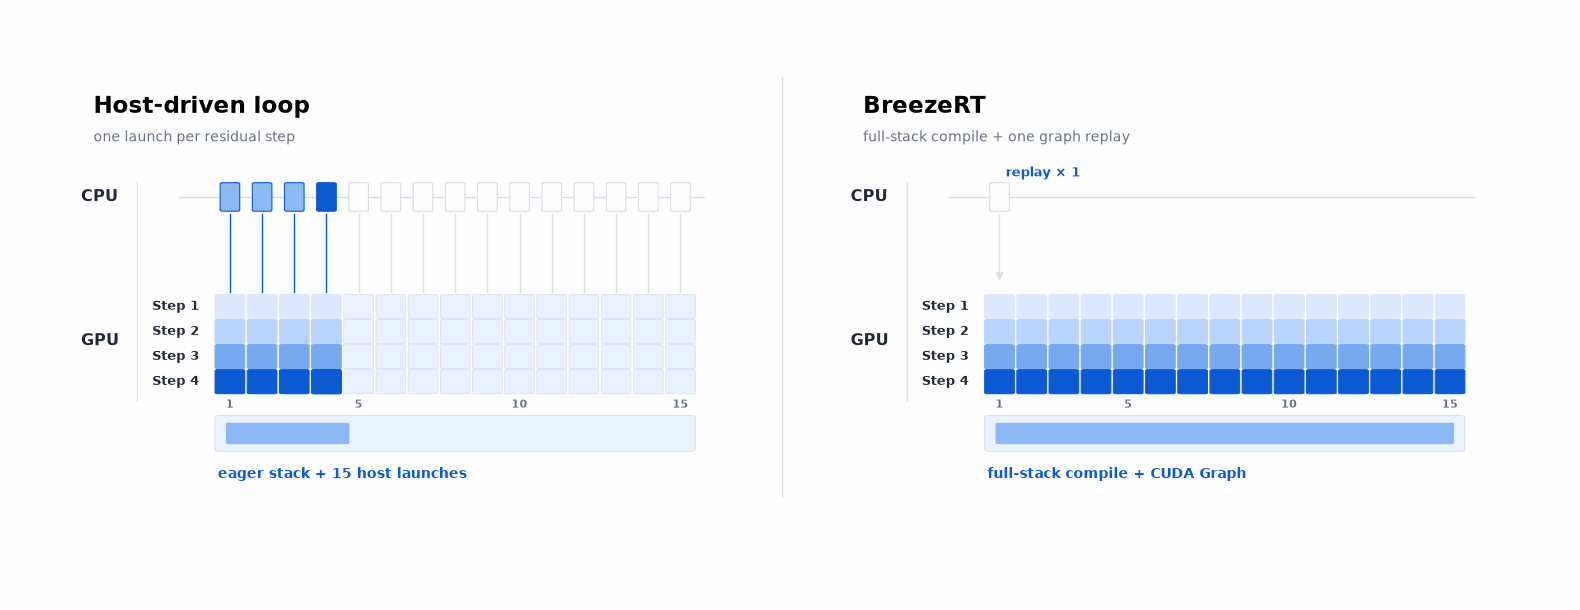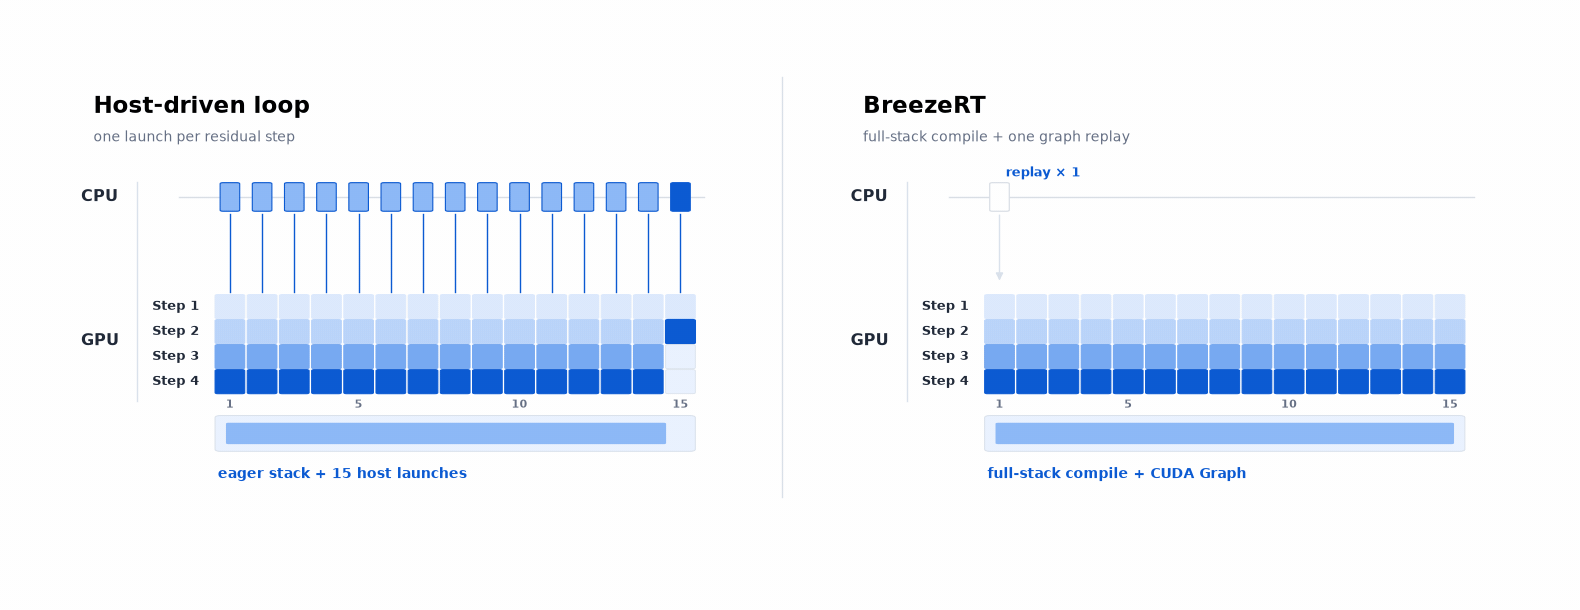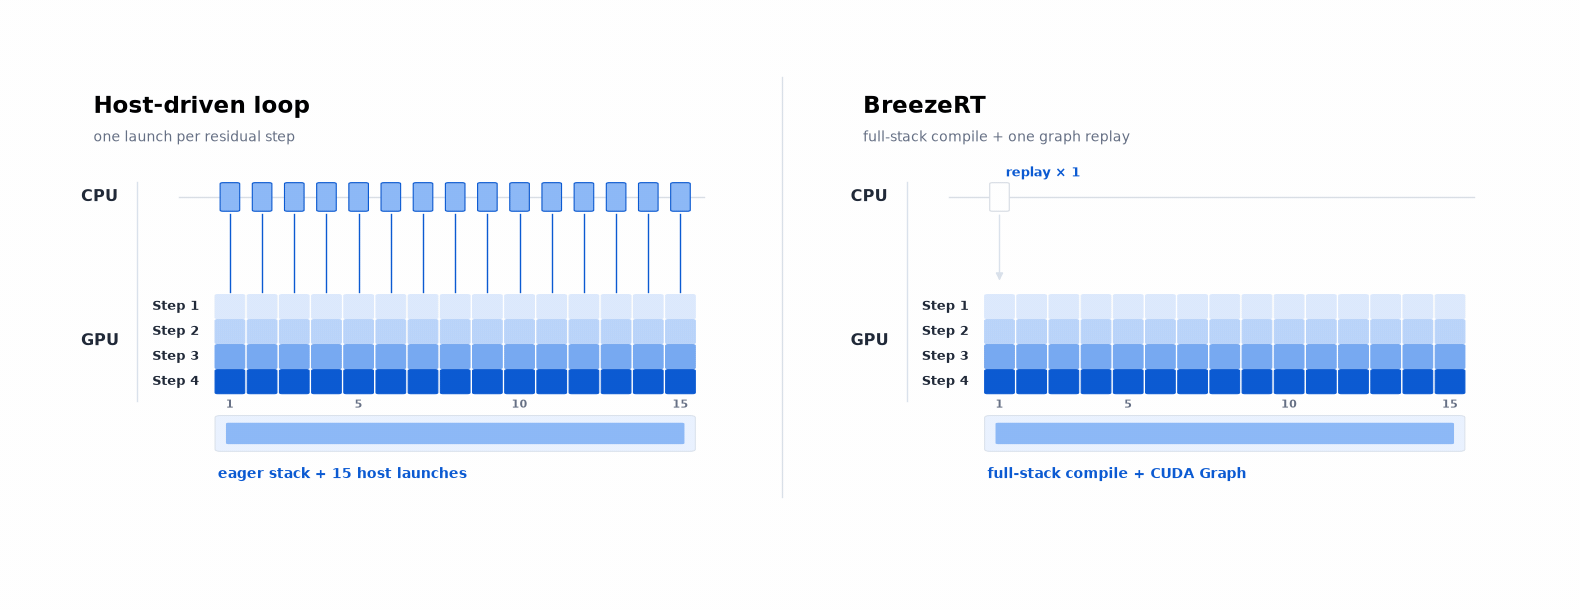
La codificación de texto, Backbone, Depth y la decodificación de audio utilizan grafos, con las formas comunes precalentadas al inicio. Cada solicitud conserva su propia configuración de muestreo y estado aleatorio. Sin cambiar la fragmentación, la comparación de apoyo midió una latencia de la primera solicitud de unos 150 ms, que bajó a 100 ms con la compilación de Depth y a 35 ms con grafos en todas las etapas.
4. Predictor: plazos del primer audio y de reproducción
Las nuevas solicitudes esperan empezar a hablar; los flujos activos esperan su siguiente fragmento. Atender siempre primero las nuevas solicitudes puede interrumpir la reproducción. Generar con demasiada antelación para los flujos activos hace esperar a las nuevas solicitudes. Predictor utiliza los plazos de reproducción para decidir qué trabajo va primero.
Las nuevas solicitudes reciben prioridad de inicio. Para los flujos activos, el momento de la primera salida y la duración total del audio permiten estimar un plazo de reproducción. Predictor registra los tiempos recientes de cada etapa por tamaño de lote y deja un margen al estimar si el trabajo restante de Backbone, Depth y Codec puede terminar a tiempo.
Por ejemplo, A está lista para decodificarse, mientras que B necesita un paso más de generación para incorporarse a su lote. El planificador espera a B si agruparlas ahorra tiempo y sigue cumpliendo el plazo de reproducción de A. De lo contrario, A se ejecuta primero. Si el fragmento previsto no puede completarse a tiempo, el entorno de ejecución puede enviar las tramas ya generadas para evitar que el reproductor se quede esperando.
Predictor utiliza una estimación de tiempos ligera. En una comparación con 300 solicitudes, las solicitudes con posibles pausas de reproducción bajaron de 14 a 0. El búfer adicional máximo necesario para evitar una pausa se redujo de unos 330 ms a 0 ms.