BreezeRT hält die Latenz bis zum ersten Paket für Breeze TTS 2 auch bei vielen gleichzeitigen Anfragen niedrig. Wir reduzieren Wartezeiten bei der Anfrageplanung, der Aufteilung des Audios in Chunks und der GPU-Ausführung. Anschließend plant Predictor das erste Audio und die folgenden Chunks. Neue Anfragen starten schnell, während laufende Sprachausgaben weiter abgespielt werden.
BreezeRT-Optimierungen im Überblick
| Optimierung | Wirkung |
|---|---|
| 1. Einheitliche Planung über mehrere Stufen | Weniger Wartezeit |
| 2. Progressive Chunks und inkrementelle Dekodierung | C16 TTFB p50: 1626 → 136 ms |
| 3. Depth-Kompilierung und CUDA Graphs | C16 TTFB p50: 136 → 85 → 38 ms |
| 4. Predictor: Fristen für erstes Audio und Wiedergabe | Anfragen mit möglichen Wiedergabelücken von 300: 14 → 0 |
Vergleich der Inferenz-Frameworks
Alle Tests in diesem Artikel wurden auf einer einzelnen H100-GPU durchgeführt. PyTorch, vLLM-Omni und SGLang-Omni haben wir mit den originalen test-en-Texten von Seed-TTS ohne Referenzaudio erneut getestet. Das Diagramm vergleicht diese Implementierungen mit BreezeRT, jeweils mit demselben Modell Breeze TTS 2 bei 1–16 gleichzeitigen Anfragen. Bei 16 gleichzeitigen Anfragen erreicht BreezeRT eine Latenz bis zum ersten Paket von 38 / 52 ms bei p50 / p95.
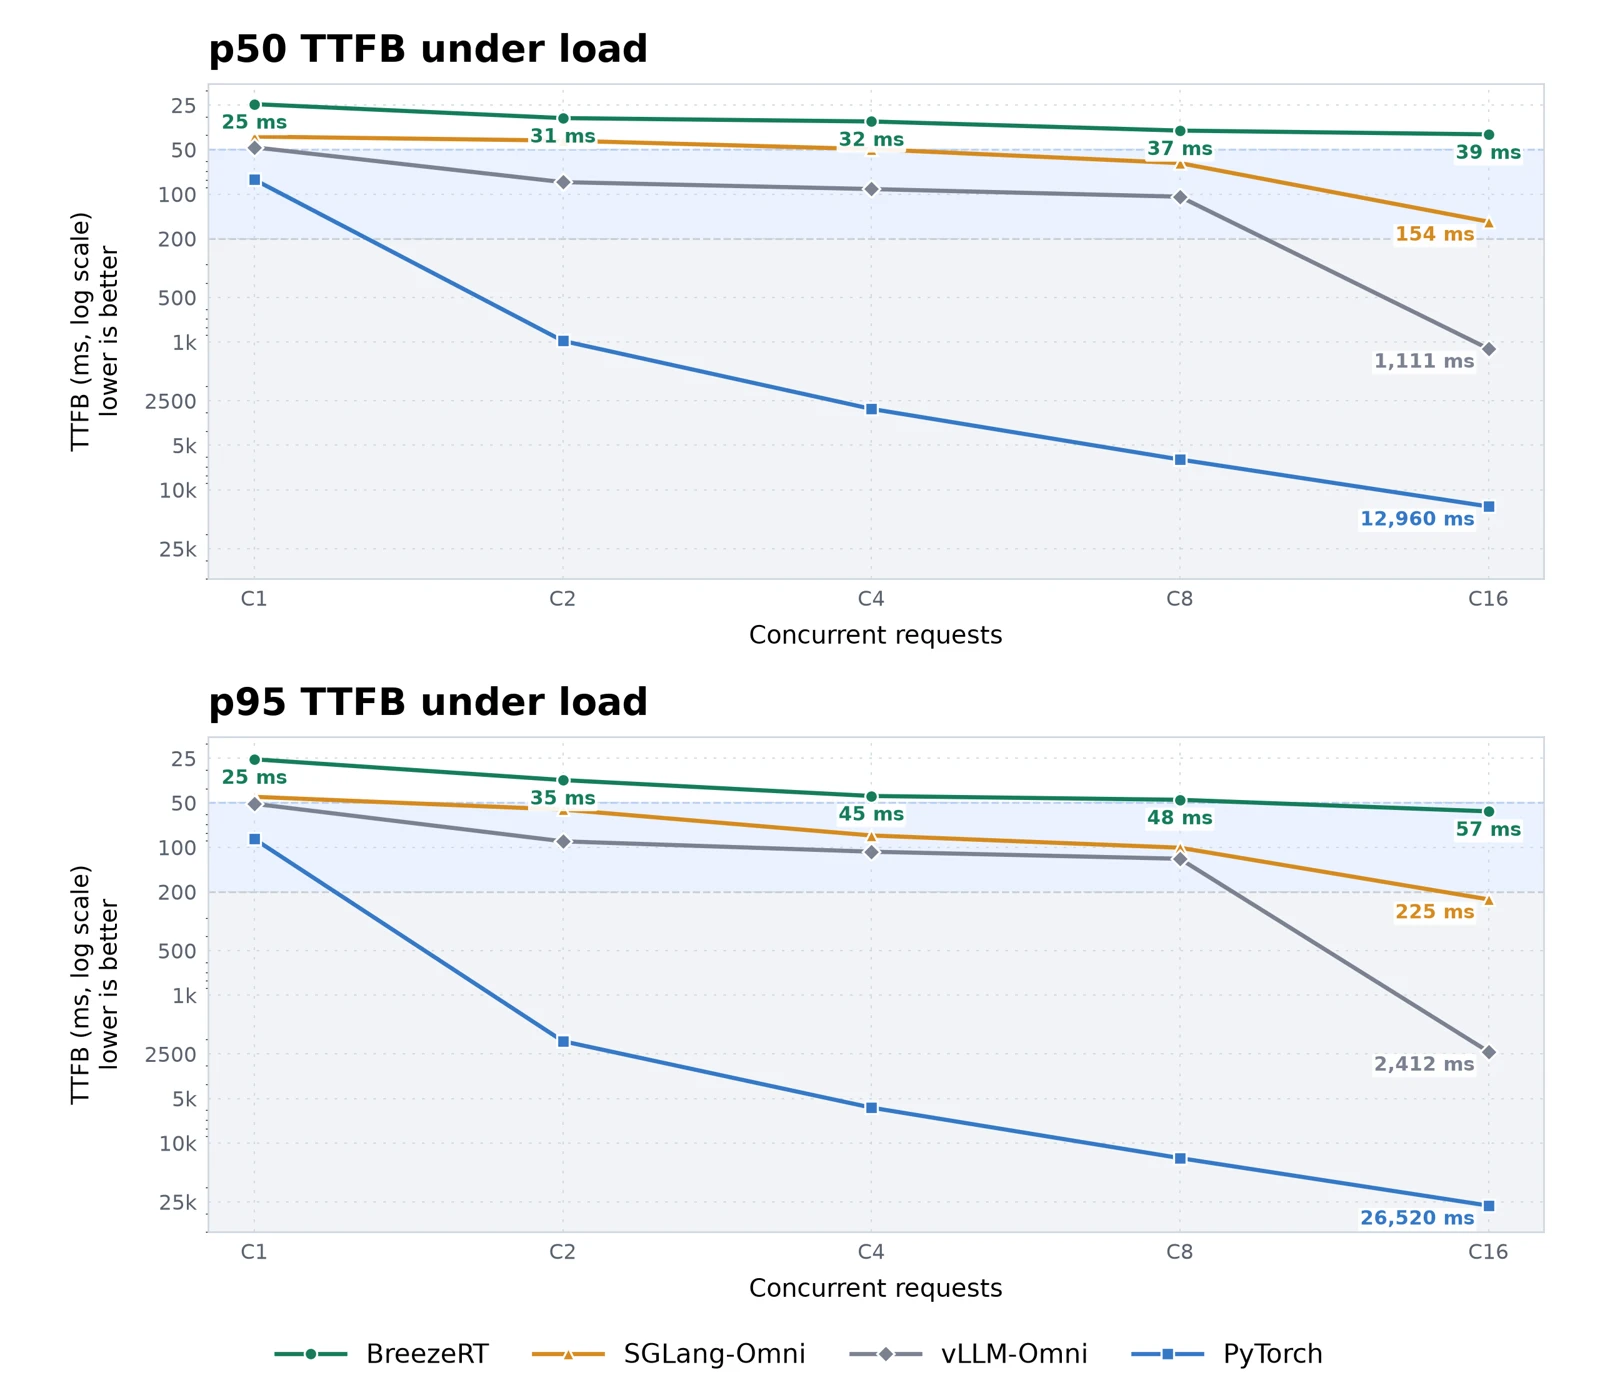
Wir haben PyTorch, vLLM-Omni und SGLang-Omni für Breeze TTS 2 angepasst und optimiert. Das Diagramm zeigt die Latenz bis zum ersten Paket für diese Implementierungen. Unsere Anpassungen wurden noch nicht in deren Open-Source-Repositories übernommen.
Die vier Optimierungen von BreezeRT
1. Einheitliche Planung über mehrere Stufen
Breeze TTS 2 kodiert zunächst den Text und führt Backbone Prefill aus. Für jeden Sprachframe sagt der Backbone den ersten Audiocode voraus, der Depth Decoder erzeugt die verbleibenden 15 Codes und der Codec erzeugt Wellenform-Samples. Jede Stufe hat andere Rechenanforderungen, Ausführungshäufigkeiten und geeignete Batch-Größen.
Gleichzeitige Anfragen befinden sich häufig in unterschiedlichen Stufen: Für A liegen Audiocodes zum Dekodieren bereit, B erzeugt den nächsten Frame und C ist gerade eingegangen und wartet auf das erste Audio. Würde A weiterlaufen, müssten B und C warten. Der Scheduler muss zwischen Anfragen wechseln, bevor ein vollständiger Satz fertig ist.
BreezeRT plant Textverarbeitung, Backbone Prefill, Backbone Decode, Depth und Audiodekodierung getrennt. Eine einzige Laufzeitumgebung verwaltet den Fortschritt der Anfragen, Caches und ausstehendes Audio. Nach jeder Stufe entscheidet sie, welche Stufe und welche Anfragen als Nächstes ausgeführt werden.
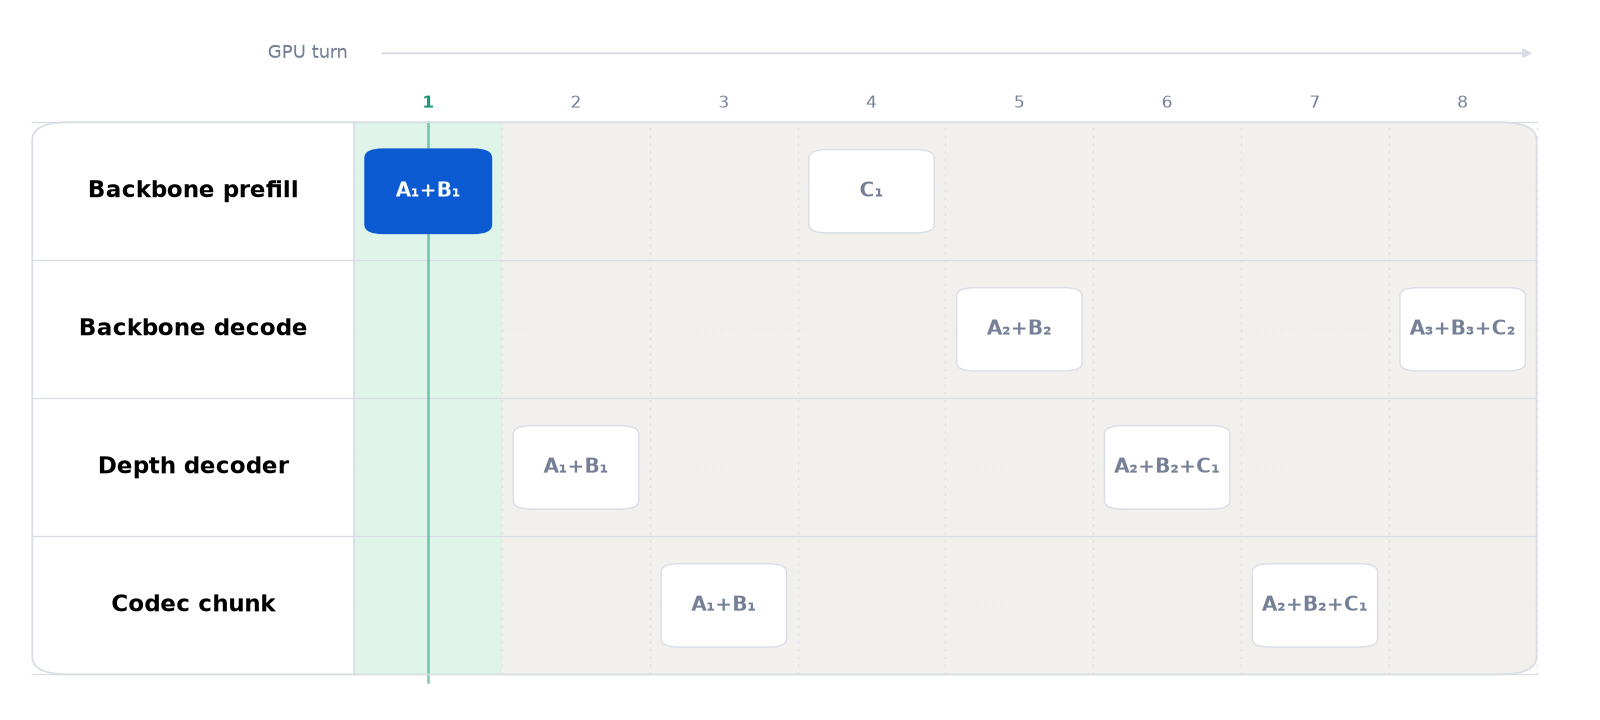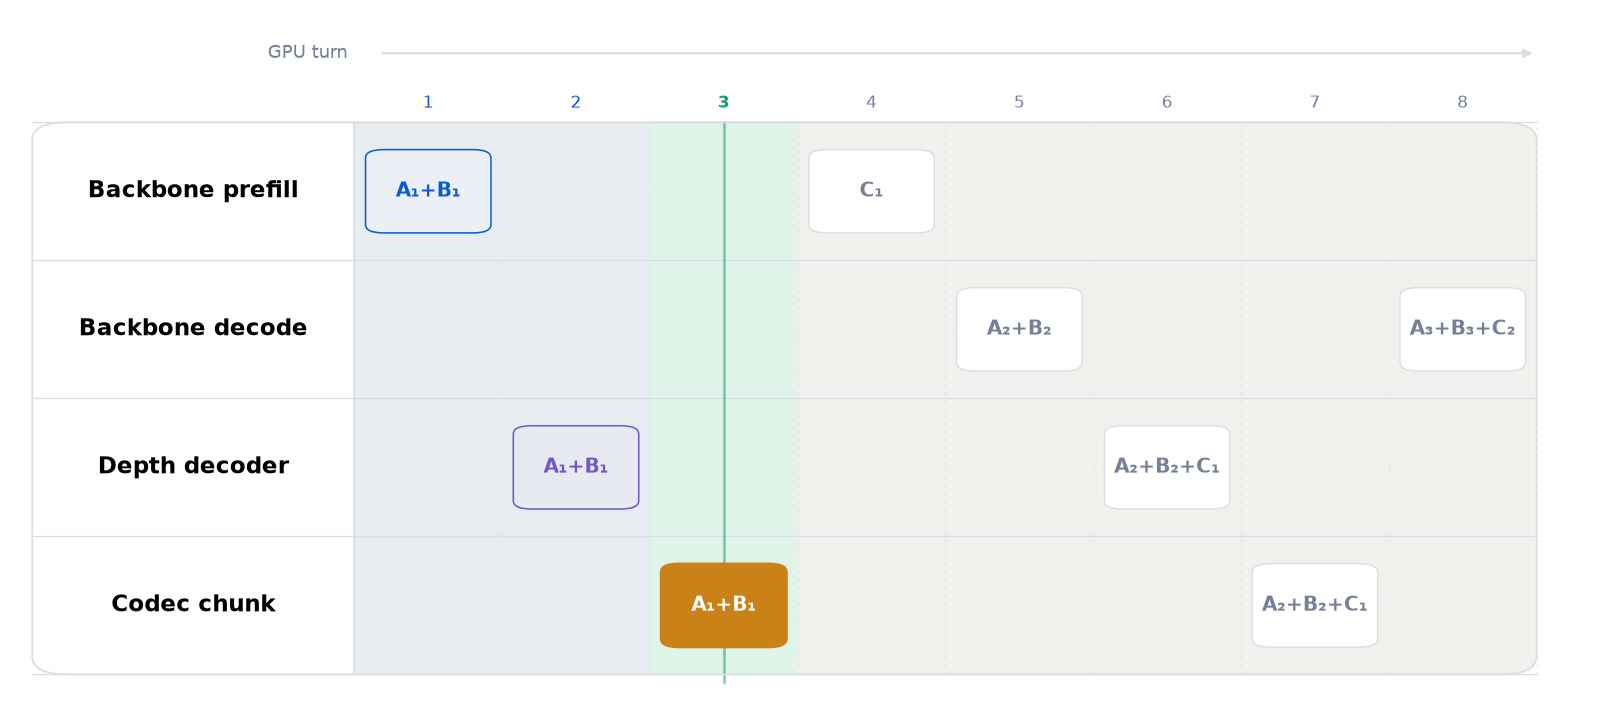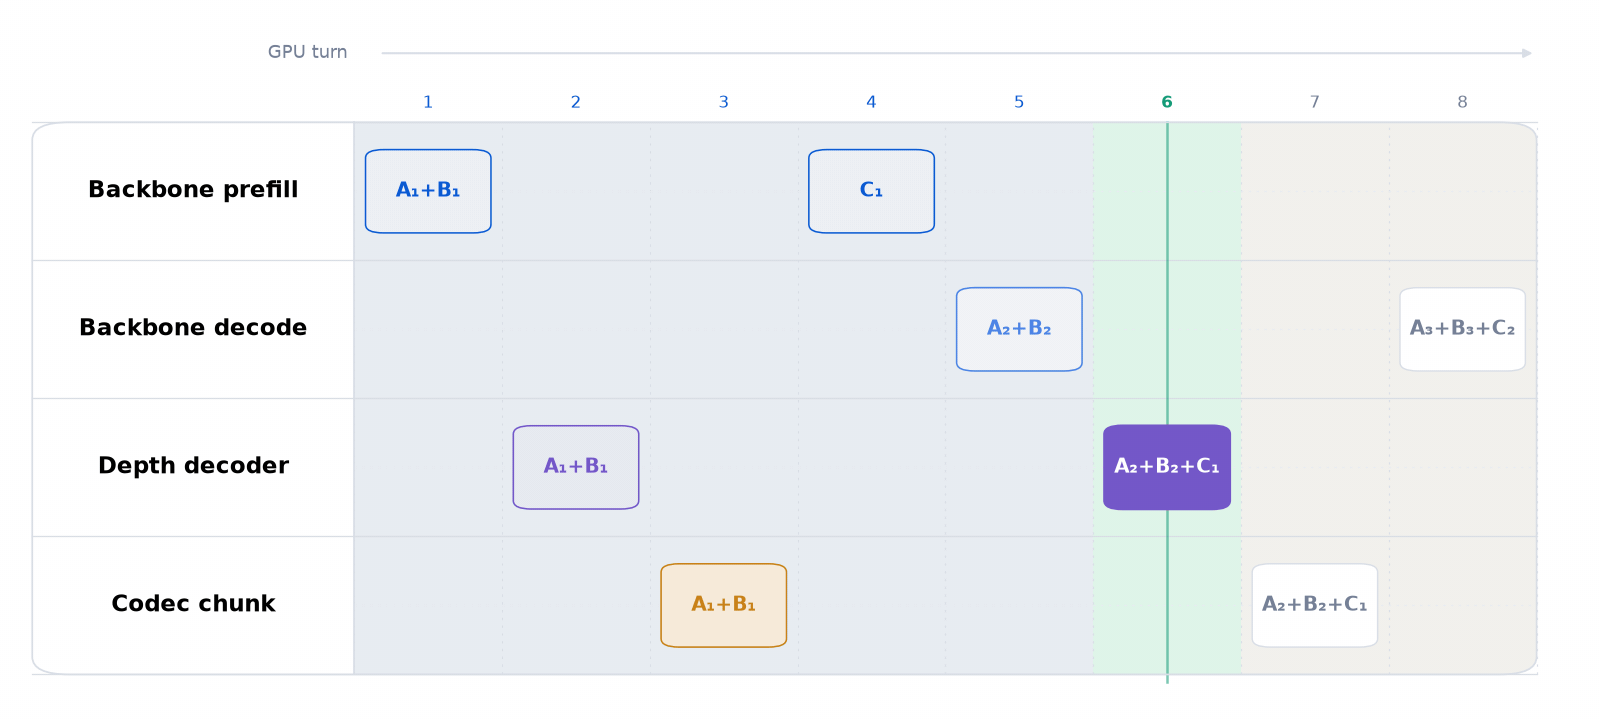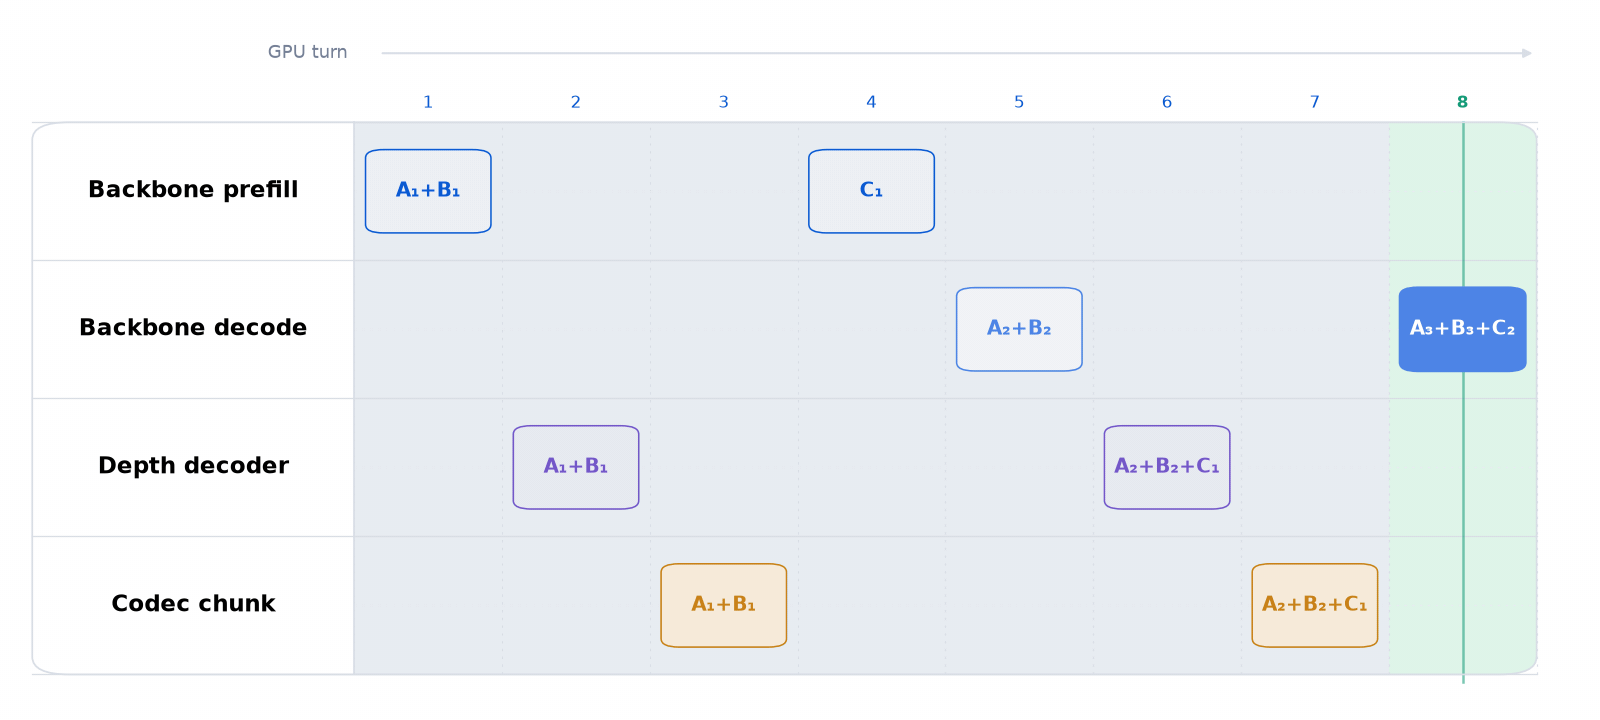
Der Scheduler wählt Anfragen nach Priorität aus und bündelt dann die Arbeit innerhalb der gewählten Stufe in Batches. Jede Stufe hat eine eigene Batch-Grenze, sodass Codec und Backbone unterschiedliche Batch-Größen verwenden können. Neue Anfragen können zwischen den Stufen hinzukommen, und aktive Streams erhalten Zeit zum Dekodieren. Dieselbe Laufzeitumgebung übernimmt Chunking, Graph-Replay und die Planung anhand von Fristen.
2. Progressive Chunks und inkrementelle Dekodierung
Bei einem größeren ersten Chunk muss der Nutzer auf mehr Frames warten, bevor Audio hörbar wird. Wird dagegen jeweils nur ein Frame gesendet, müssen Codec und Scheduler häufiger ausgeführt werden. Dieser Mehraufwand summiert sich mit zunehmender Zahl von Anfragen.
BreezeRT vergrößert die Chunks schrittweise, beispielsweise auf 1, 2, 4, 8 und 16 Frames. Kleine Chunks ermöglichen einen schnellen Wiedergabestart. Sobald etwas Audio gepuffert ist, reduzieren größere Chunks die Anzahl der Dekodierungsaufrufe.
Auch der Codec muss sich bisherige Arbeit merken, damit er dasselbe Audio nicht erneut dekodiert. BreezeRT speichert für jede Anfrage die KV-Zustände des Sliding-Window-Transformers, den Verlauf der kausalen Faltung und den überlappenden Endbereich der transponierten Faltung. Anschließend verarbeitet es nur neue Frames. Diese Caches bewahren den Kontext und sorgen auch bei wechselnden Chunk-Größen für nahtlose Übergänge.
Die Ablation läuft auf einer einzelnen H100-GPU bei 16 gleichzeitigen Anfragen und misst die p50-Latenz bis zum ersten Paket über 300 Anfragen pro Konfiguration. Ein fester erster Chunk von 16 Frames ergibt 1626 ms; progressive Chunks senken den Wert auf 136 ms.
3. Depth-Kompilierung und CUDA Graphs
Bei einem kleineren ersten Chunk fällt der CPU-Aufwand für das Starten der Operationen stärker auf. Die Erzeugung eines Sprachframes benötigt viele Modelloperationen. Selbst eine schnelle GPU kann zwischen den Übermittlungen untätig bleiben. BreezeRT verringert den Rechenaufwand durch Kompilierung und übermittelt mit CUDA Graphs aufgezeichnete GPU-Operationen in einem einzigen Replay.
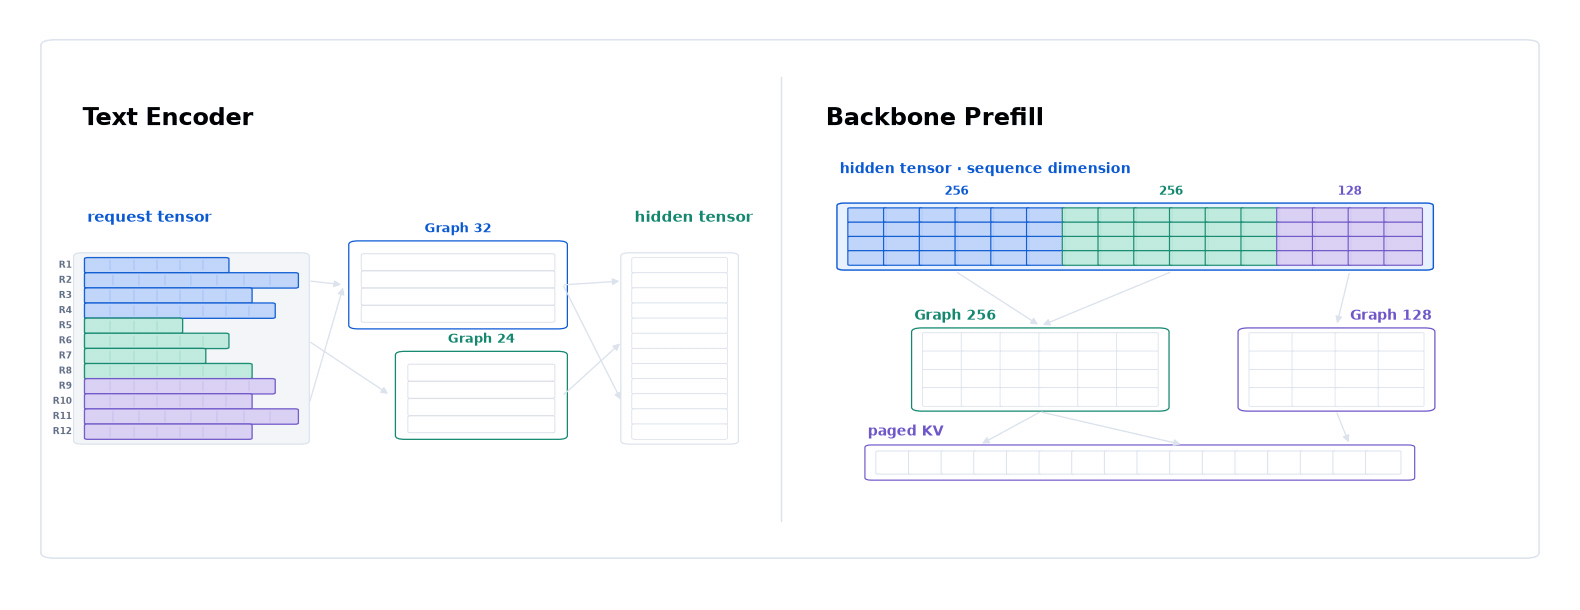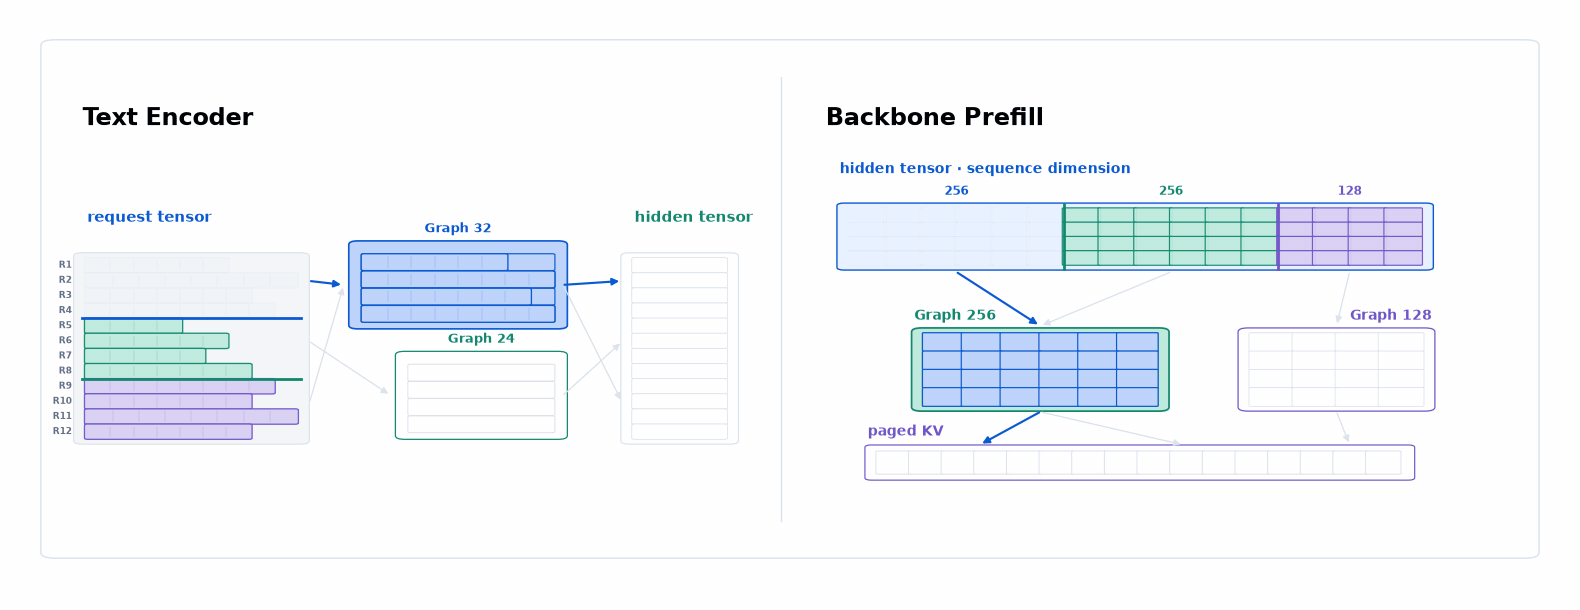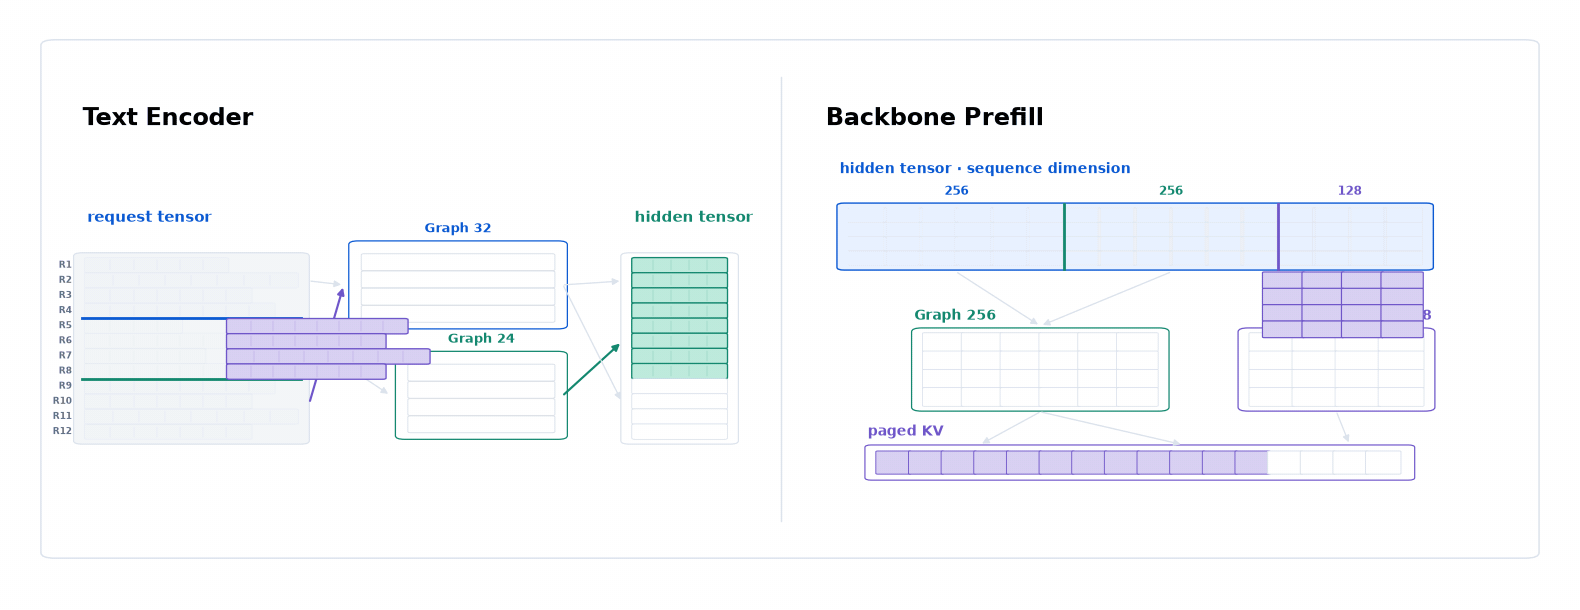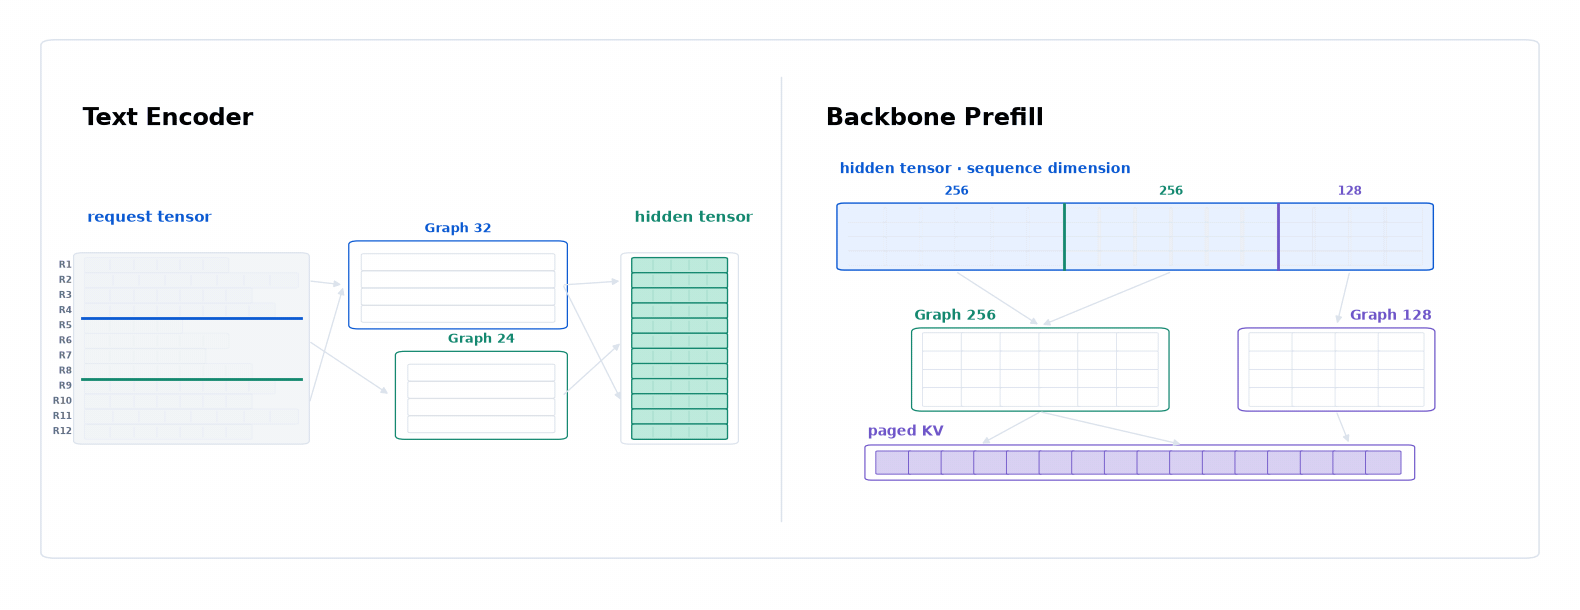
CUDA Graph-Replay erfordert feste Tensorformen, doch Textlängen, Batch-Größen und Audio-Chunk-Größen variieren. Jede Kombination aufzuzeichnen würde zu viel Speicher benötigen. BreezeRT hält einen Satz gängiger Formen vor und teilt Eingaben auf oder füllt sie auf, damit sie hineinpassen.
Der Text Encoder packt Tokens zusammen und teilt die Arbeit nach Anfragezahl und Token-Kapazität auf, um Padding zu reduzieren. Attention bleibt für jede Anfrage getrennt. Backbone Prefill arbeitet in Token-Chunks. Paged KV speichert dabei den Generierungsverlauf jeder Anfrage, sodass vorhandene Graphen und Puffer wiederverwendet werden können.
Der Depth Decoder erzeugt pro Frame 15 weitere Audiocodes. BreezeRT kompiliert den Decoder-Stack und die Ausgabeköpfe jeweils als ganze Einheiten und fasst kompatible elementweise Operationen in weniger Kernels zusammen. Das reduziert Lese- und Schreibzugriffe auf Zwischentensoren sowie Kernel-Starts – wiederkehrende Arbeit, die sich bei gleichzeitigen Anfragen summiert. KV-, Positions- und Ein-/Ausgabepuffer werden vorab reserviert. Die gesamte autoregressive Schleife wird in einem Graphen aufgezeichnet, sodass ein einziges Replay alle 15 Schritte in der Reihenfolge ihrer Abhängigkeiten ausführt.
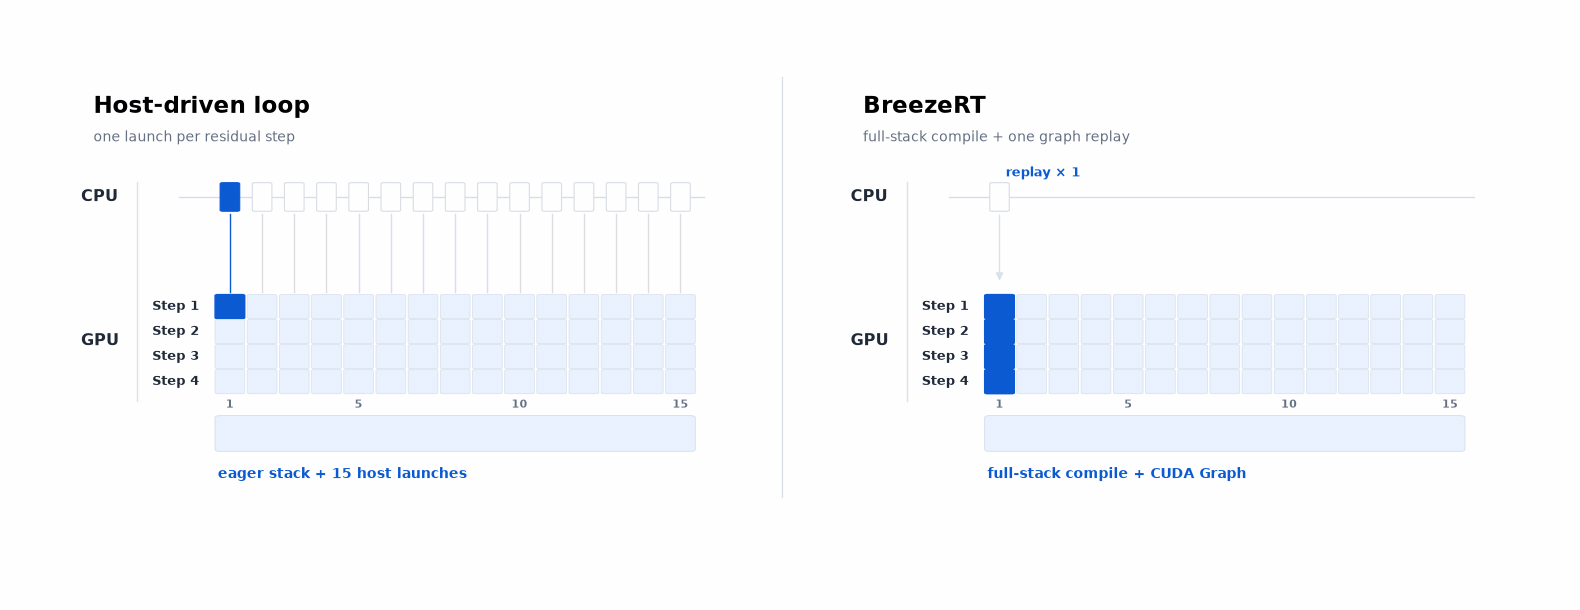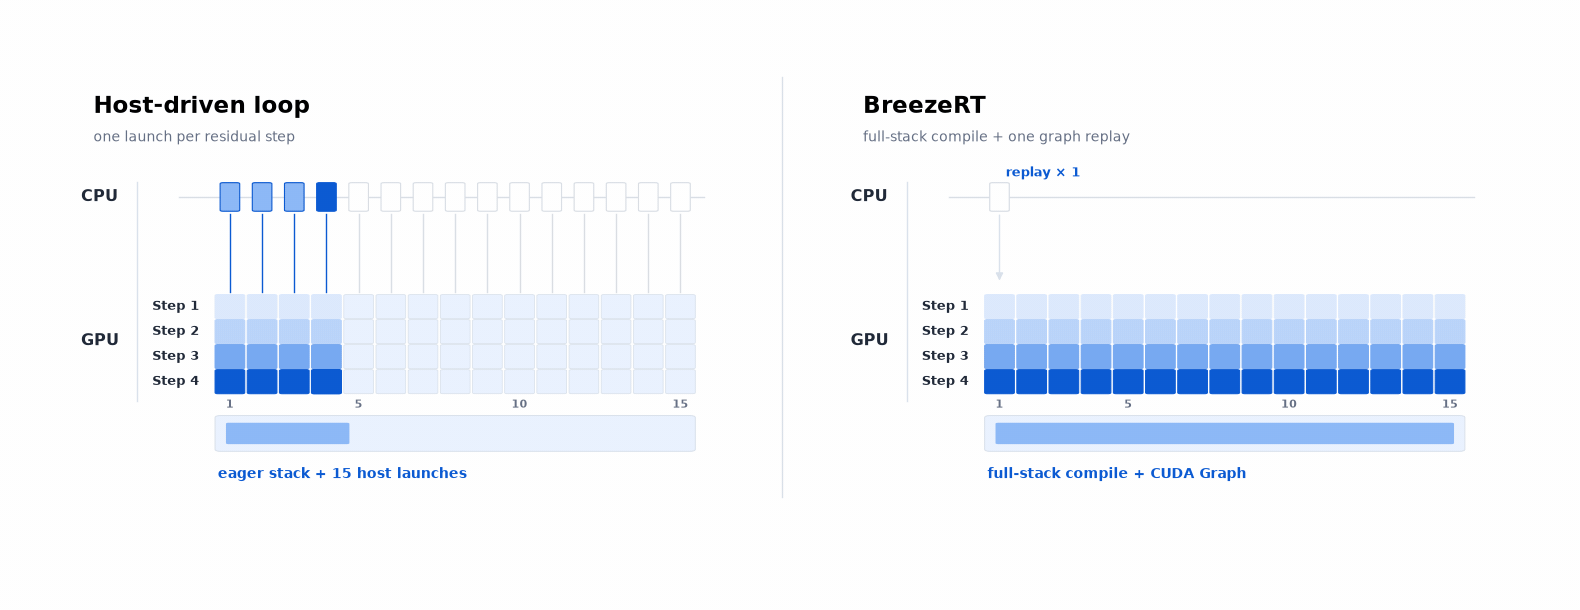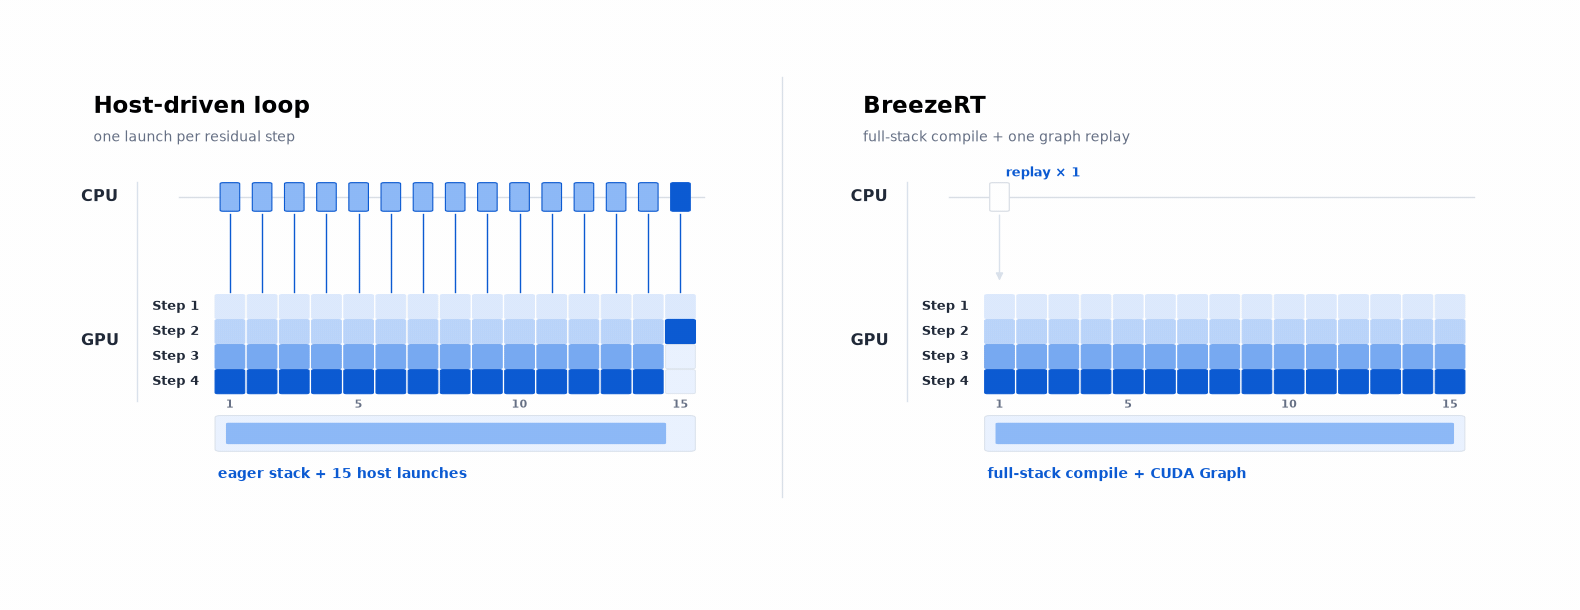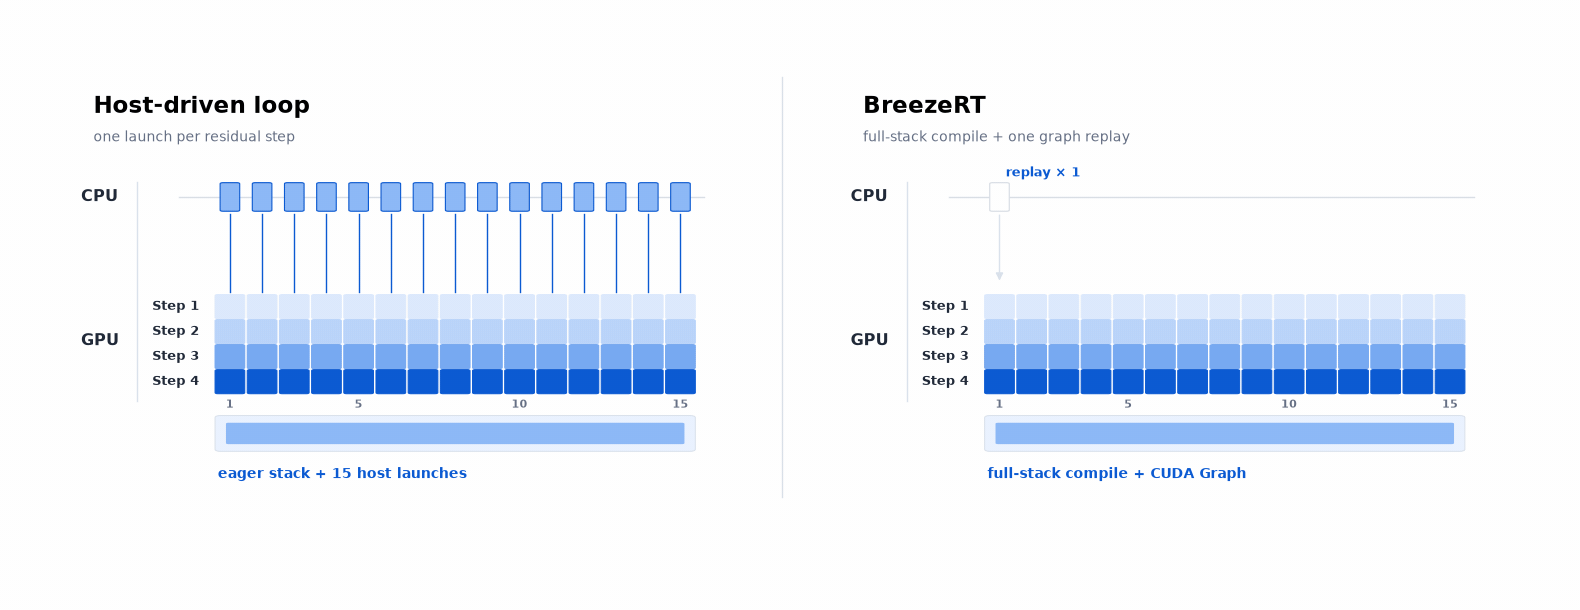
Textkodierung, Backbone, Depth und Audiodekodierung verwenden alle Graphen. Gängige Formen werden beim Start aufgewärmt. Jede Anfrage behält ihre eigenen Sampling-Einstellungen und ihren Zufallszustand. In derselben C16-Ablation sinkt die p50-Latenz bis zum ersten Paket bei unverändertem Chunking von 136 ms auf 85 ms mit Depth-Kompilierung und auf 38 ms mit Graphen in allen Stufen.
4. Predictor: Fristen für erstes Audio und Wiedergabe
Neue Anfragen warten darauf, mit dem Sprechen zu beginnen; aktive Streams warten auf ihren nächsten Chunk. Werden neue Anfragen stets zuerst bedient, kann die Wiedergabe unterbrochen werden. Wird für aktive Streams zu weit vorausgeneriert, müssen neue Anfragen warten. Predictor entscheidet anhand von Wiedergabefristen, welche Arbeit Vorrang hat.
Neue Anfragen erhalten beim Start Priorität. Bei aktiven Streams ergeben der Zeitpunkt der ersten Ausgabe und die gesamte Audiodauer eine geschätzte Wiedergabefrist. Predictor erfasst die jüngsten Stufenlaufzeiten nach Batch-Größe und berücksichtigt einen Puffer, wenn es abschätzt, ob die verbleibende Arbeit in Backbone, Depth und Codec rechtzeitig fertig wird.
Beispielsweise ist A zum Dekodieren bereit, während B noch einen Generierungsschritt benötigt, um in denselben Batch aufgenommen zu werden. Der Scheduler wartet auf B, wenn das Batching Zeit spart und die Wiedergabefrist von A trotzdem eingehalten wird. Andernfalls wird A zuerst ausgeführt. Wenn der Ziel-Chunk nicht rechtzeitig fertig werden kann, kann die Laufzeitumgebung die bereits erzeugten Frames senden, statt den Player warten zu lassen.
Predictor verwendet eine leichtgewichtige Zeitschätzung. In einem Vergleich mit 300 Anfragen sank die Zahl der Anfragen mit möglichen Wiedergabelücken von 14 auf 0. Anhand der Ankunftszeiten der Audiopakete müsste die Wiedergabe ohne Predictor im schlimmsten Fall etwa 330 ms zusätzliches Audio vorab puffern, um Unterbrechungen zu vermeiden. Im Wiederholungslauf mit aktiviertem Predictor konnte die Wiedergabe mit dem ersten Paket beginnen und ohne zusätzliches Warten fortlaufen.